约 1.4 亿个网站拦截最多的 AI 爬虫
爬虫抓取网站有成本,搜索引擎与网站所有者之间又存在一种社会契约。本文基于约 1.4 亿个网站的数据,梳理过去一年 AI 爬虫拦截率的变化与成因。
AI 爬虫驱动着我们今天使用的许多最先进技术,从搜索引擎到 AI 助手。然而,它们日益增多的存在,导致越来越多的网站开始拦截它们。
爬虫抓取网站是有成本的,而且搜索引擎与网站所有者之间存在一种社会契约:搜索引擎通过向网站输送引荐流量来创造价值。正是这一点让大多数网站没有拦截 Google 等搜索引擎,即便 Google 似乎铁了心要把更多这类流量据为己有。这种社会契约同样延伸到了生成式引擎。
当我们审视 Ahrefs Analytics 中约 3.5 万个网站的流量构成时,我们发现 AI 带来的流量仅占总引荐流量的 0.1%——远远落后于搜索。
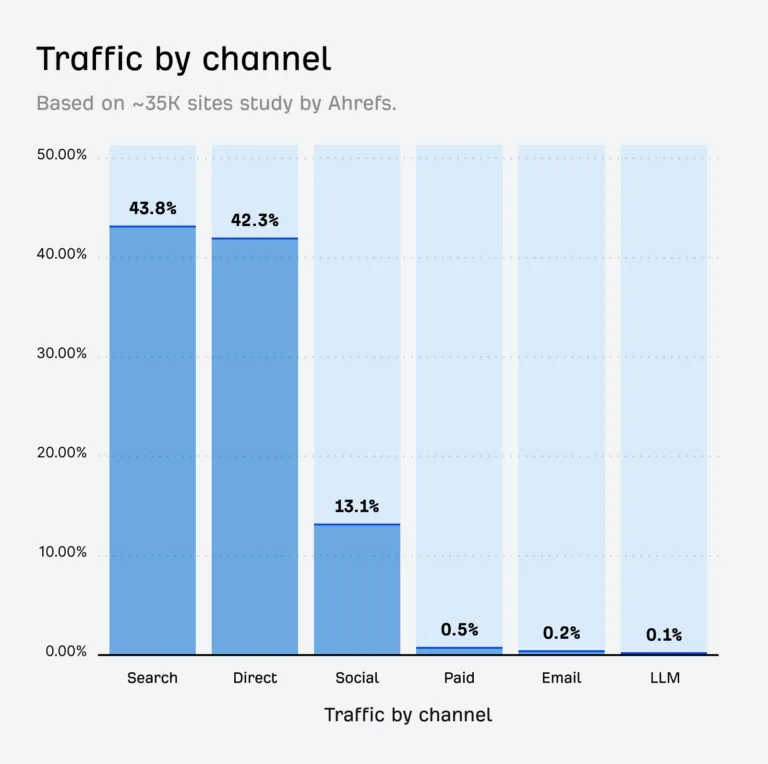
我认为很多网站主其实愿意让这些爬虫了解他们的品牌、业务、产品与服务。然而,尽管许多人押注这些系统代表着未来,但它们目前却面临一个风险:为网站所有者创造的价值还不够。
第一个能通过向网站所有者展示展示量与点击量来为用户创造更多价值的 LLM,很可能会获得巨大优势。届时企业会汇报来自该 LLM 的指标,这大概会提升其采用率,并阻止更多网站拦截它的爬虫。
这些爬虫在消耗资源、用数据训练它们的 AI,并制造潜在的隐私问题。因此,许多网站选择拦截 AI 爬虫。
我们审视了约 1.4 亿个网站,数据显示过去一年里 AI 爬虫的拦截率大幅上升。我要特别感谢我们的数据科学家 Xibeijia Guan 提取了这组数据。
核心要点
- AI 爬虫数量已增长一倍:自 2023 年 8 月以来,目前网络上活跃着 21 种主要 AI 爬虫。
- GPTBot(OpenAI)是被拦截最多的 AI 爬虫,有 5.89% 的网站拦截它。
- ClaudeBot(Anthropic)的拦截率增长最快,过去一年上升了 32.67%。
- 被拦截最多的爬虫,往往也是最活跃的爬虫。
AI 爬虫被拦截的频率有多高?
我们统计了拦截这些爬虫的网站总数。用 robots.txt 拦截爬虫的方式有很多种,这里涵盖的是所有情况,包括:
- 显式拦截:明确写出该爬虫并禁止其访问
- 通用拦截:可能禁止所有爬虫
- 在禁止所有爬虫之后,又出现允许该爬虫的指令的任何情况
注意事项:这不包括防火墙或 IP 封禁等其他拦截方式。
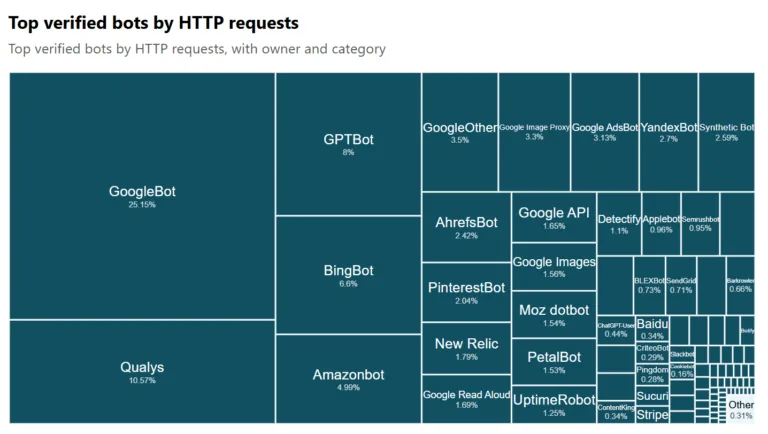
正如前面提到的,被拦截最多的爬虫是 GPTBot。根据 Cloudflare Radar 的数据,它也是活跃度最高的 AI 爬虫。
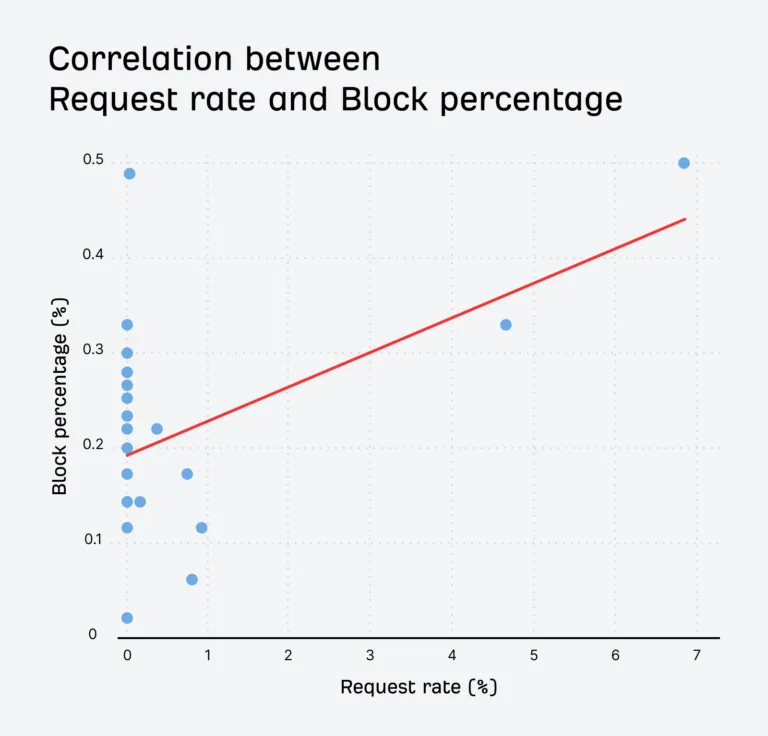
这些爬虫的请求频率与拦截率之间存在中等程度的正相关。请求越多的爬虫,往往越常被拦截。具体数字是:皮尔逊相关系数为 0.512,p 值为 0.0149,在 5% 的水平上具有统计显著性。
以下是整体拦截情况的数据:
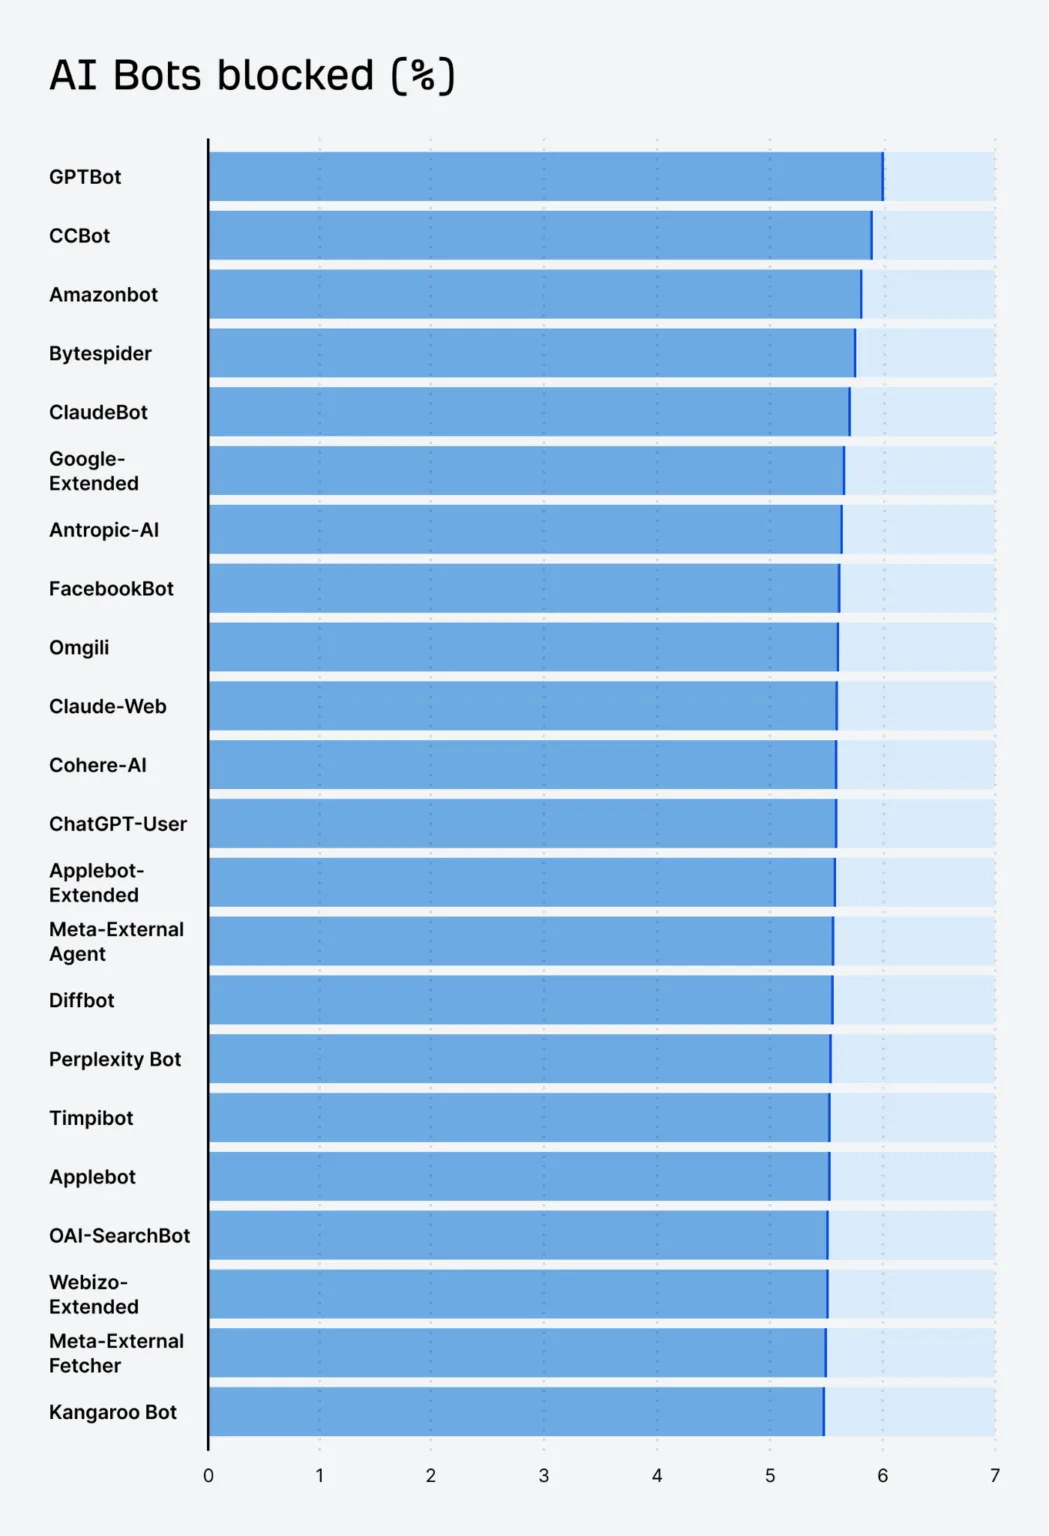
以下是拦截 AI 爬虫的网站总数:
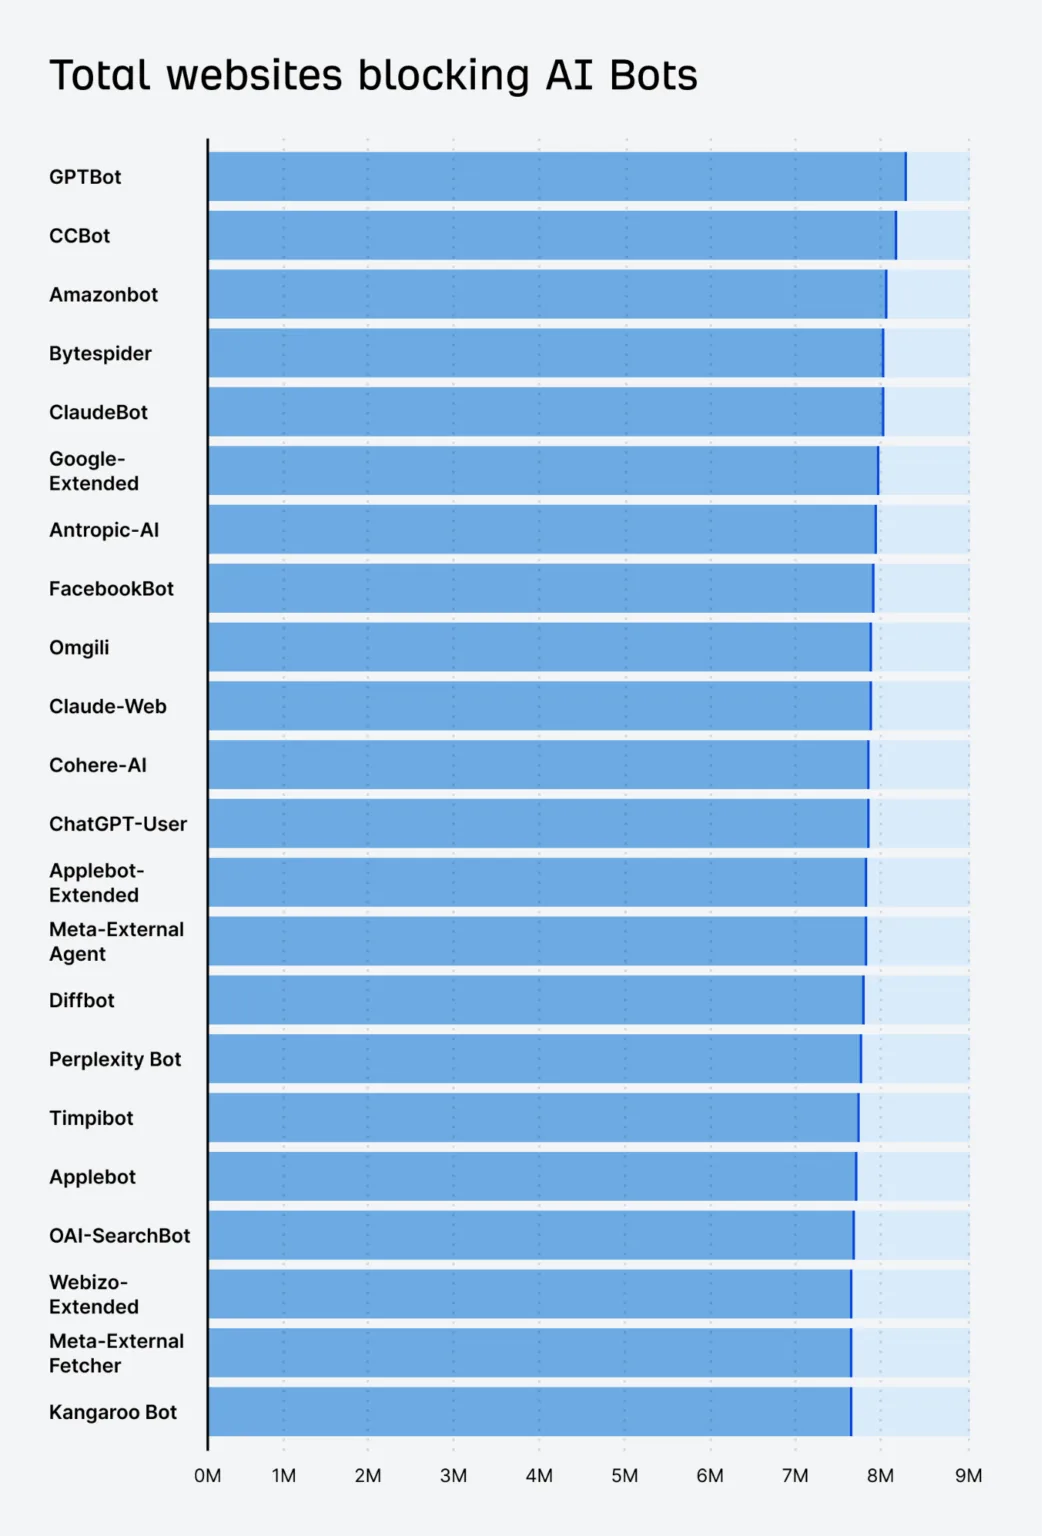
数据如下:
情况会稍微复杂一些。上面考察的是网站的主 robots.txt 文件,但每个子域名都可以有自己的一套指令。若看总计约 4.61 亿个 robots.txt,GPTBot 的总拦截率会上升到 7.3%。
AI 爬虫拦截情况随时间的变化
2024 年,更多高流量网站开始拦截 AI 爬虫,但这一趋势在年底有所回落。回落似乎主要来自通用拦截。而针对 AI 爬虫本身的趋势则在上升,稍后会展示给你看。
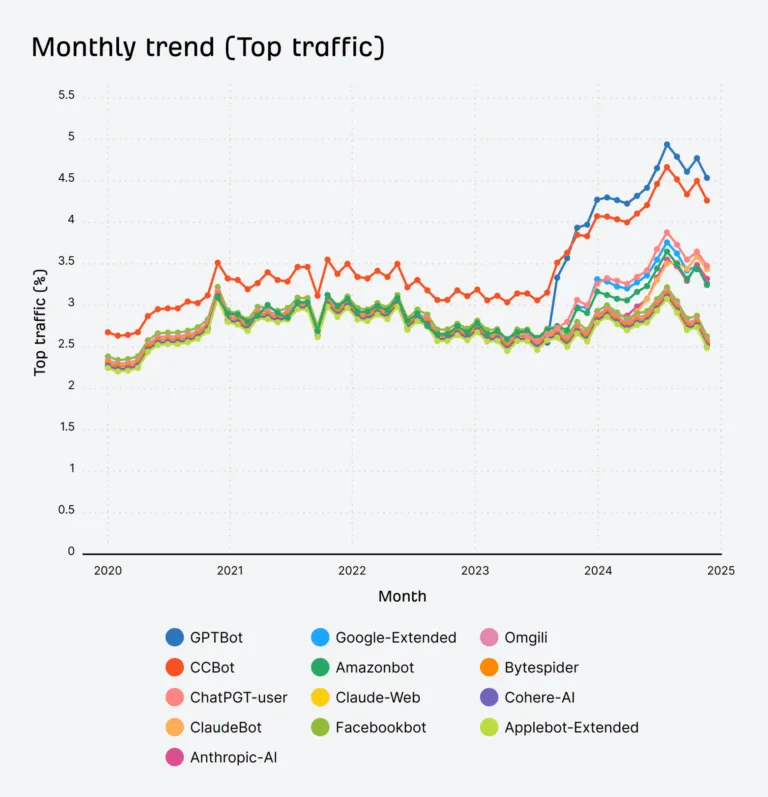
某些类型的网站是否更常拦截 AI 爬虫?
以下是各类别网站中每个爬虫的被拦截情况拆解。我原本以为新闻类会比其他类别被拦截得更多,因为有不少有关新闻网站拦截这些爬虫的报道,但实际上艺术与娱乐类(45% 被拦截)和法律法规与政府类(42% 被拦截)网站拦截得更多。
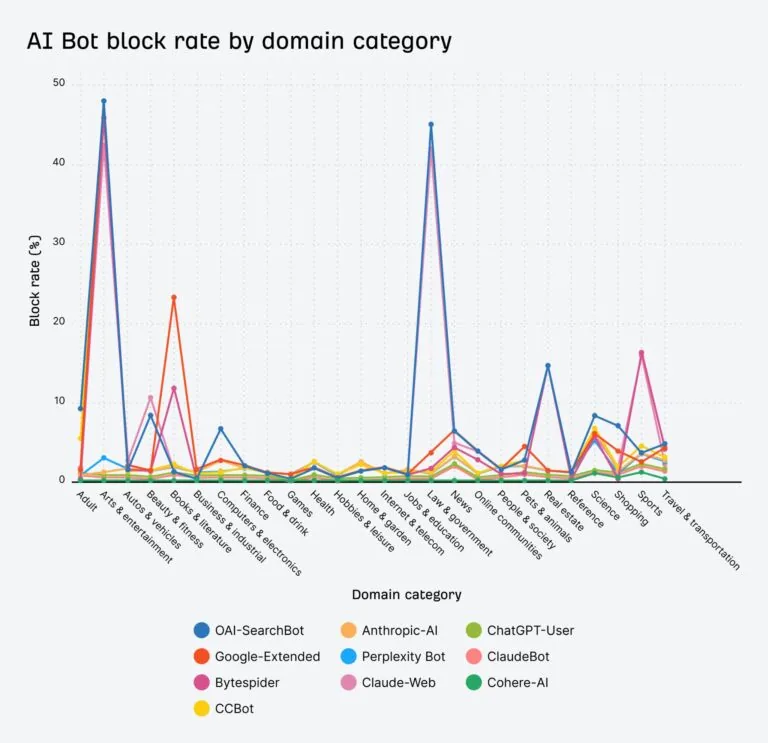
是否拦截 AI 爬虫的决定因行业而异,背后可能有多种独特原因。以下推测仅供参考:
- 艺术与娱乐:出于伦理反感,不愿成为训练数据。
- 图书与文学:版权问题。
- 法律与政府:法律顾虑、合规要求。
- 新闻与媒体:防止自家文章被用来训练可能与其新闻业务竞争的 AI 模型,以侵蚀其收入。
- 购物:防止竞争对手抓取价格或监控库存。
- 体育:与新闻和媒体类似,出于对收入的担忧。
AI 爬虫被专门针对的频率有多高?
在这项统计中,我们只看某个特定爬虫被禁止的情况。它不包括任何整体性的 disallow 声明,也不包括只允许某些爬虫的情况。在这些情形下,网站所有者是特意去专门拦截某些爬虫的。
同样,GPTBot 是被针对最多的,紧随其后的是 Common Crawl 的爬虫。Common Crawl 的数据很可能被大多数 LLM 用作数据来源。
以下是被网站专门针对、拦截最多的 AI 爬虫:
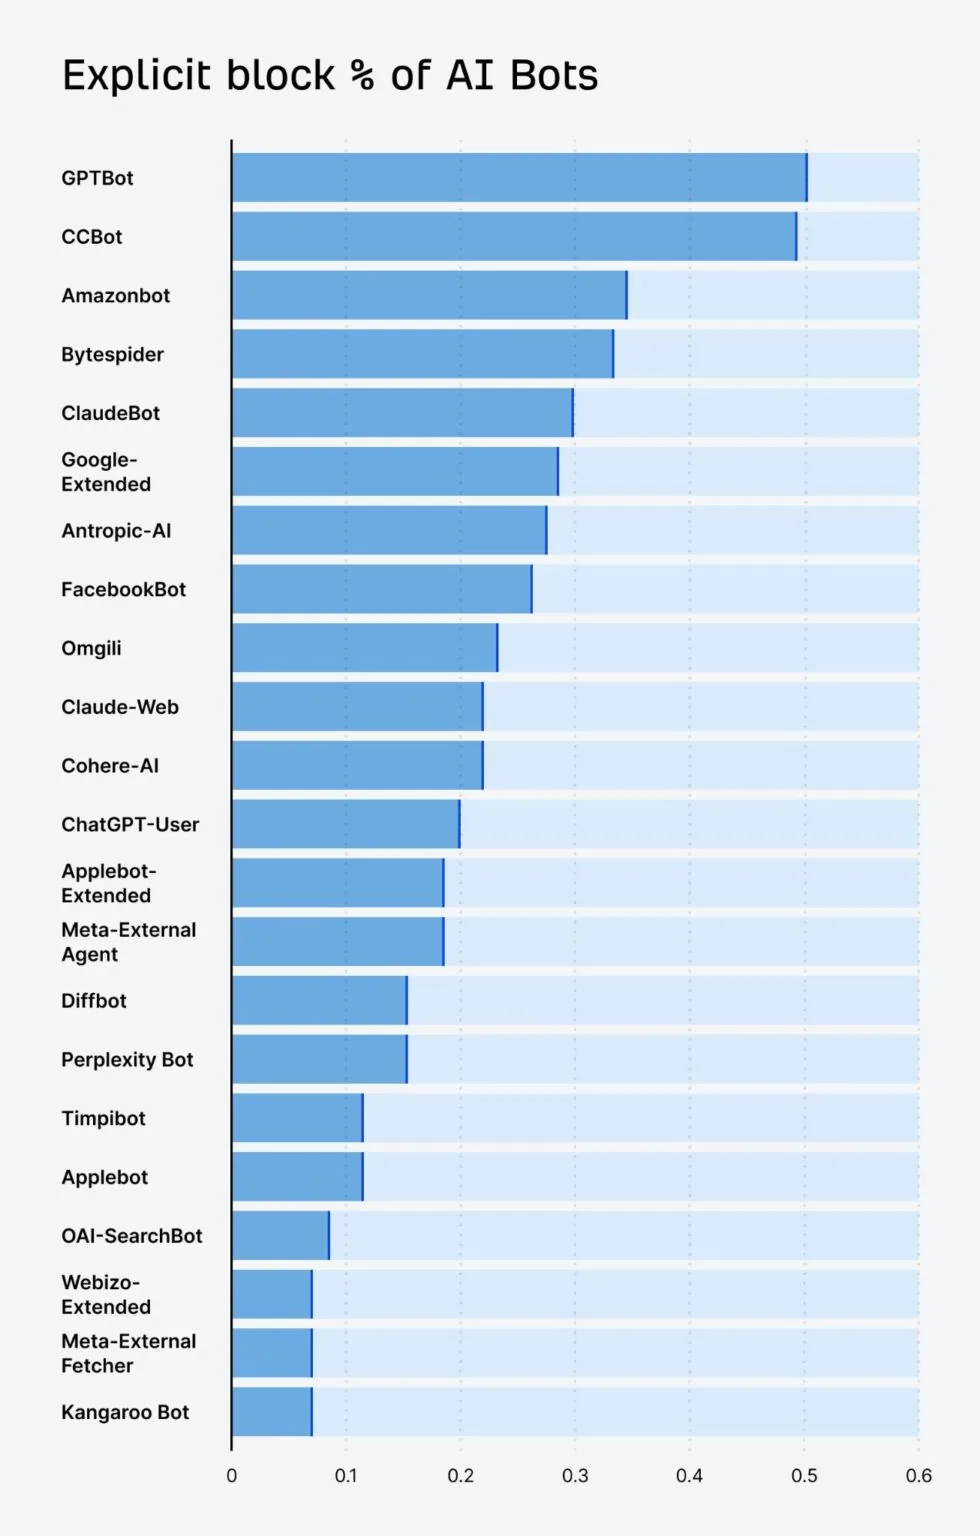
以下是拦截它们的网站数量数据:
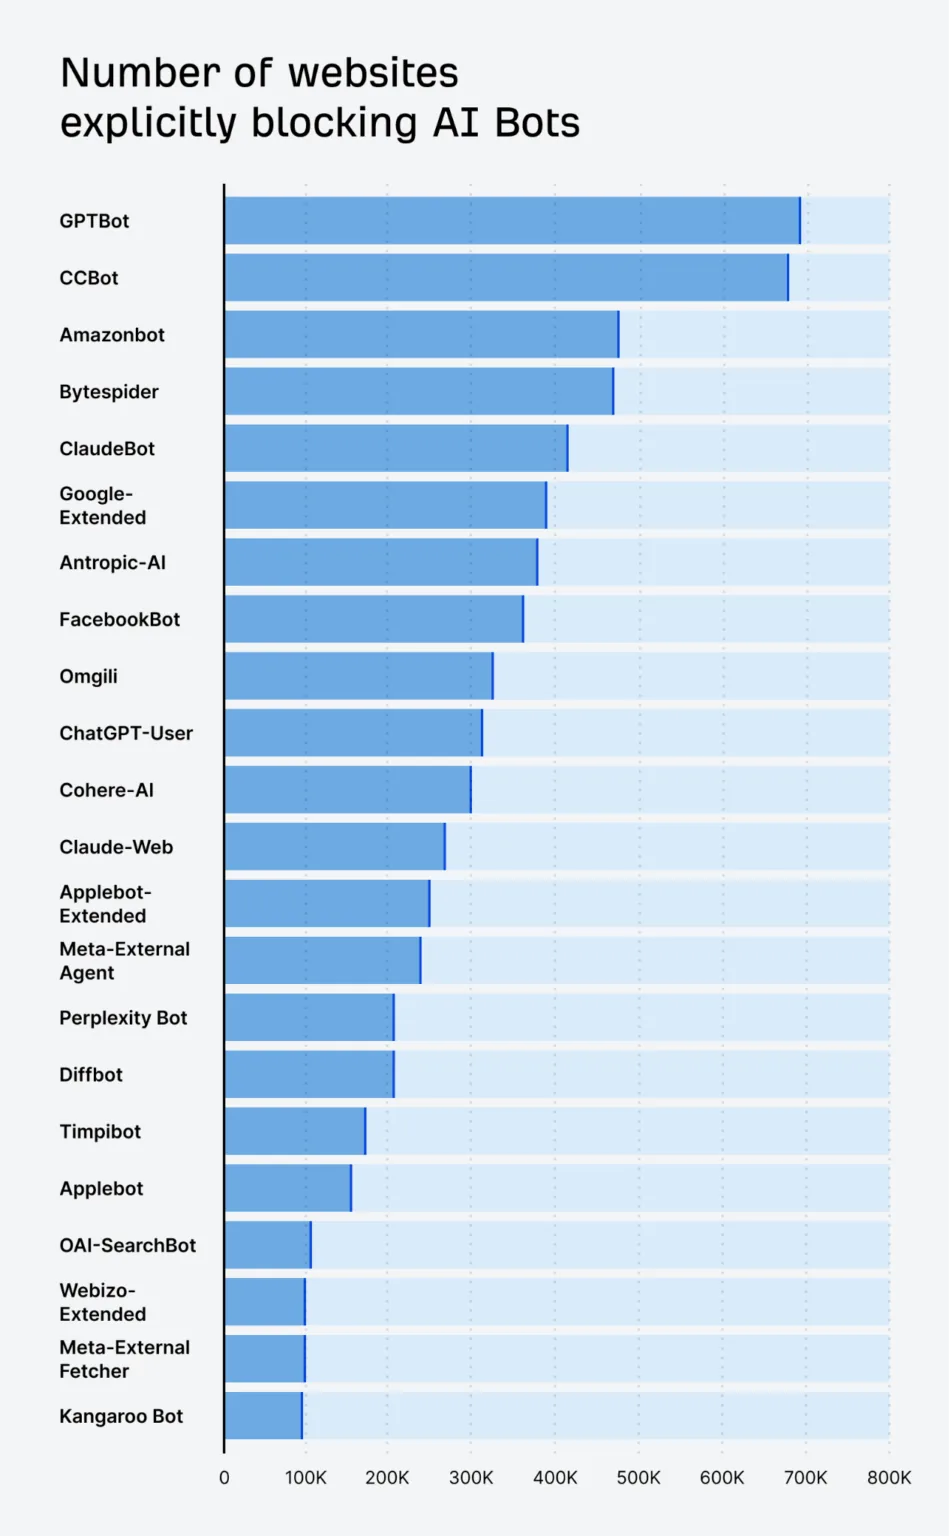
数据如下:
AI 爬虫显式拦截情况随时间的变化
如你所见,越来越多的最高流量网站开始拦截 AI 爬虫。
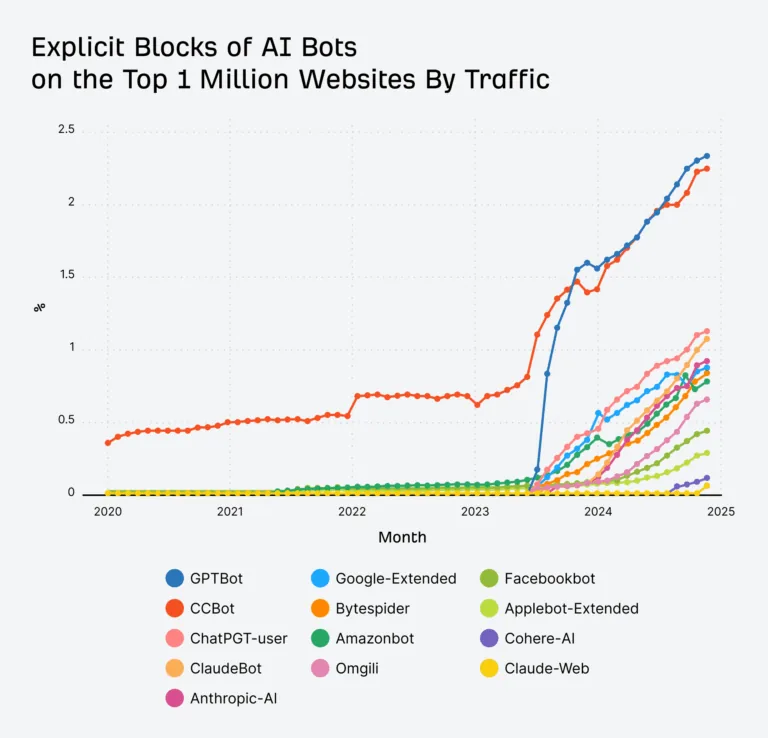
拦截情况随时间的变化
在短短一年多的时间里,AI 爬虫的数量翻了一番还多,从 2023 年 8 月的 10 种增加到 2024 年 12 月的 21 种。市场上更多新入局者,意味着更多爬虫都在消耗资源抓取网站。
过去一年里,Claudebot 是所有爬虫中增长最快的。
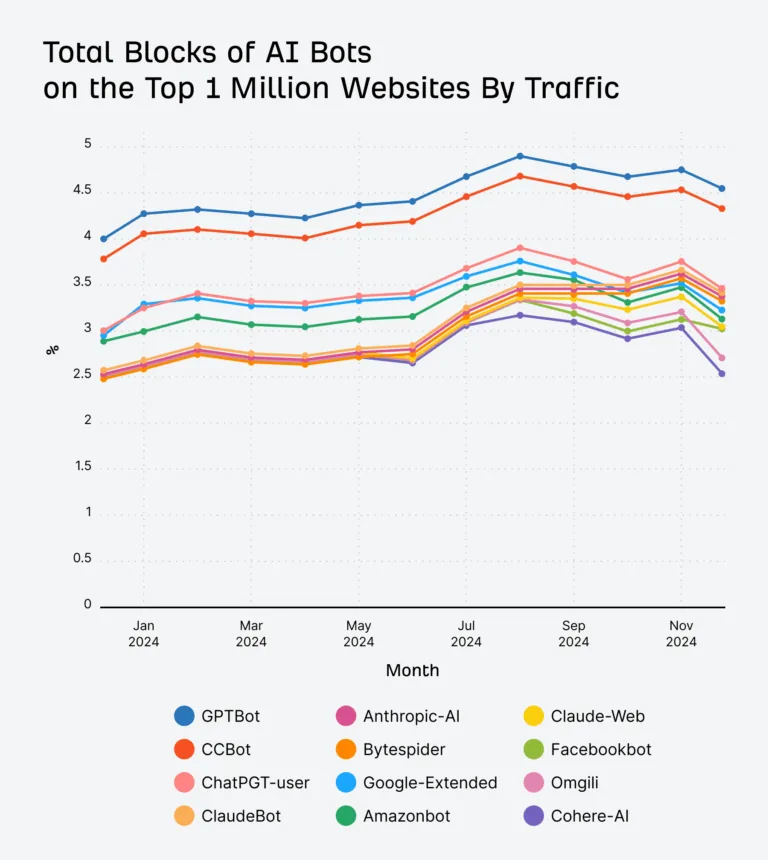
数据如下:
最后总结
随着这些爬虫开始占用越来越多的资源,拦截率会如何演变,将会很有意思。它们究竟能履行与网站所有者之间的社会契约、给网站送去更多流量,还是会选择把这些流量留给自己?
我认为,如果它们走“围墙花园”的路线,那么会有更多网站最终选择拦截这些爬虫,而这些系统将不得不付费从网站获取数据,否则爬虫可能就会破坏网络标准、无视 robots.txt 的拦截。已经有几份报告指出,一些 AI 爬虫已经无视 robots.txt 的拦截,这开了一个危险的先例。
你怎么看?你会在自己的网站上拦截它们,还是认为让它们访问有价值?欢迎在 X 或 LinkedIn 上告诉我。