什么是 URL 参数?使用指南
URL 参数是附加在 URL 末尾的额外信息。本文将介绍如何使用它们。
URL 参数通过 URL 传递数据,使单个页面无需为每种变化都单独建页,就能呈现不同行为。你可能在产品筛选或站内搜索中见过这种情况。
但如果参数设置不当,它们会浪费抓取预算,并让搜索系统难以确定一个页面究竟哪个版本才是重要的。
本指南会具体介绍什么是 URL 参数、它们如何构成、主动参数与被动参数的区别,以及如何避免它们损害你的 SEO 和 AI 可见性。
什么是 URL 参数?
URL 参数是附加在 URL 末尾的额外信息,用于告诉网站如何自定义内容、筛选结果或追踪浏览会话。
下面是一个用于筛选电商结果的简单 URL 参数示例:
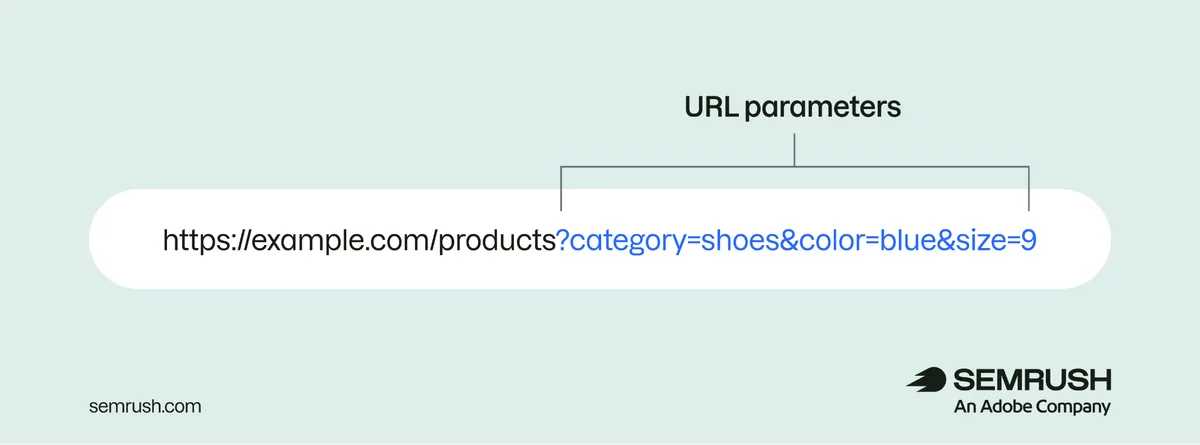
URL 参数只是完整 URL 的一部分,完整 URL 通常还包含协议(scheme)、域名、顶级域名和路径。
URL 参数的结构
URL 参数出现在问号(?)之后,由键值对组成,多个键值对之间用一个或多个 &(与号)分隔。具体来说:
- 问号(?)之前的所有内容是一个标准 URL
- 所有参数都在问号(?)之后
- 每个参数写成一个由等号分隔的键和值(category=shoes)
- 多个参数之间用 &(与号)分隔
URL 参数与查询字符串
URL 参数是单个的键值对,而查询字符串是参数的整个字符串——包括问号和与号。
以下这些是 URL 参数(有时也叫查询参数):
而下面是一个查询字符串:
尽管如此,许多营销人员会把 URL 参数和查询字符串这两个术语混用。在大多数语境下这完全没问题。
URL 参数有什么用途?
URL 参数用于增强网站功能、追踪广告活动以及改善用户体验。
具体来说,URL 参数用于:
- 筛选和排序内容:你可以用 URL 参数动态地筛选或排序内容,而无需用户重新加载整个页面。这对拥有众多产品类别和变体的电商网站尤其有用,也适合需要帮助用户在大量商品中缩小范围的相关站点。
- 分页:URL 参数有助于把大量内容分布在多个页面上展示(?page=2、?page=3、?page=4 等),让用户能够逐页浏览。这对内容集庞大的网站尤其有用,比如博文和产品列表。
- 搜索功能:URL 参数也可用于网站的搜索功能。当用户提交一个搜索查询时,该查询会被附加到 URL 上(https://example.com/?search=running+shoes),从而让网站展示相关的搜索结果。
- 广告活动追踪:营销人员使用名为 UTM 参数的 URL 参数来追踪流量来源,并在分析平台中衡量广告活动效果。它们是被动的,即不改变页面内容,而是把数据发送给你的分析工具。你可以手动创建 UTM 参数,也可以用 Google 的 Campaign URL Builder 之类的工具创建。
URL 查询参数的主要类型有哪些?
URL 查询参数的主要类型分为主动(active)和被动(passive)。
主动参数
主动参数会直接影响网页的内容或行为。
当主动参数出现在 URL 中时,网站会使用这些值来改变页面的展示内容或运作方式,从而打造贴合用户需求的动态、交互式体验。
主动参数的常见例子包括
- 筛选产品列表
- 从分页系列中加载特定页面
- 展示搜索结果
被动参数
被动参数不改变页面的可见内容,而是在后台发挥作用,支持诸如追踪用户行为之类的功能。
被动参数最常用于监测流量来源,主要通过 UTM 参数实现。
URL 中的参数如何影响 SEO?
URL 中的参数之所以会影响 SEO 表现和 AI 可见性,很大程度上是因为它们会产生许多内容相似的页面。
例如,一个以“?sort=asc”结尾的页面和另一个以“?sort=desc”结尾的页面,可能展示相同的内容,只是顺序不同。而当你拥有内容高度相似的页面时,就会面临以下风险:
- 重复内容:当参数产生同一页面的多个版本时,搜索引擎很难判断应优先哪个版本,从而降低整体可见性。这一问题也会影响 AI 系统。
- 抓取预算 浪费:搜索引擎和 AI 爬虫在给定时间内只会分配一定的时间和资源来抓取(读取)一个网站。如果你的网站生成了大量指向相似内容的带参数 URL,网站爬虫可能会把时间浪费在这些变体上,而无法发现其他有价值的内容。
- 关键词蚕食:带有不同参数的多个 URL 往往针对同一组查询。这意味着你的页面本质上是在搜索结果中相互竞争。这种内部竞争会阻止任何单个页面在自然搜索和 AI 搜索中表现出色。
- 价值信号被稀释:当外部和内部来源都指向同一页面的多个带参数版本时,入站链接的价值会被削弱。这会削弱该页面在自然搜索和 AI 搜索结果中的可见性潜力。
使用 URL 参数时的关键考量
由于 URL 参数会影响你的搜索可见性,因此需要仔细规划和管理。
因此,在你的网站上使用 URL 参数时,请牢记以下几点:
参数顺序很重要
参数顺序之所以重要,是因为搜索引擎和 AI 系统可能会把参数相同但顺序不同的 URL 视为不同页面,即使它们展示的内容完全相同。
例如,以“?color=blue&size=9”结尾和以“?size=9&color=blue”结尾的页面可能被视为不同的 URL。这会产生更多重复内容,进而影响搜索表现。
大多数现代 CMS 和网站平台会自动强制使用一致的参数顺序,所以这一点通常已经为你处理好了。对于涉及手动创建 URL 参数的广告活动,请让团队就正确的顺序达成一致。
参数会带来性能上的取舍
参数会带来性能上的取舍,因为带参数的 URL 往往会绕过缓存机制(让服务器展示页面已保存副本的快捷方式),导致服务器获取内容时加载变慢。
如果你的参数没有显著改变内容,就考虑一下这项功能是否值得付出性能代价。例如,在一个只有五件产品的页面上使用“按价格排序”参数,可能就不值得。
参数区分大小写
在许多系统中,URL 参数区分大小写,这意味着“?Color=Blue”和“?color=blue”可能被视为不同的参数值。
最稳妥的做法是在实现时统一参数的大小写,并使用 规范标签(用于指定页面主要版本的 HTML)来合并任何存在的变体。
参数会在多个地方可见
URL 参数对用户可见,同时也会被 Web 服务器、分析平台、浏览器历史记录、日志以及其他处理流量数据的工具捕获。
因此,避免在 URL 参数中使用敏感数据(如个人信息)。
使用 URL 参数的 5 个对搜索友好的做法
以下是使用 URL 参数的五个对搜索友好的做法:
1. 添加规范标签
所有带参数的 URL 都应包含一个 规范标签,把不含参数的那个页面指定为主要页面。
规范标签告诉搜索引擎哪些 URL 应被索引(存入数据库)用于排名,从而把链接权重(排名能力)集中到主要页面,并防止重复内容问题。
此外,随着时间推移,搜索引擎会优先抓取规范页面而非带参数的变体,从而提升你网站的抓取效率。
清晰的规范信号还有助于你偏好的页面出现在 AI 驱动的搜索系统中。
对于筛选选项繁多的网站,添加规范标签尤为重要,例如:
- 带有颜色、尺码、品牌、价格等筛选条件的电商网站
- 带有位置、价格区间、配套设施等筛选条件的房产网站
- 带有职位、经验、地点等多种筛选组合的招聘网站
- 任何可通过大量参数组合访问相似内容的网站
实施规范标签相对简单。与你的开发者合作,把这一行代码添加到带参数页面以及规范版本的 <head> 区域(只需把示例 URL 替换为你想要指定的主要页面 URL):
2. 用 robots.txt 屏蔽包含参数的 URL
你可能想用 robots.txt(一套给爬虫的指令)屏蔽某些带参数的 URL,以告诉机器人不要抓取这些页面。
机器人会在抓取你的网站之前检查 robots.txt 文件,并且通常会遵循其中关于哪些页面不要抓取的指令。请考虑以下这些屏蔽带参数 URL 可能有用的情况:
- 你的参数会生成近乎无限、且几乎没有独特内容的 URL
- 你正遭遇抓取预算问题,由于带参数 URL 数量庞大,搜索引擎无法抓取你所有的重要页面
要查看 Google 的抓取活动并识别有问题的参数,请前往 Google Search Console(GSC),并进入“Settings”(设置)。
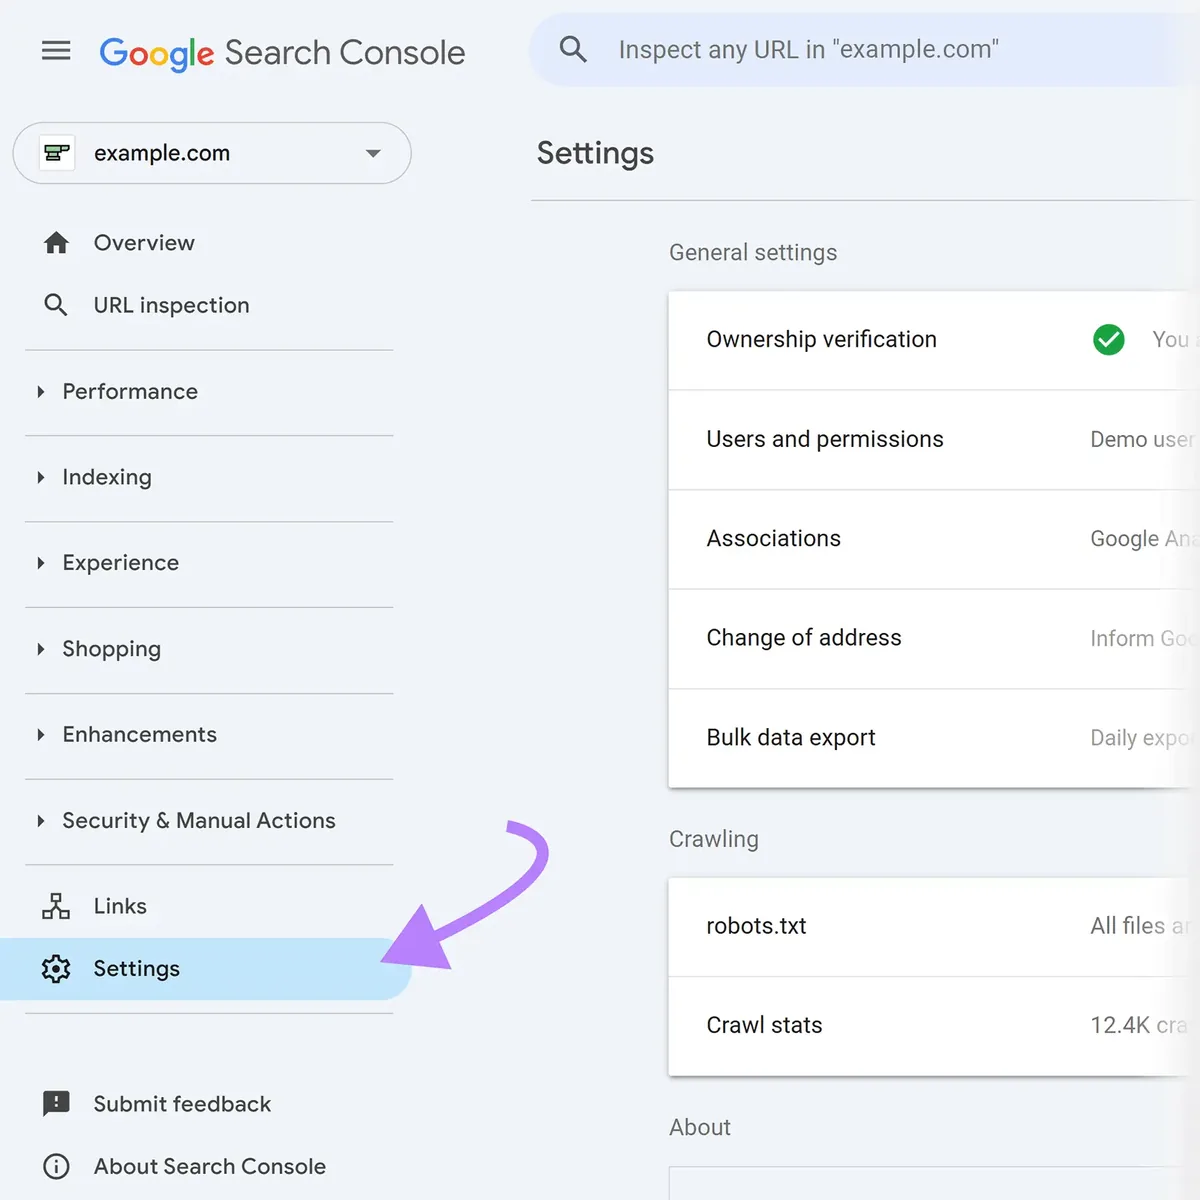
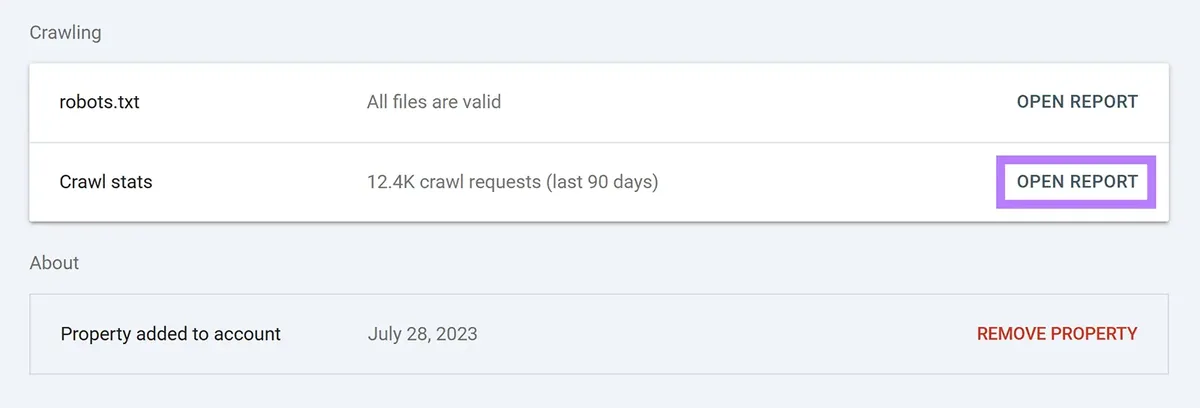
找到“Crawl stats”(抓取统计信息)报告,然后点击“Open Report”(打开报告)。
滚动到“By file type”(按文件类型),点击“HTML”,查看 Google 对你网站的抓取活动。
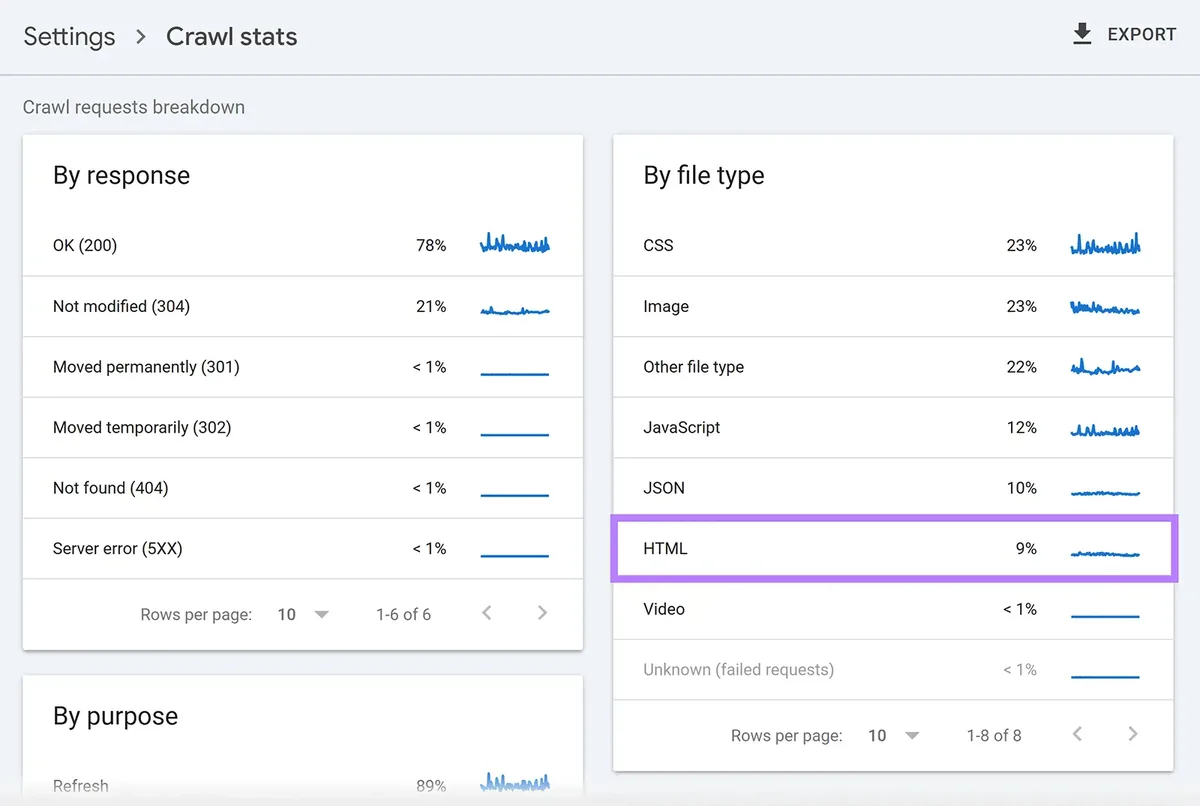
在“Examples”(示例)下,查找那些可能正在浪费你抓取预算的、反复出现的带参数 URL。
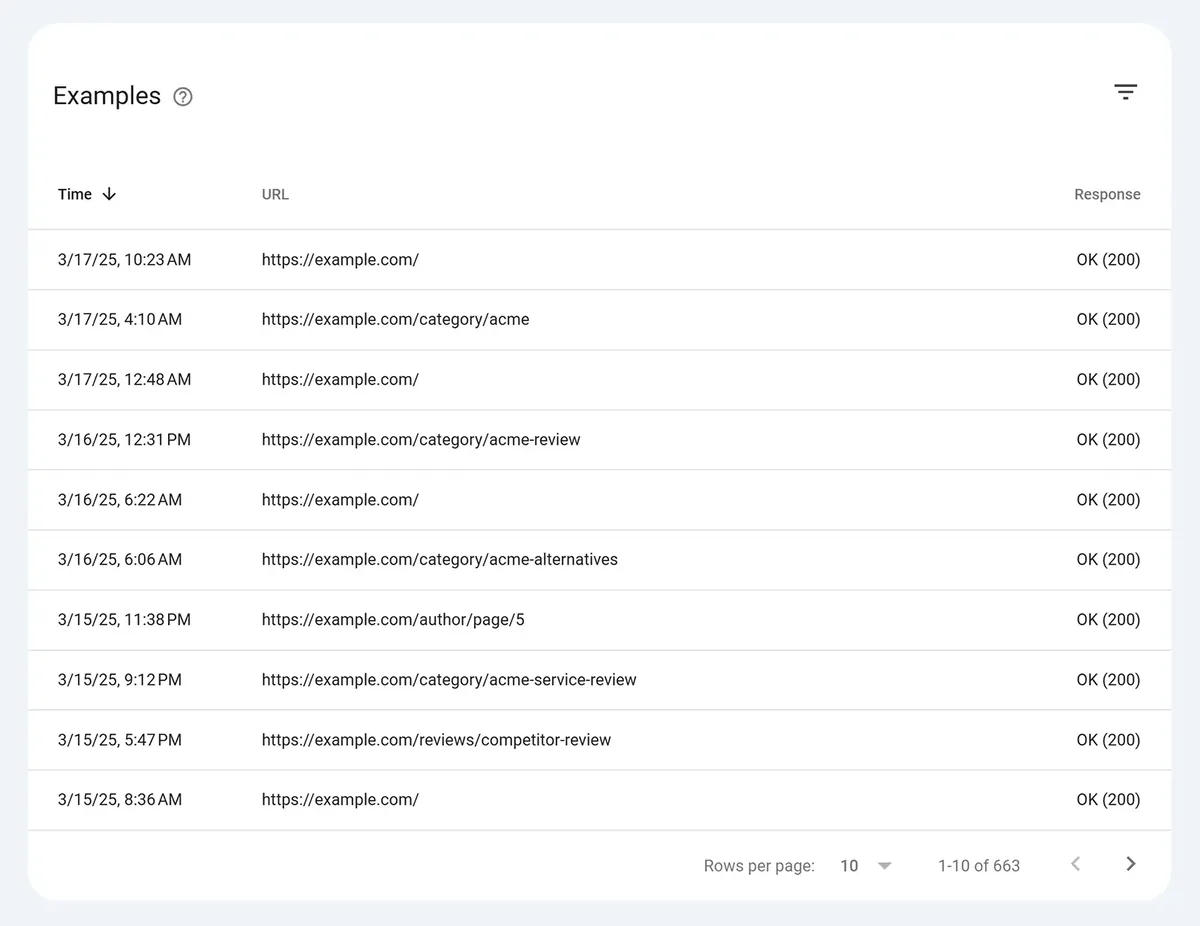
识别出有问题的参数后,在 robots.txt 文件中屏蔽它们。例如,下面的规则告诉爬虫不要抓取包含“?sort=”的 URL,从而为更重要的内容节省抓取预算:
3. 避免用 URL 参数做本地化
避免用 URL 参数为不同地区和/或语言的客户做网站本地化,因为它们对用户不够友好,而且会给你的搜索结果带来问题。
此外,Google 明确表示不应使用 URL 参数来做本地化。
更好的做法是为每个地区使用专门的 URL,并结合 hreflang 标签,向搜索引擎表明应为不同国家或语言市场的用户提供哪个版本的页面。这种做法对用户更友好,也能提供更清晰的地理定位信号。
地区专属页面的常见 URL 结构包括:
- 子目录(例如 example.com/fr/)
- 子域名(例如 fr.example.com)
- 国家专属域名(例如 example.co.fr)
4. 使用一致的内链
使用一致的内链可以集中链接权重,并向搜索引擎和 AI 系统传送清晰的信号,说明应在搜索结果中优先哪个页面。
内链应指向每个页面干净、规范的版本——而非带参数的变体。
5. 在技术审计中排除带参数的 URL
在技术审计中排除带参数的 URL,可以让审计专注于网站的核心内容。
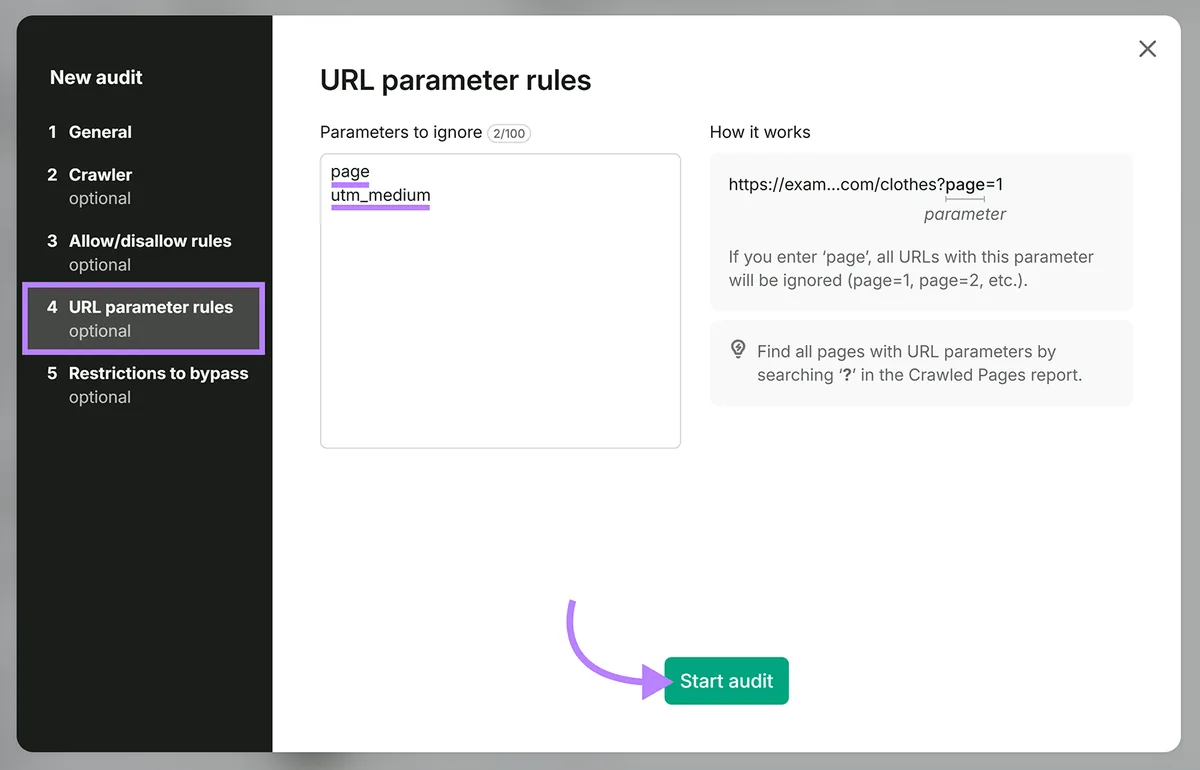
Semrush Site Audit 允许你配置工具,从抓取中排除带参数的 URL。在设置向导中,选择“URL parameter rules”(URL 参数规则),并列出你想要从抓取中排除的参数。例如,输入“page”会排除诸如“?page=1”这样的分页参数。
列出你想要忽略的参数后,点击“Start audit”(开始审计)。
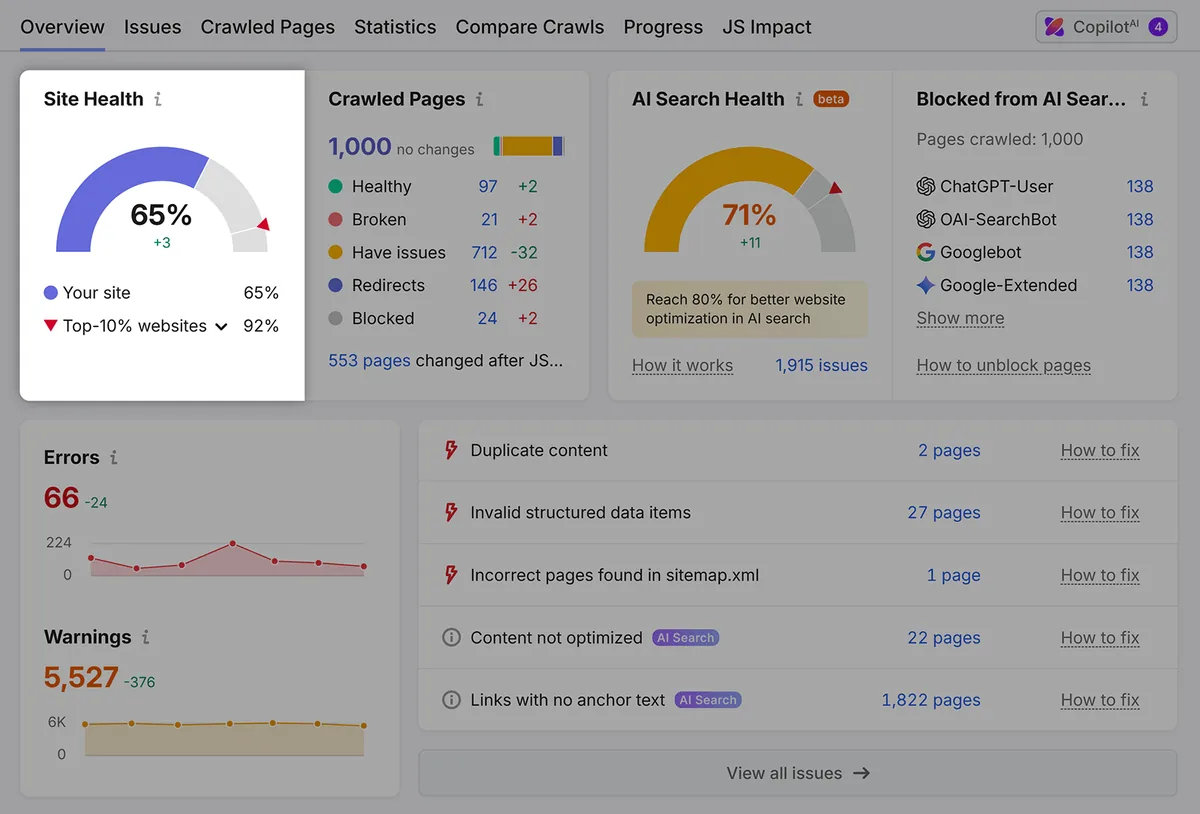
抓取完成后,Site Audit 会生成一份报告,展示你网站整体的技术健康状况。
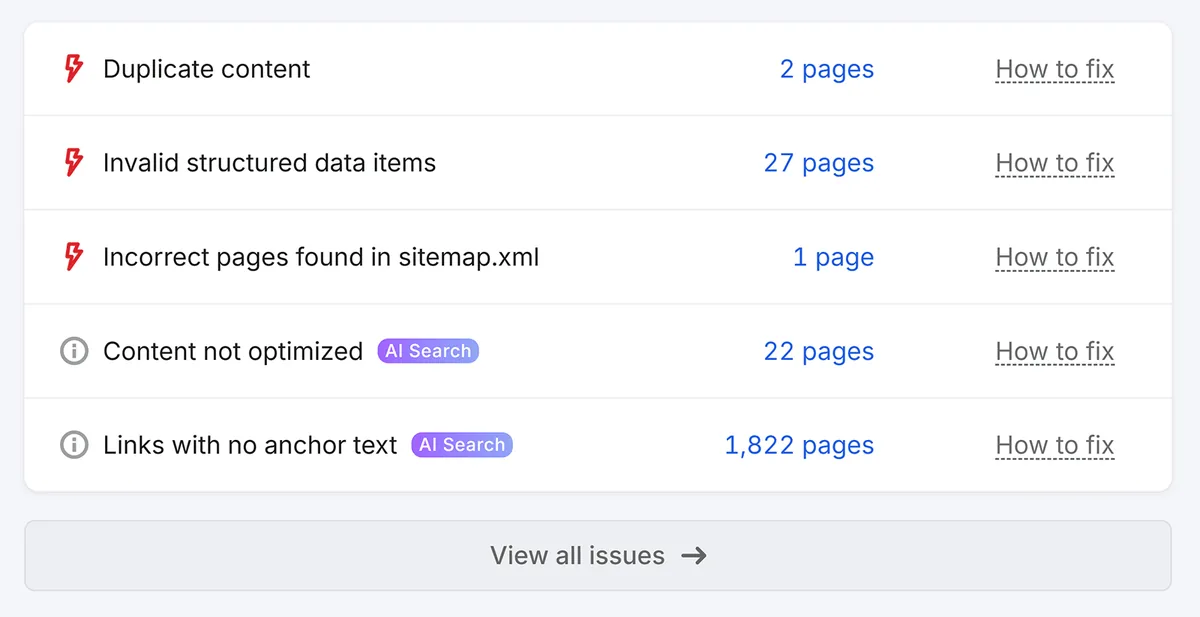
你还会看到一份影响你重要内容的问题列表。请审阅 Site Audit 的发现,并优先实施那些最可能产生最大影响的修复。
使用合适的工具更好地管理 URL 参数
管理好 URL 参数,归根结底在于正确生成链接,并恰当地指明哪个页面是你偏好的版本。
如果你怀疑网站上许多技术问题都是由管理不当的 URL 参数造成的,就在不排除带参数 URL 的情况下运行 Site Audit。例如,你会清楚地看到可以通过实施规范标签来解决的重复页面。
立即试用 Site Audit。