什么是 Googlebot?Google 网络爬虫如何工作
Googlebot 是 Google 用来自动抓取网页、发现内容的爬虫。本指南介绍它的工作原理。
什么是 Googlebot?
Googlebot 是 Google 用来自动抓取(访问)网页、并发现网页内容的主要程序。
作为 Google 主要的网站爬虫,它的作用是让 Google 庞大内容数据库(即索引)保持最新。
索引越新、越全面,搜索结果就会越好、越相关。
Googlebot 主要有两个版本:
- Googlebot 智能手机版(Googlebot Smartphone):主要的 Googlebot 网络爬虫。它像移动设备上的用户那样抓取网站。
- Googlebot 桌面版(Googlebot Desktop):这个版本的 Googlebot 像桌面电脑上的用户那样抓取网站,检查网站的桌面版本。
还有一些更专门的爬虫,如 Googlebot Image、Googlebot Video 和 Googlebot News。
为什么 Googlebot 对 SEO 很重要?
Googlebot 对 Google SEO 至关重要,因为(在大多数情况下)没有它,页面就不会被抓取和索引。如果页面没有被索引,就无法获得排名,也不会显示在搜索引擎结果页面(SERP)上。
而没有排名就意味着没有自然(非付费)搜索流量。
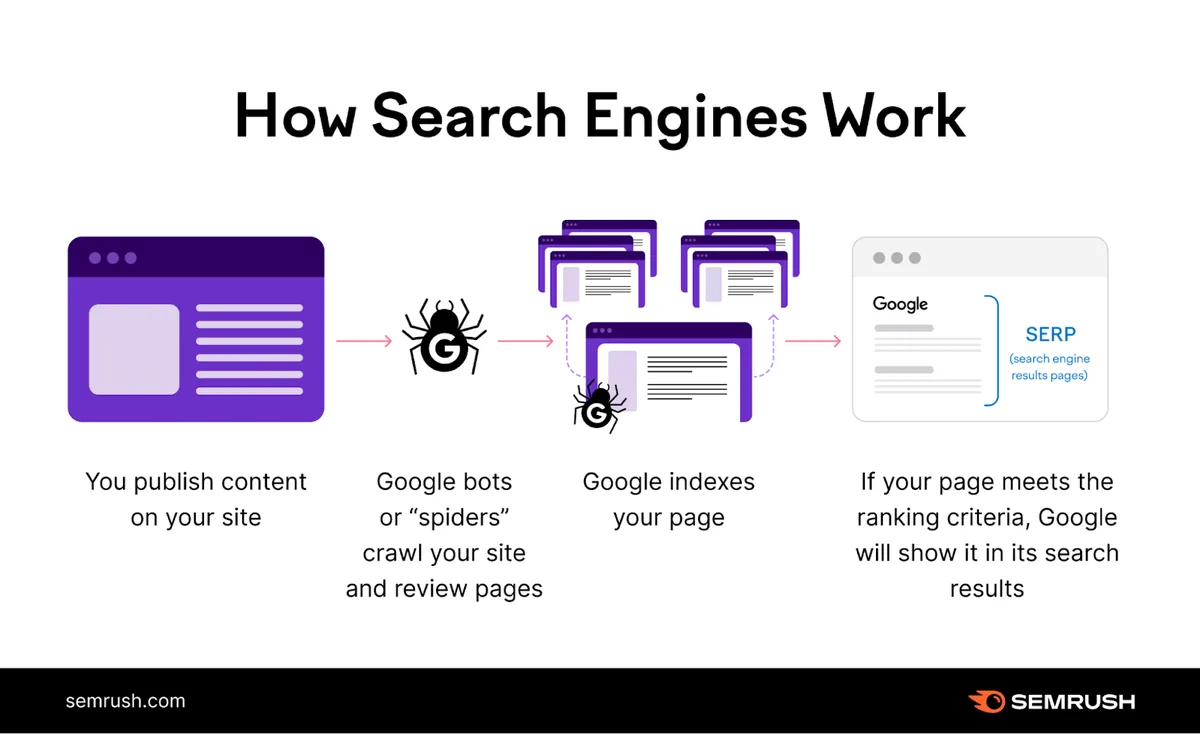
此外,Googlebot 会定期回访网站,检查是否有更新。
没有它,新内容或现有页面的改动就不会反映在搜索结果中。而不保持网站最新,会让在搜索结果中维持可见度变得更加困难。
Googlebot 如何工作
Googlebot 通过抓取网页并把数据送去索引,帮助 Google 在 SERP 中提供相关而准确的结果。
下面仔细看看抓取和索引这两个阶段:
抓取网页
抓取是发现和探索网站以收集信息的过程。Google 的分析师 Gary Illyes 在这段视频中解释了这个过程:
Googlebot 持续不断地抓取互联网,以发现新的和更新的内容。
它维护着一份不断更新的网页清单,既包括之前抓取时发现的网页,也包括新网站。
这份清单就像是 Googlebot 专属的探险地图,指引它接下来去哪里探索。
Googlebot 还会跟踪页面之间的链接,以持续发现新的或更新的内容。
就像这样:
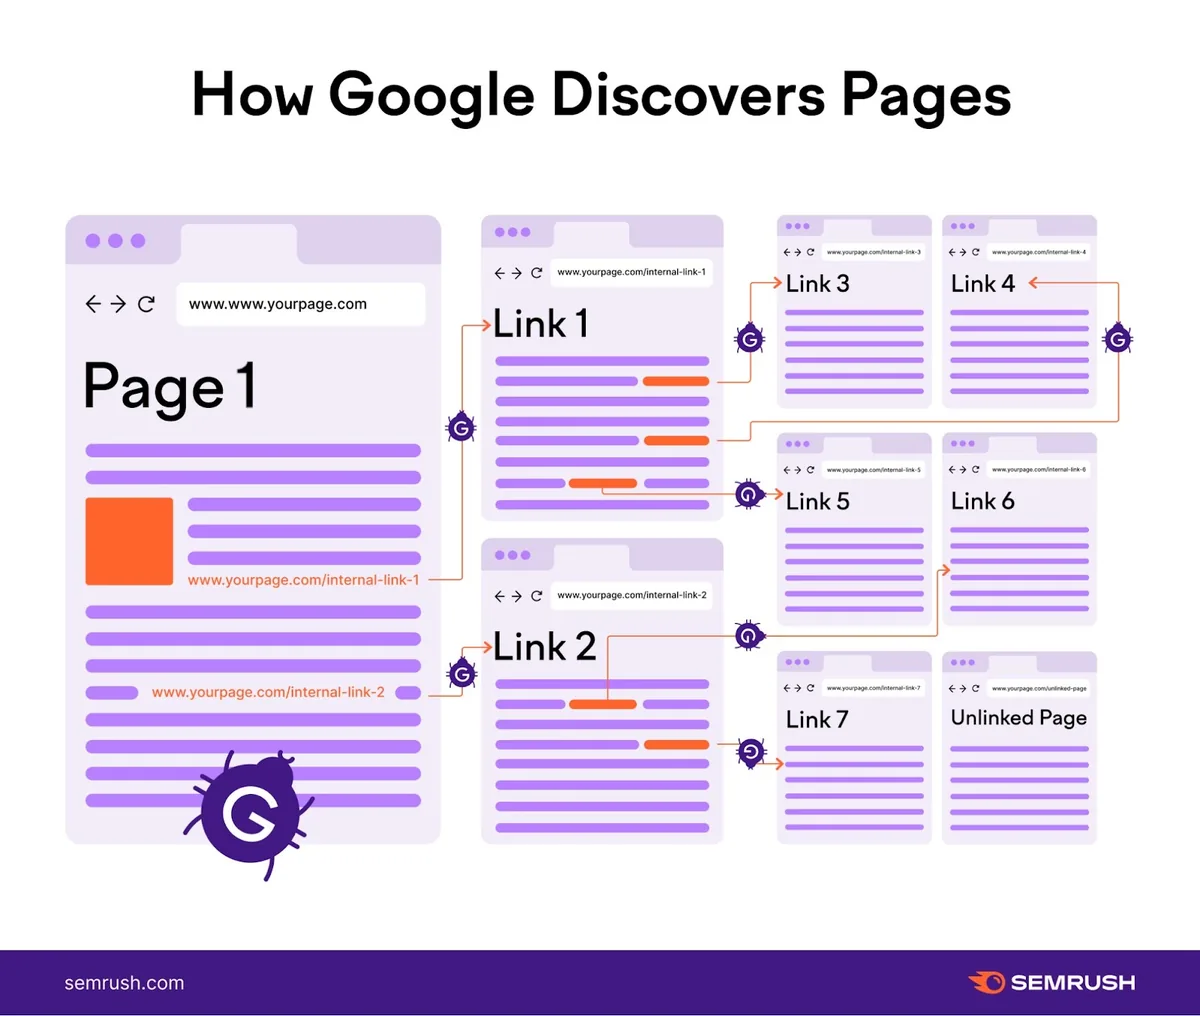
一旦 Googlebot 发现某个页面,就可能访问并获取(下载)该页面的内容。
然后,Google 可以渲染(即可视化处理)该页面,模拟真实用户会如何看到和体验它。
在渲染阶段,Google 会运行它发现的任何 JavaScript。JavaScript 是一种代码,可为网页添加交互性和响应式元素。
渲染 JavaScript 让 Googlebot 能以与用户相似的方式看到内容。
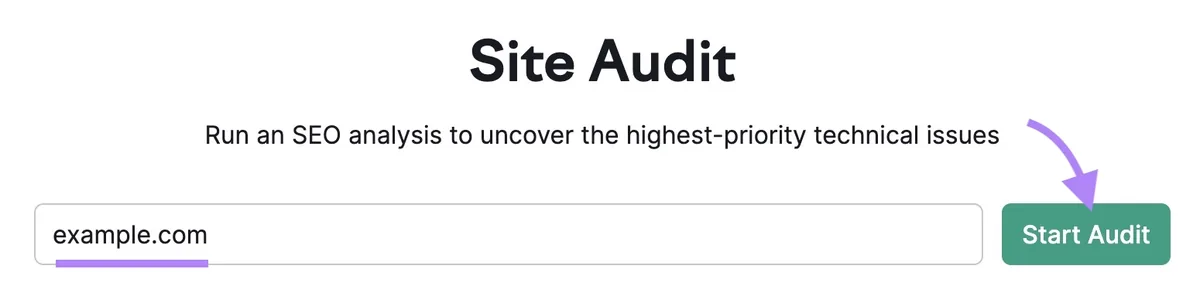
打开该工具,输入域名,然后点击“开始审计(Start Audit)”。
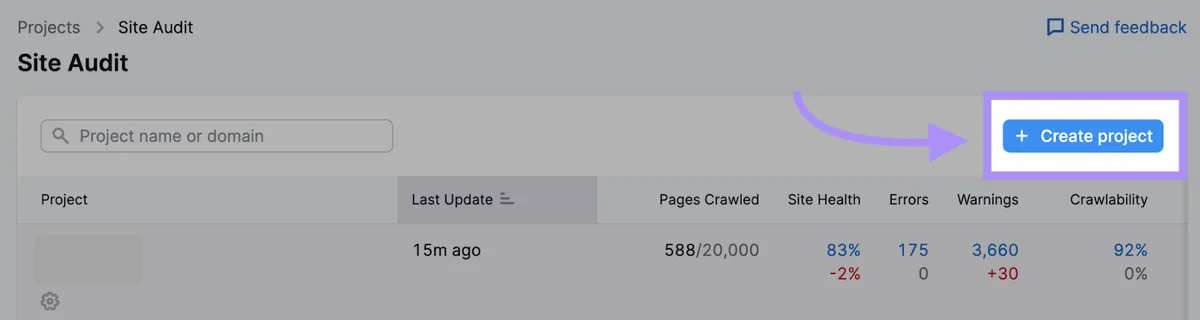
如果已经运行过审计或创建过项目,点击“+ 创建项目(Create project)”按钮新建一个。
输入域名,为项目命名,然后点击“创建项目(Create project)”。
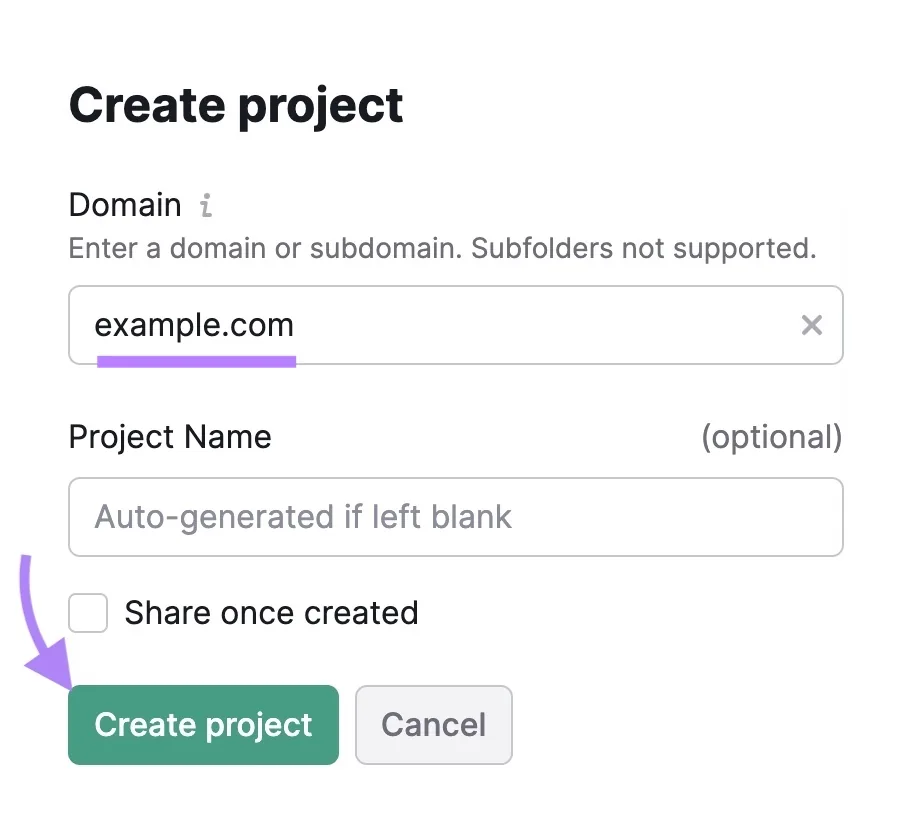
接下来,系统会要求配置设置。
如果刚开始使用,可以采用“域名和页面数量限制(Domain and limit of pages)”部分中的默认设置。
然后点击“爬虫设置(Crawler settings)”标签页,选择想用来抓取的用户代理(user agent)。用户代理是一个标签,用来告知网站访问者是谁,就像搜索引擎机器人佩戴的姓名牌。
可选机器人之间没有重大区别,它们都被设计成像 Googlebot 那样抓取网站。
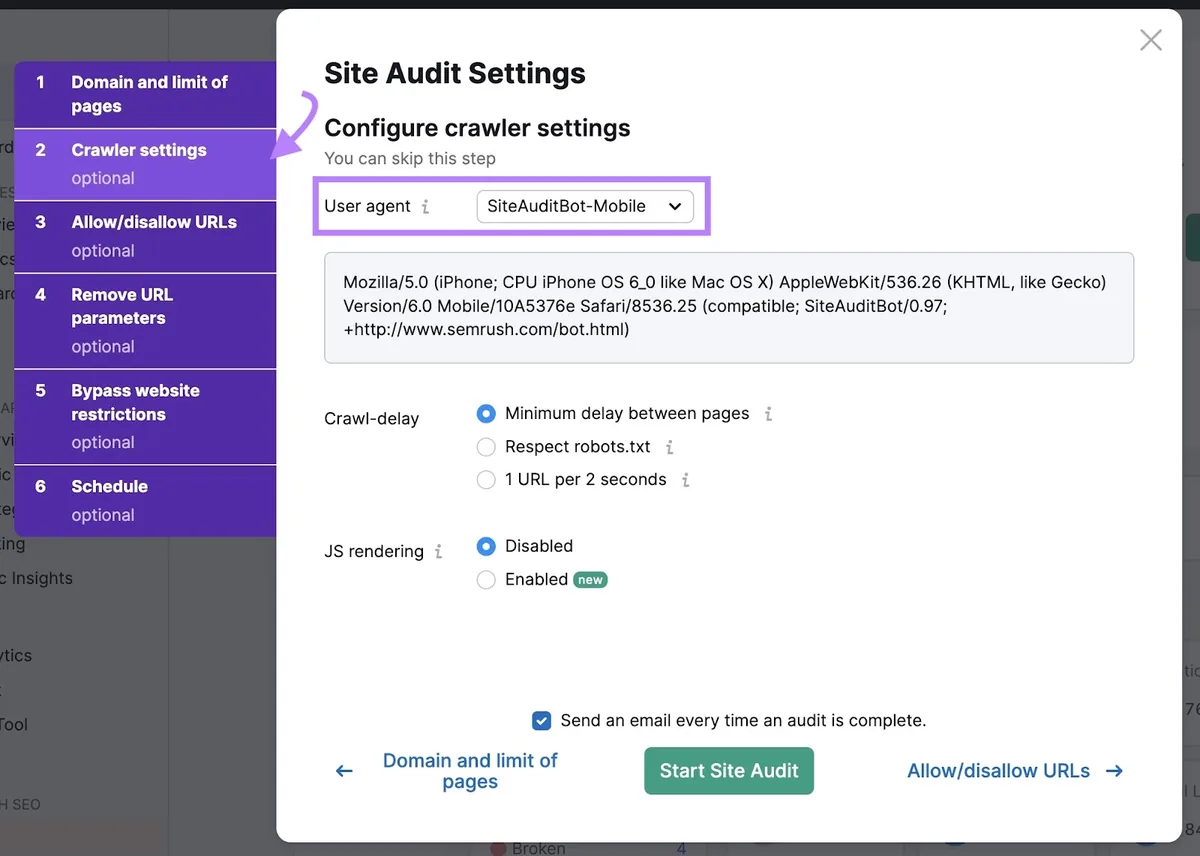
查看我们的Site Audit 配置指南,了解如何自定义审计的更多细节。
准备好后,点击“开始网站审计(Start Site Audit)”。
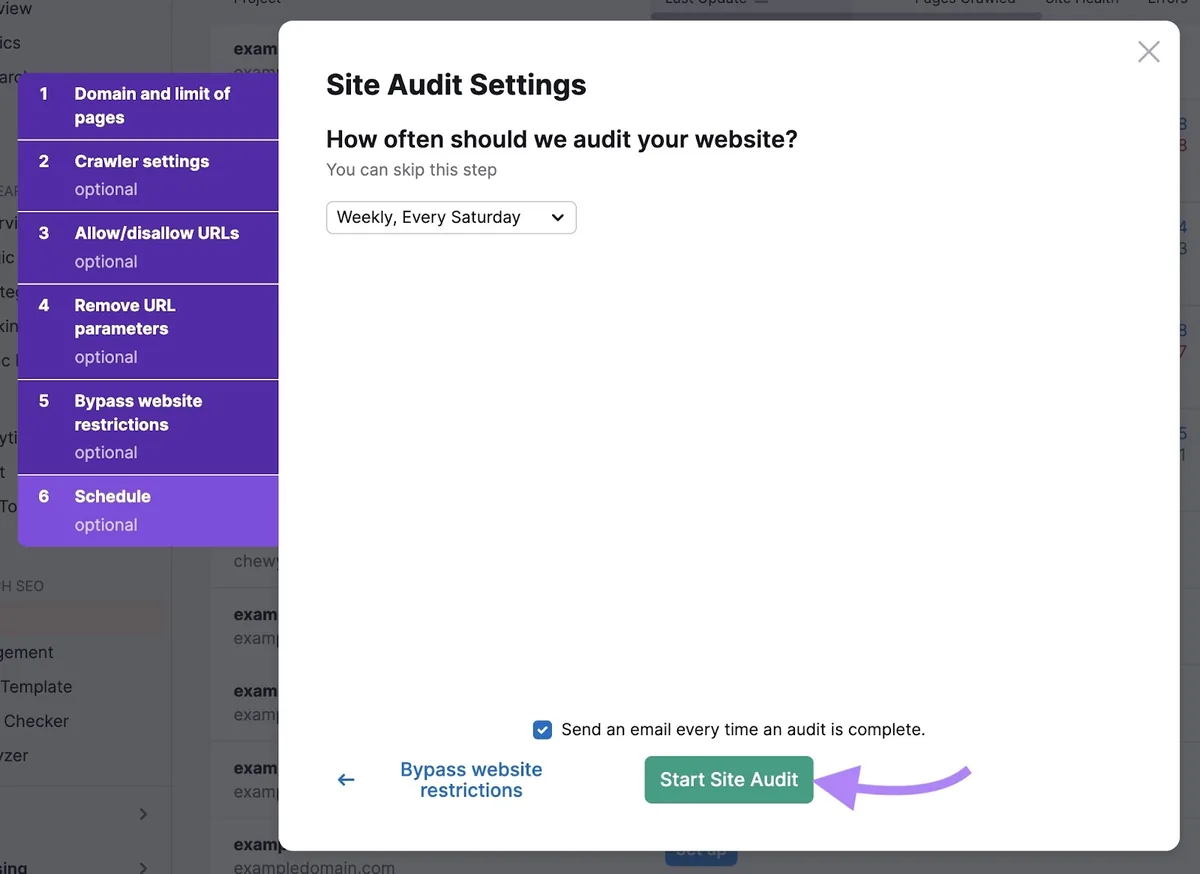
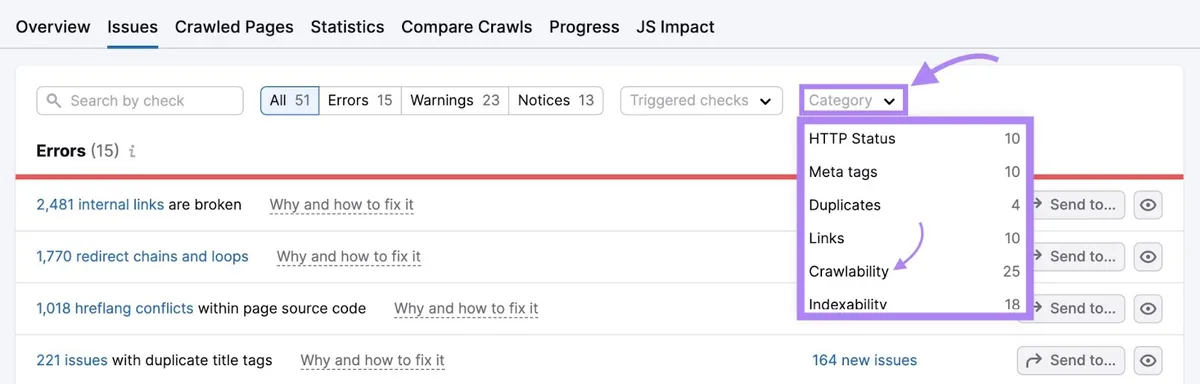
随后会看到如下所示的概览页面。进入“问题(Issues)”标签页。
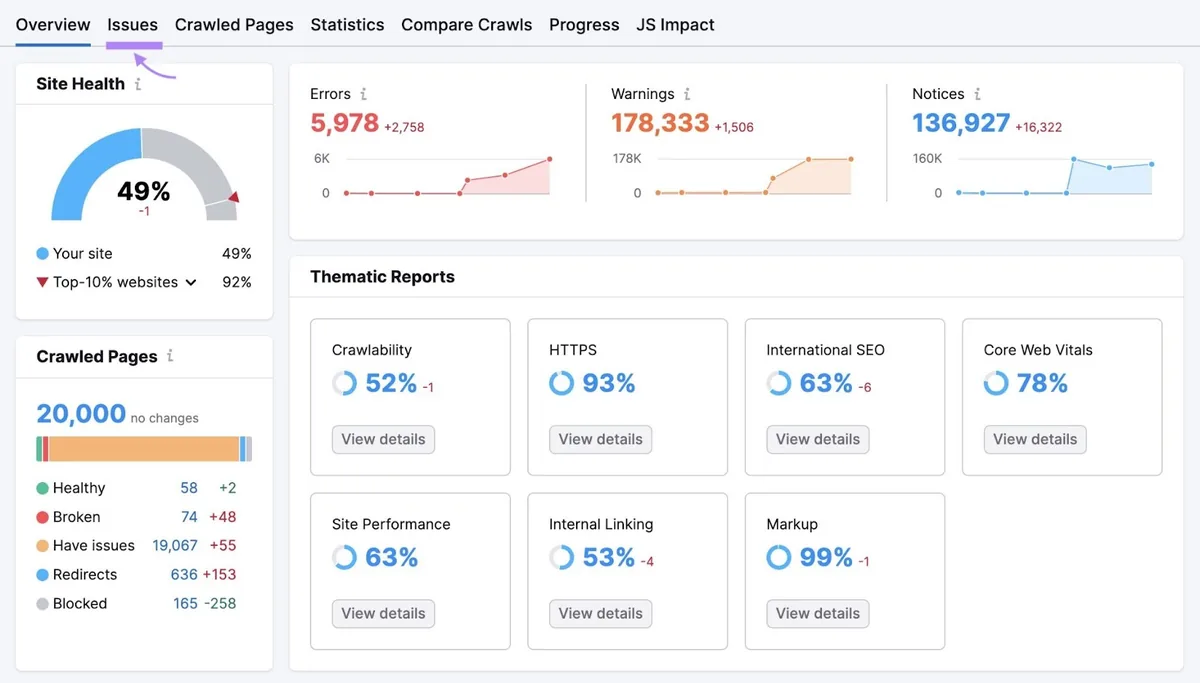
在这里会看到影响网站健康度的错误、警告和提示的完整列表。
点击“类别(Category)”下拉菜单并选择“可抓取性(Crawlability)”,以筛选错误。
不确定某个错误意味着什么、该如何处理?
点击任意一行旁边的“为何出现及如何修复(Why and how to fix it)”或“了解更多(Learn more)”,即可查看该问题的简要说明和解决技巧。
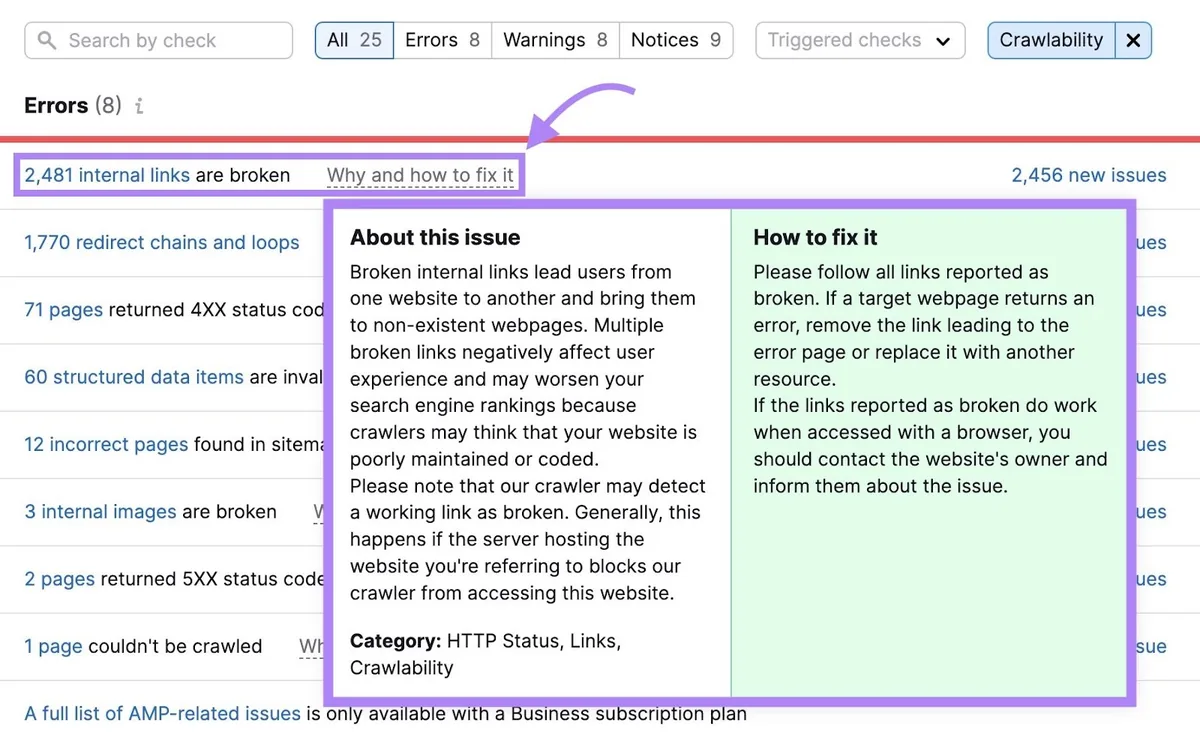
逐一排查并修复每个问题,让 Googlebot 更轻松地抓取网站。
索引内容
Googlebot 抓取内容后,会把它送去进行索引评估。
索引是分析页面以理解其内容的过程,同时评估相关性和质量等信号,以决定是否应将其加入 Google 的索引。
Google 的 Gary Illyes 是这样解释这一概念的:
在这个过程中,Google 会处理(检查)页面的内容,并尝试判断该页面是否是互联网上另一个页面的副本,以便选择在搜索结果中展示哪个版本。
一旦 Google 过滤掉重复内容并评估了内容质量等相关信号,就可能决定索引该页面。
然后,Google 的算法会执行流程中的排名阶段,以决定内容是否出现、以及出现在搜索结果的哪个位置。
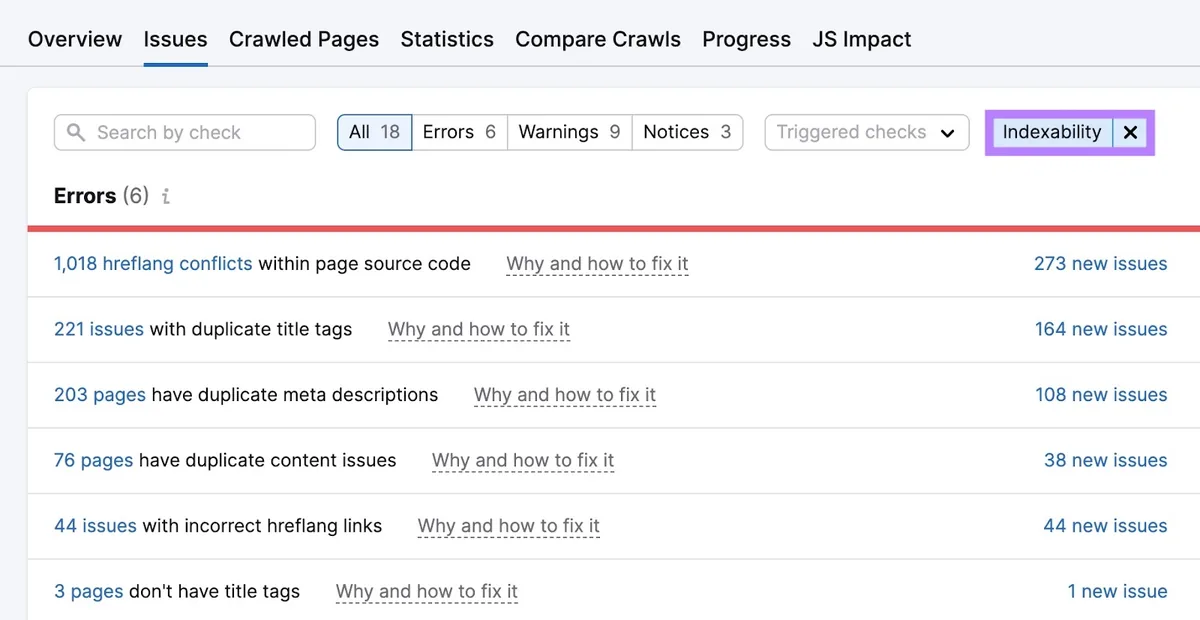
在“问题(Issues)”标签页中,筛选“可索引性(Indexability)”。先处理错误——可以自行处理,也可以借助开发者处理。然后再处理警告和提示。
延伸阅读:可抓取性与可索引性:它们是什么,以及如何影响 SEO
如何监测 Googlebot 的活动
定期检查 Googlebot 的活动,能及时发现任何可索引性和可抓取性问题,并在网站的自然可见度下滑之前加以解决。
有以下两种做法:
使用 Google Search Console 的抓取统计报告
使用 Google Search Console 的“抓取统计(Crawl stats)”报告,概览网站的抓取活动,包括抓取错误和平均服务器响应时间等信息。
要访问报告,登录 Google Search Console 资源,从左侧菜单进入“设置(Settings)”。
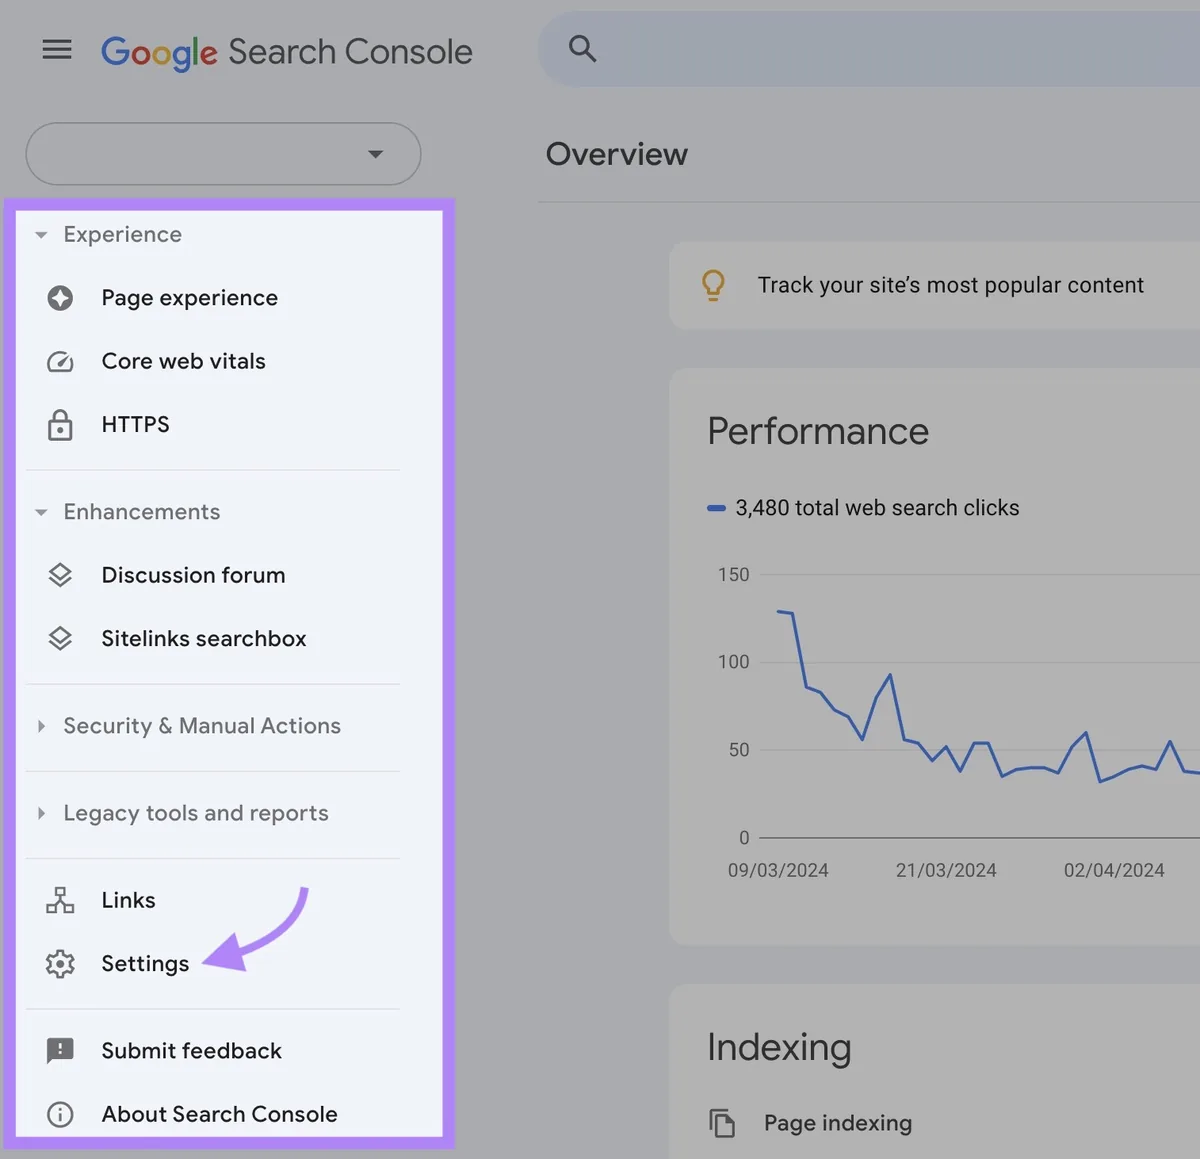
向下滚动到“Crawling(抓取)”部分。然后点击“Crawl stats(抓取统计)”一行中的“打开报告(Open Report)”按钮。
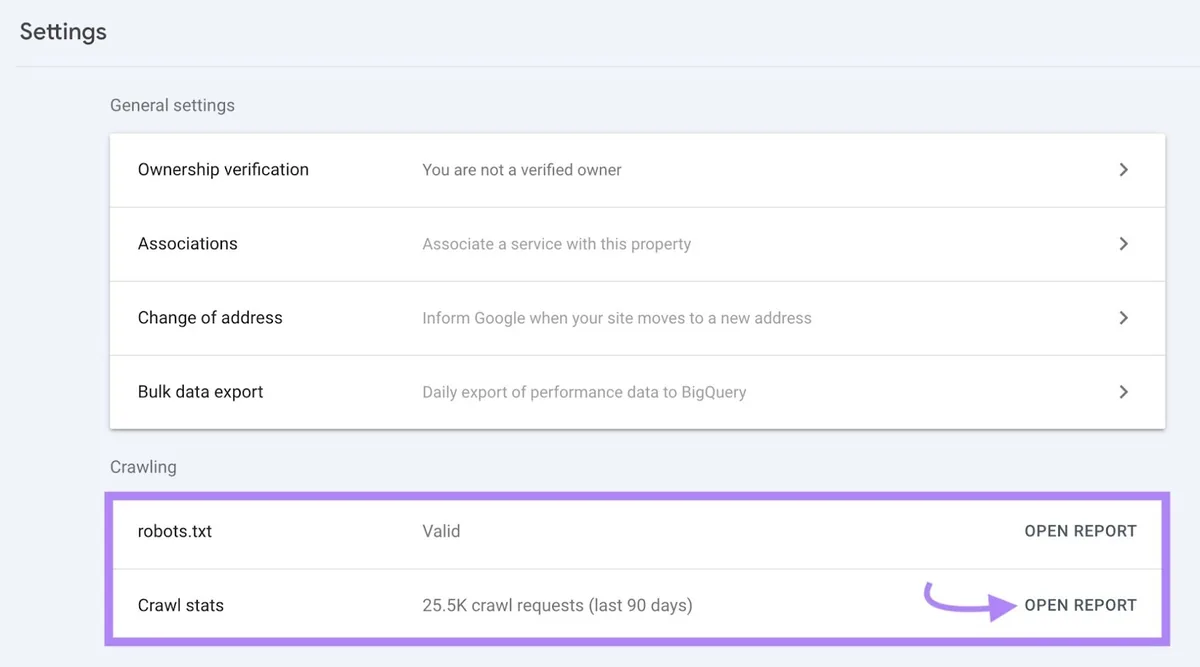
会看到三张抓取趋势图表,就像这样:
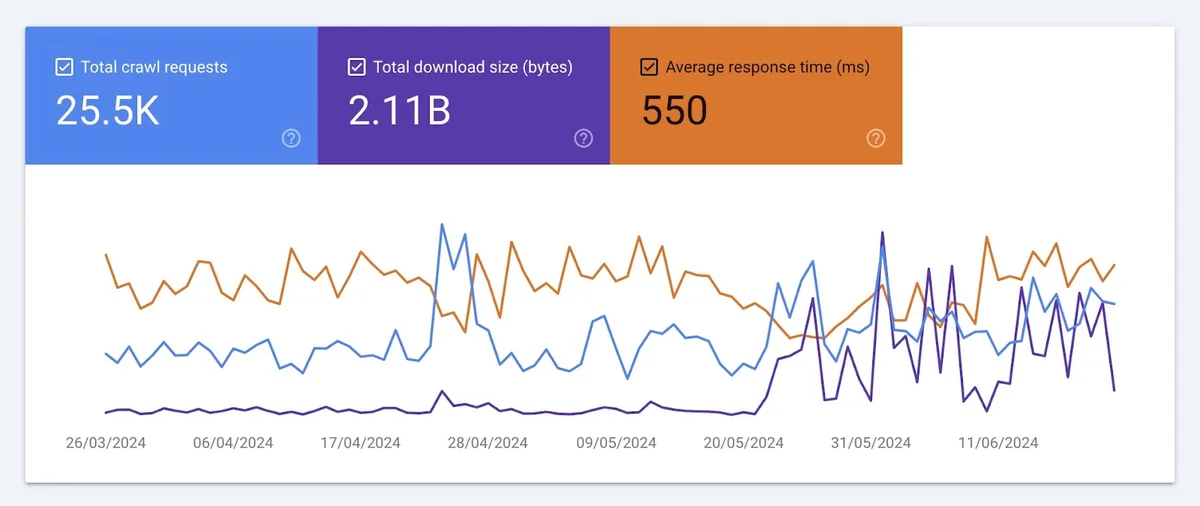
这些图表展示了三项指标随时间的变化:
- 抓取请求总数:Google 的爬虫(如 Googlebot)在过去三个月内发出的抓取请求数量
- 下载总大小:Google 爬虫在抓取网站时下载的字节数
- 平均响应时间:服务器响应一次抓取请求所需的时间
留意每张图表中明显的下降、激增和趋势变化,并与开发者一起发现和解决任何问题,比如服务器错误或网站结构的变化。
“抓取请求明细(Crawl requests breakdown)”部分按响应、文件类型、目的和 Googlebot 类型对抓取数据进行了分组。
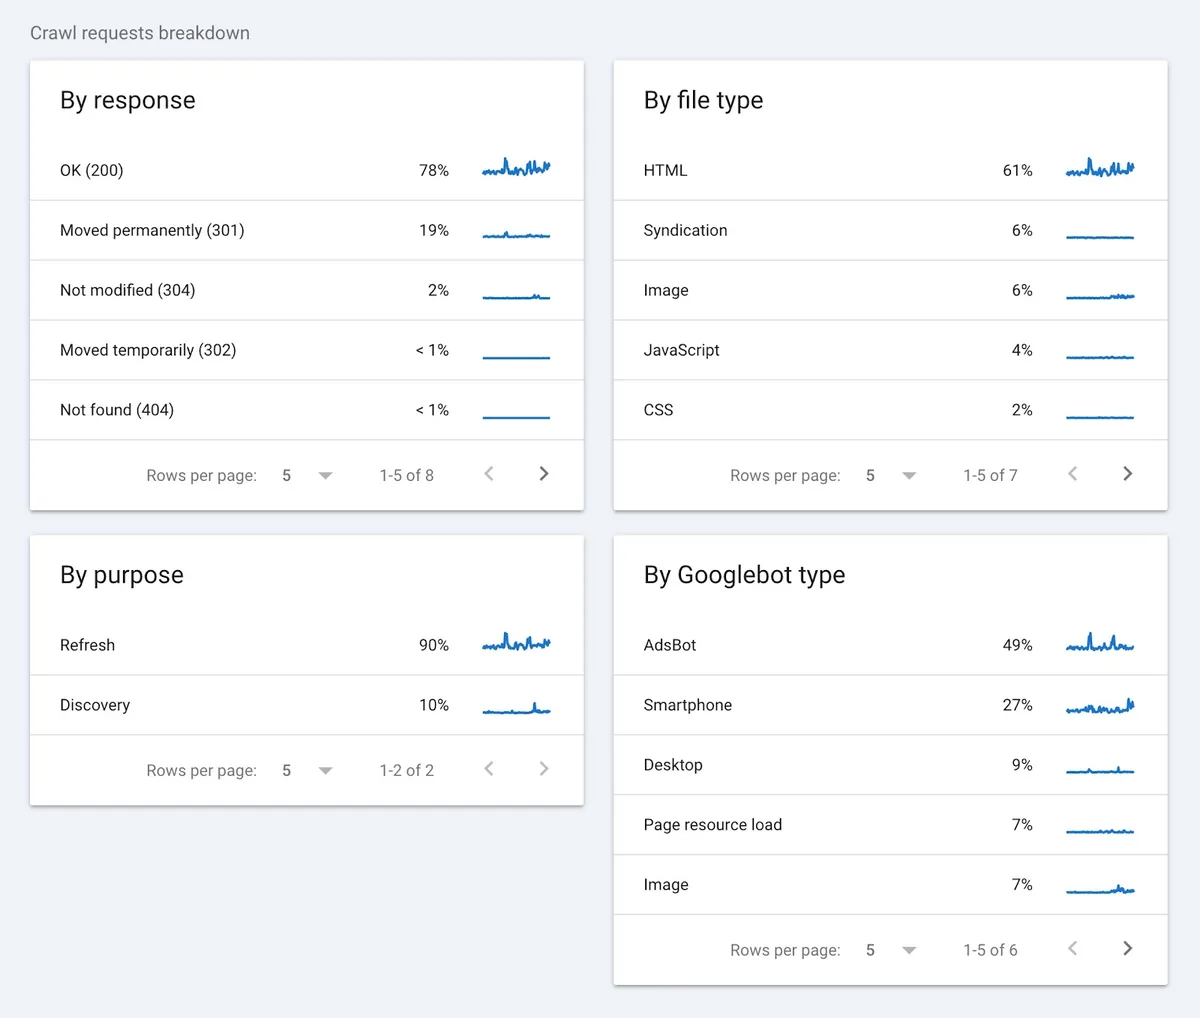
这些数据能告诉你以下信息:
- 按响应:展示服务器如何处理 Googlebot 的请求。高比例的“OK (200)”响应是个好迹象,意味着大多数页面都可访问。反之,404 或 301 等错误可能意味着存在失效链接或内容已迁移,这些是可能需要修复的。
- 按文件类型:告诉你 Googlebot 正在抓取的文件类型。这有助于发现与特定文件类型(如图片或 JavaScript)相关的问题。
- 按目的:指出抓取的原因。较高的发现占比表明 Google 正在投入资源寻找新页面。较高的刷新数值意味着 Google 在频繁检查现有页面。
- 按 Googlebot 类型:展示哪些 Googlebot 用户代理正在抓取网站。如果注意到抓取量激增,开发者可以检查用户代理类型,判断是否存在问题。
分析你的日志文件
日志文件是记录浏览器、人和其他机器人向服务器发出的每一次请求详情,以及它们如何与网站互动的文档。
通过查看日志文件,可以找到如下信息:
- 访客的 IP 地址
- 每次请求的时间戳
- 被请求的 URL
- 请求的类型
- 传输的数据量
- 用户代理,即爬虫机器人
日志文件长这样:
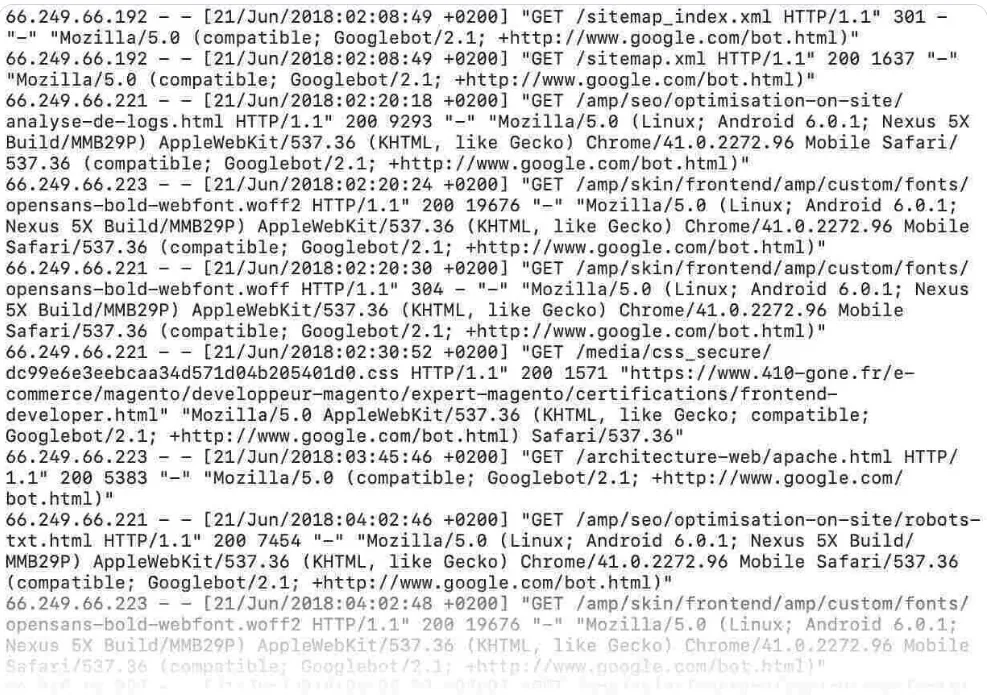
分析日志文件能更深入地了解 Googlebot 的活动,并识别抓取问题、Google 抓取网站的频率,以及网站对 Google 的加载速度等细节。
日志文件保存在网络服务器上,因此要下载和分析,首先需要访问服务器。
有些托管平台内置了文件管理器,可以在这里查找、编辑、删除和添加网站文件。
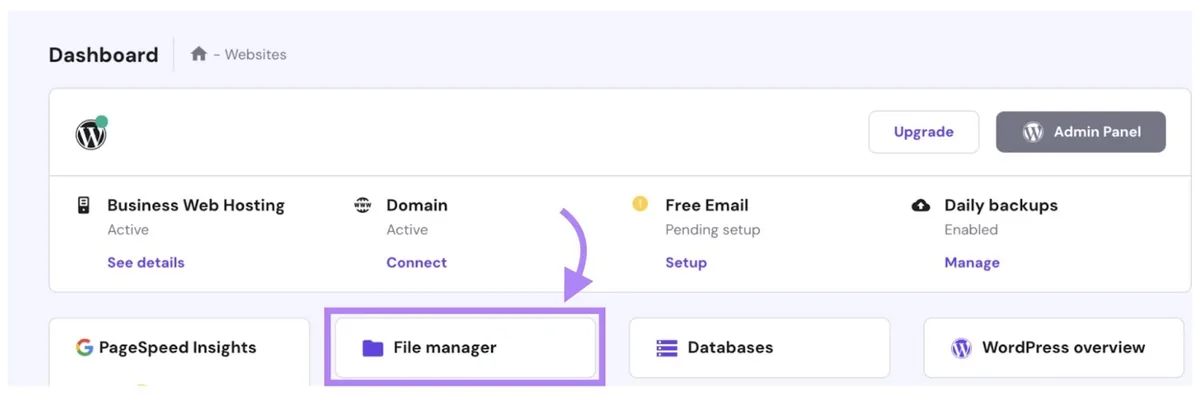
或者,开发者或 IT 专员也可以使用 FileZilla 这类文件传输协议(FTP)客户端下载日志文件。
拿到日志文件后,使用 Semrush 的 Log File Analyzer 来理解这些数据,并回答以下问题:
- 被抓取最多的页面有哪些?
- 哪些页面没有被抓取?
- 抓取过程中发现了哪些错误?
打开该工具,把日志文件拖放进去。然后点击“开始日志文件分析(Start Log File Analyzer)”。
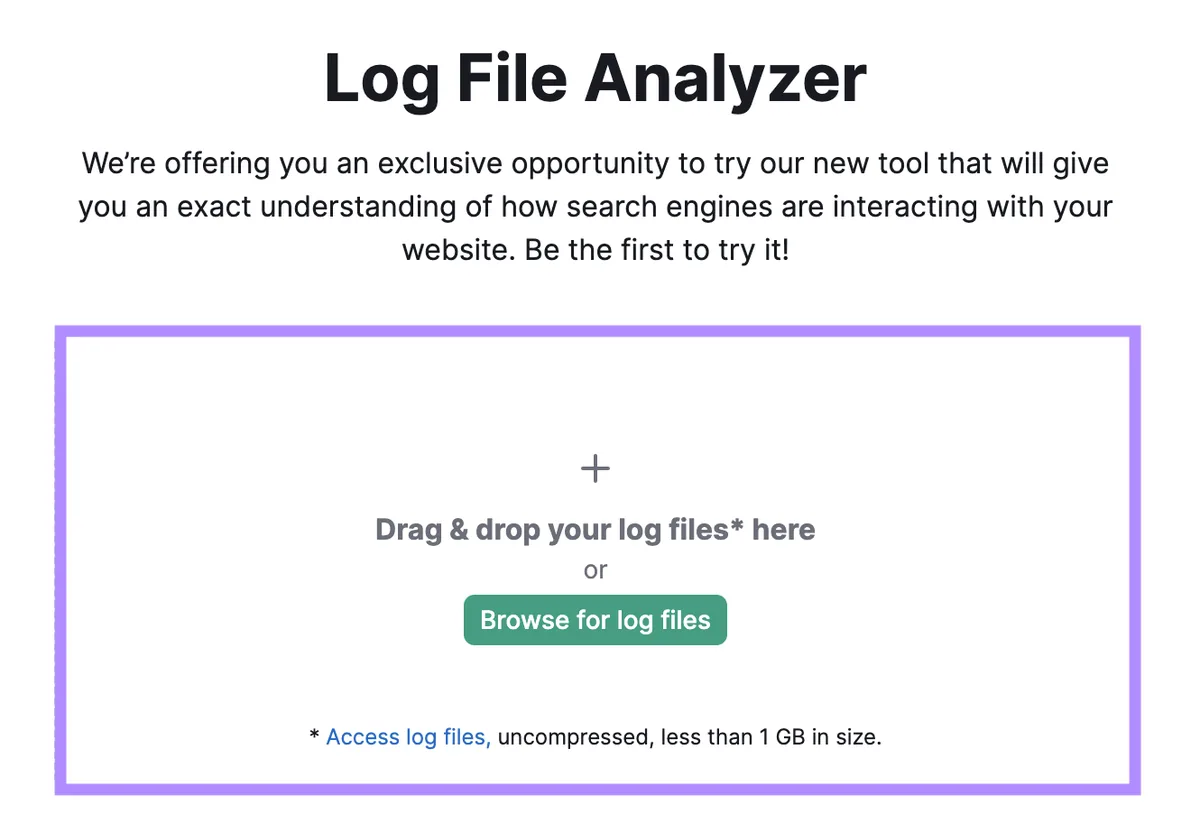
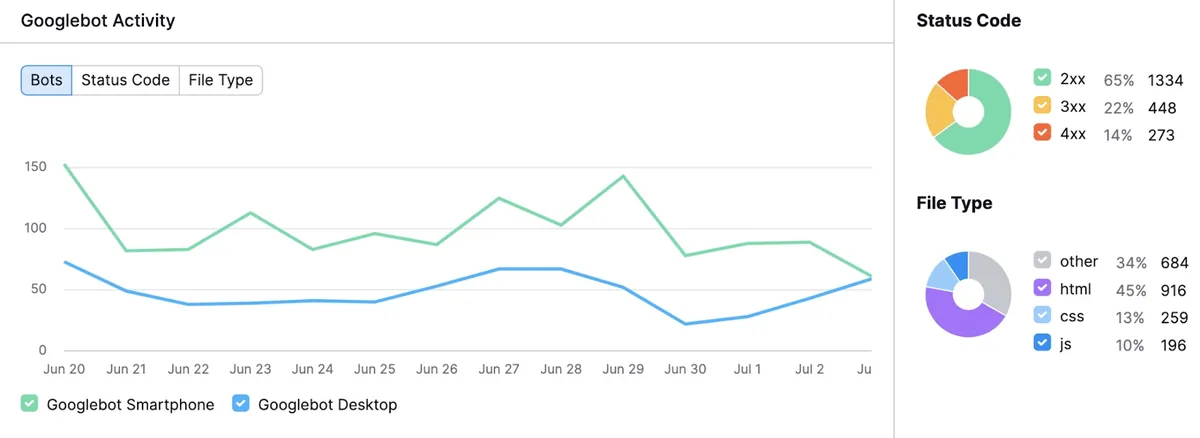
结果准备好后,会看到一张图表,展示过去 30 天内 Googlebot 在网站上的活动。这有助于发现异常的激增或下降。
还会看到不同状态码和所请求文件类型的明细。
向下滚动到“Hits by Pages(按页面统计的命中)”表格,获取单个页面和文件夹的更具体洞察。
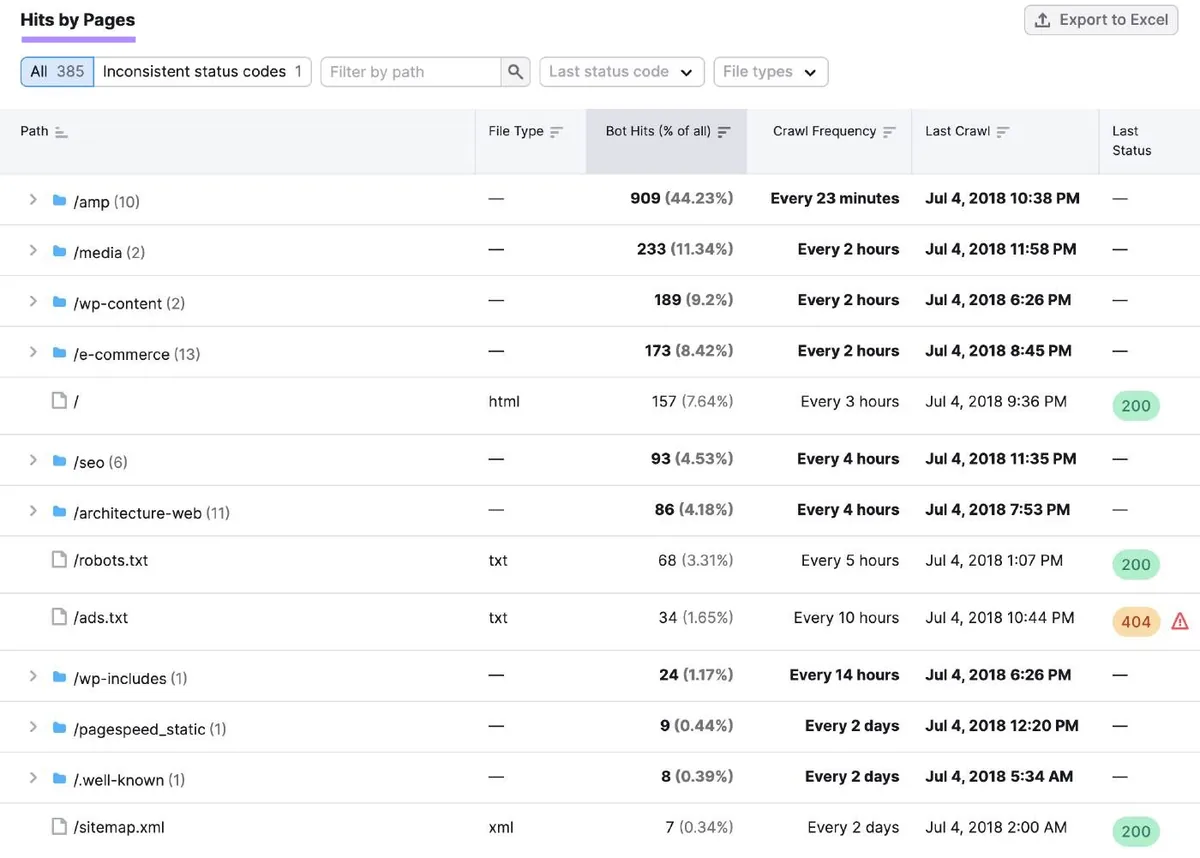
可以用这些信息寻找响应码中的规律,并排查可用性问题。
例如,多个页面上错误码(如 404 或 500)突然增多,可能表明服务器出现问题,导致大面积宕机。
随后可以联系网站托管服务商,帮助诊断问题并让网站恢复正常。
如何屏蔽 Googlebot
有时可能需要阻止 Googlebot 抓取和索引网站的整个部分,甚至特定页面。
原因可能是:
- 网站正在维护,不希望访客看到不完整或损坏的页面
- 想让 PDF 或视频等资源不被索引、不出现在搜索结果中
- 想让某些页面不公开,比如内网或登录页面
- 需要优化抓取预算,确保 Googlebot 聚焦于最重要的页面
有以下三种做法:
Robots.txt 文件
robots.txt 文件是一组指令,用来告诉 Googlebot 等搜索引擎爬虫,网站中哪些页面或部分应该抓取、哪些不应该。
它有助于管理爬虫流量,并能防止网站因请求过多而不堪重负。
下面是一个 robots.txt 文件的示例:
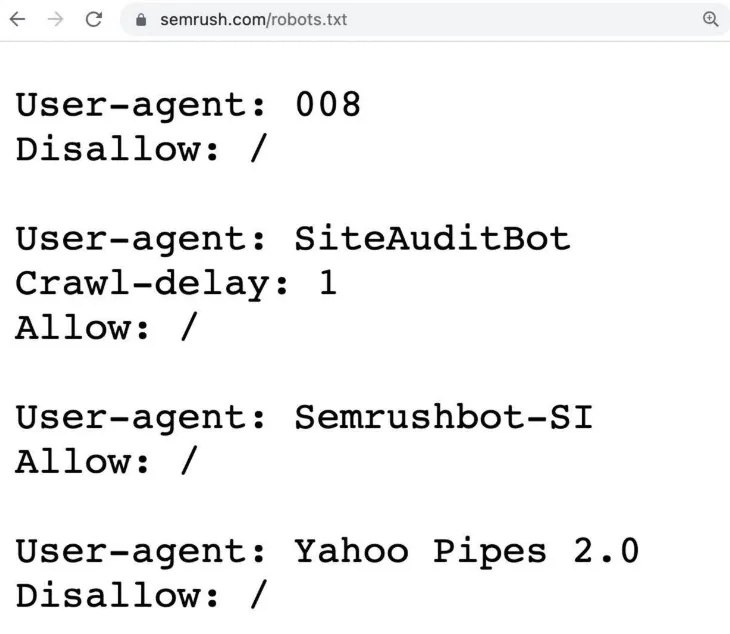
例如,可以添加一条 robots.txt 规则,阻止爬虫访问登录页面,从而让服务器资源集中在网站更重要的部分。
就像这样:
延伸阅读:Robots.txt:什么是 Robots.txt,以及它为何对 SEO 重要
不过,robots.txt 文件并不一定能阻止页面进入 Google 的索引。因为 Googlebot 仍可能发现这些页面(例如有其他页面链接到它们),那么它们仍可能被索引并显示在搜索结果中。
如果不希望某个页面出现在 SERP 中,请使用元机器人标签(meta robots tags)。
元机器人标签(Meta Robots Tags)
元机器人标签是一段 HTML 代码,可以控制单个页面被抓取、索引以及在 SERP 中显示的方式。
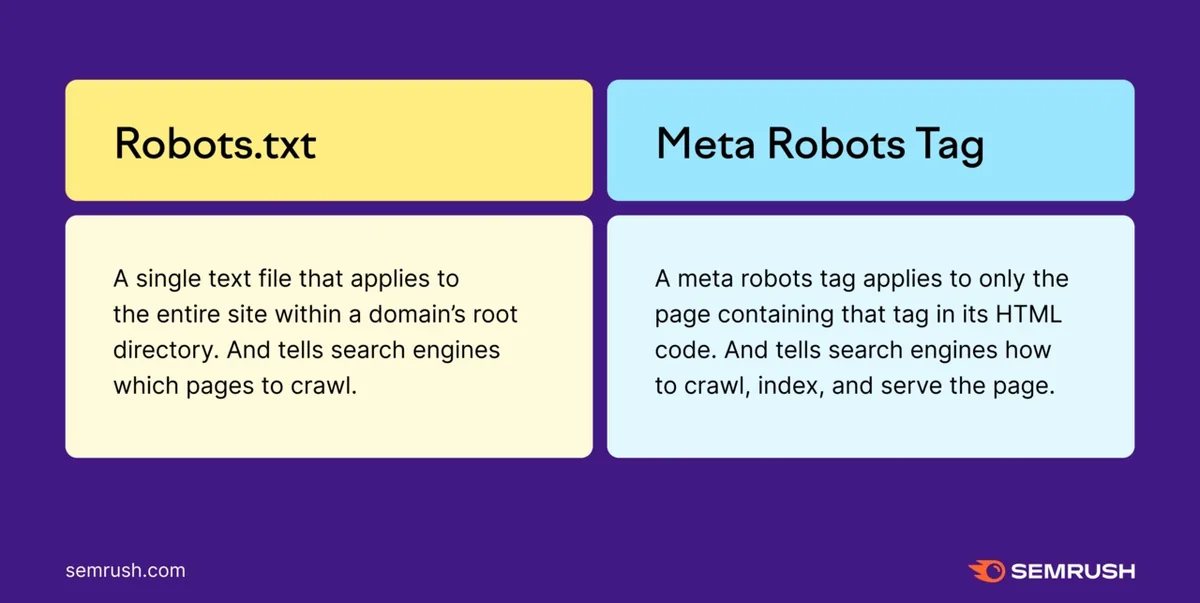
以下是一些机器人标签的示例及其指令:
- noindex:不要索引此页面
- noimageindex:不要索引此页面上的图片
- nofollow:不要跟踪此页面上的链接
- nosnippet:不要在搜索结果中显示此页面的摘要或描述
可以把这些标签添加到页面代码的 <head> 部分。例如,要阻止 Googlebot 索引页面,可以添加 noindex 标签。
就像这样:
这个标签会阻止 Googlebot 在搜索结果中显示该页面,即使有其他网站链接到它。
延伸阅读:元机器人标签与 X-Robots-Tag 详解
密码保护
如果要同时阻止 Googlebot 和用户访问某个页面,请使用密码保护。
这种方法确保只有获授权的用户才能查看内容,并防止该页面被 Google 索引。
可能需要设置密码保护的页面示例包括:
- 管理后台
- 私密会员专区
- 公司内部文档
- 网站的预发布版本
- 机密项目页面
如果设置为密码保护的页面已经被索引,Google 最终会将其从搜索结果中移除。
让 Googlebot 轻松抓取你的网站
SEO 有一半的功夫在于确保页面能出现在 SERP 中,而第一步就是确保 Googlebot 真能抓取页面。
定期监测网站的可抓取性和可索引性,能帮你做到这一点。
获取一份免费的 SEO 审计,看看当前处境。要发现全站范围的问题,请使用 Semrush Site Audit。
该工具可以按需抓取,并且可以按天或按周安排自动重新抓取,让你始终掌握网站的健康状况。
今天就试试吧。