孤立页面:如何查找、修复与预防
接手历史悠久的网站时,历届代理机构遗留的技术性错误往往会拖累 SEO。本文说明如何发现、修复并预防孤立页面。
当毫无防备的 SEO 从业者接手一个历史悠久的老网站时,前方往往布满陷阱。
历届代理机构遗留下来的技术性错误,会拖慢并阻碍 SEO 工作的推进。
被派去收拾这些遗留问题时,找到能快速见效的修复方法是首要任务。
于是可能从一次基础站点审计入手,结果发现不少孤立页面(orphan pages)。你或许听说过孤立页面对网站有害,却不完全清楚其含义与修复方法。
本文将介绍:
什么是孤立页面?
孤立页面指搜索引擎难以发现的页面,因为站内没有任何其他地方链接到它。
这类 URL 常被遗漏,因为搜索引擎爬虫只能通过站点地图文件或外部反向链接发现页面,而用户需要知道 URL 才能访问。
孤立页面是如何产生的?
孤立页面通常由意外产生,原因多样,最常见的是在网站迁移、导航调整、网站改版、产品缺货、测试或开发页面等环节缺乏规范流程。
孤立页面也可能是有意为之,例如促销页面、付费广告落地页,或任何不希望出现在用户访问路径中的页面。
为什么孤立页面对 SEO 有害?
搜索引擎很难找到孤立页面,因为它们依靠链接发现新内容并判断页面的重要程度。
Google 的解释如下:
Google 使用称为爬虫的自动化程序搜索网络,寻找新增或更新的页面。[……] 我们通过多种方法发现页面,但主要方法是沿着已知页面上的链接进行跟踪。
例如,发布一个新网页却忘了在站内其他地方链接到它。若该页面既不在站点地图中,也没有反向链接,Google 就不会发现或索引它,因为其爬虫根本不知道该页面存在。
更糟的是,该页面无法获得 PageRank。
若此前未听过“PageRank”,需了解它的重要性。
一般而言,PageRank 是 Google 通过统计页面获得的“投票”数量来判断其重要程度的方式。想深入了解 PageRank 的运作及其对 SEO 的影响,可参阅此处。
如何查找孤立页面
要找出网站上的孤立页面,需把可抓取的 URL 列表(Google 能找到的)与用户实际访问的 URL 列表进行比对。
这听上去颇为技术化,但无需退缩。我们已将查找孤立页面的过程拆解为三个步骤,且都使用常见工具。
1. 找出可抓取的 URL
汇总可抓取 URL 的工具不少。我们使用 Ahrefs 的 Site Audit,因为它凭 Ahrefs Webmaster Tools 账户即可完全免费使用,且可选择把外部反向链接作为来源,从而发现更多 URL。
具体做法如下:
- 打开 Site Audit。
- 点击 + New Project(新建项目)。
- 按提示操作至第 3 步。点击 URL sources(URL 来源)选项卡,在默认设置之外再勾选 Backlinks(反向链接)作为 URL 来源。
- 点击 Continue(继续),按说明完成设置,随后运行抓取。
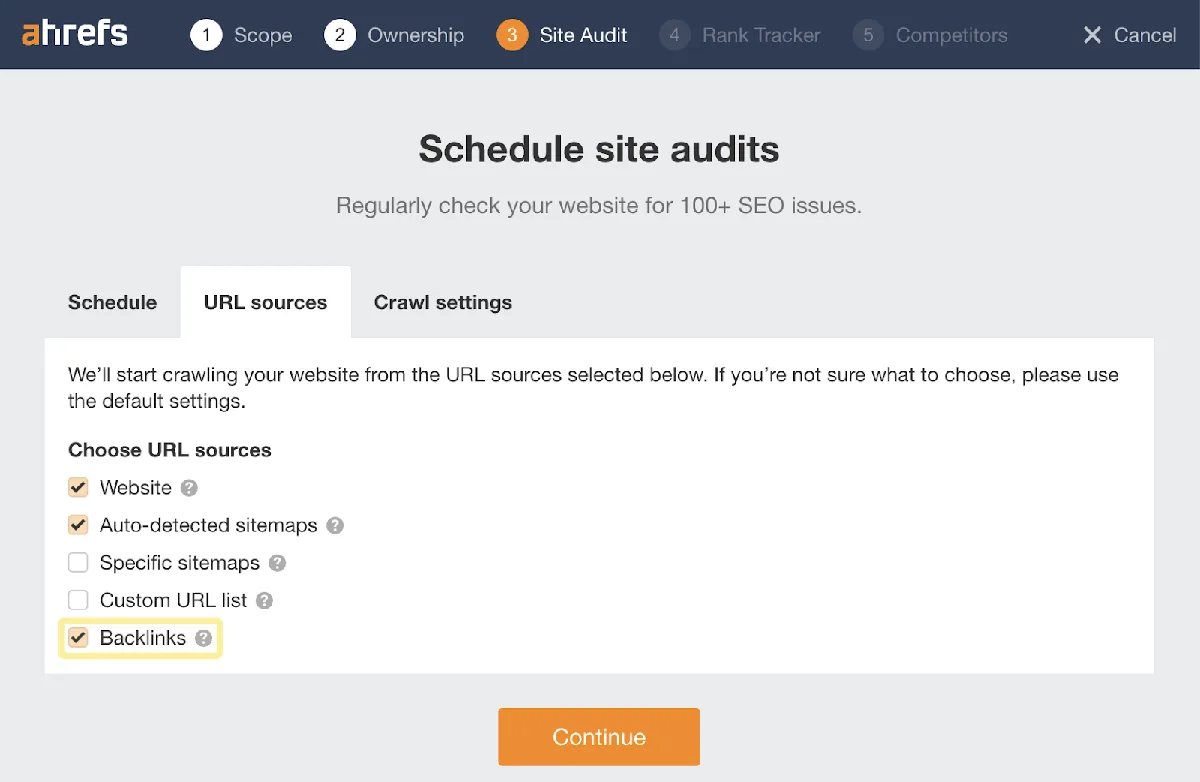
反向链接数据对查找孤立页面很有帮助,因为它把 Ahrefs 链接索引中的 URL 也纳入其中。
若页面没有任何内链,基础爬虫便无法找到它。
但若页面有反向链接,Ahrefs 就能在网站上找到该 URL,并发现抓取时没有任何内链,因此它必定是孤立页面。
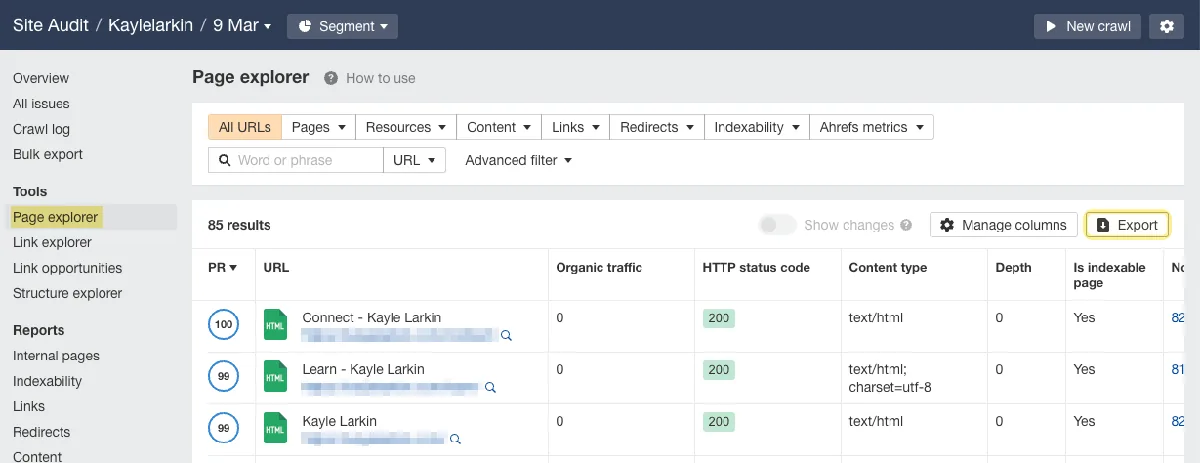
站点审计完成后,从 Page Explorer(页面浏览器)导出所有内页并保存,第 3 步会用到。
2. 找出有访问量的 URL
下一步是获取网站上所有有访问量的 URL 列表。
实现方法不少,最佳做法是尽量用上所有可访问的数据源。
若有权限,日志文件效果很好,因为它是服务端数据,更为准确。本文不深入讲解日志文件的获取方式,因为这取决于服务器配置。
若选择这条路径,以下为针对常见服务器类型的三个官方指南:
- 访问 Apache 日志文件(Linux)
- 访问 NGINX 日志文件(Linux)
- 访问 IIS 日志文件(Windows)
本文使用 Google Analytics(GA4)与 Google Search Console,因为流程对所有人都基本一致。也可尝试 Ahrefs 的 Web Analytics——一个简单、注重隐私的 GA 替代方案。
在 Google Analytics(GA4)中查找有访问量 URL 的方法如下:
- 登录你的 Data Studio 账户。
- 新建一个空白报告。
- 将 Google Analytics 连接为数据源。
- 选择你要分析的账户 > 选中 GA4 媒体资源(property)。
- 在报告里添加一个基础表格。
- 把数据源设置为第 4 步创建的 GA4 媒体资源。
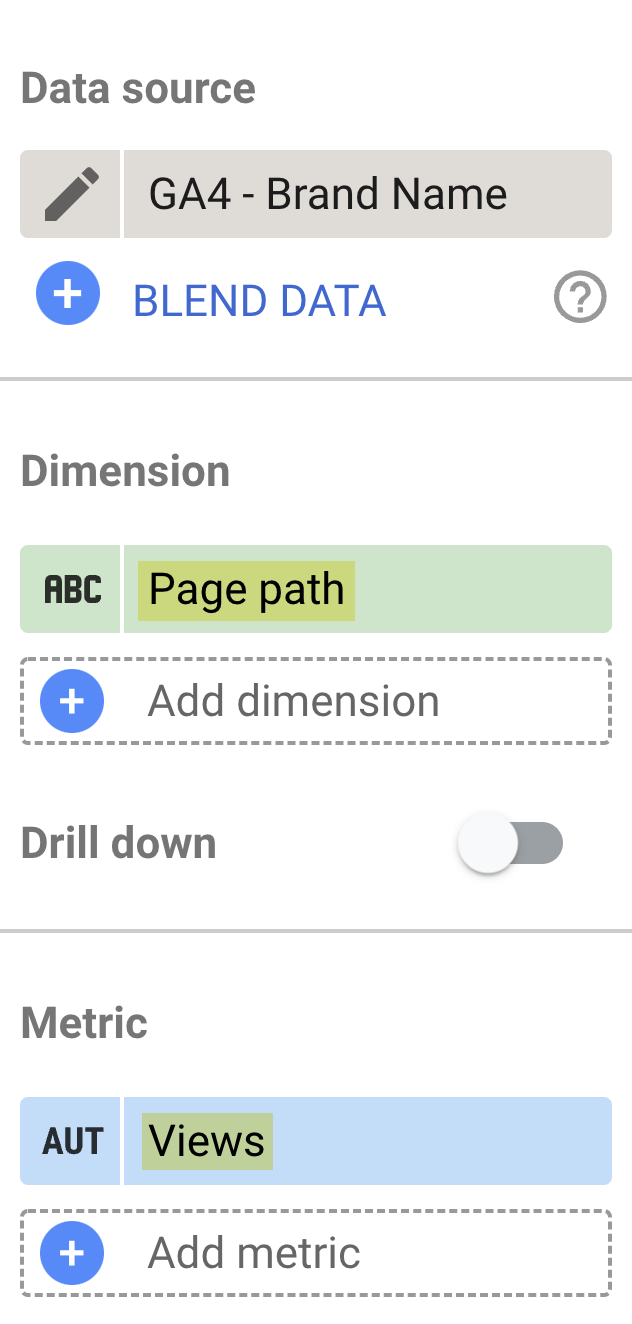
- 把维度设置为 Page path(页面路径)。
- 把指标设置为 Views(浏览量)。
- 按 Views 降序排序。
- 将默认日期范围设为网站安装 GA4 之前的时间段。
要导出表格结果,点击右上角的三个竖点,再点击 Export(导出)。保存时取一个有用的名称,如“日期_GA_用户访问的URL_品牌名”,稍后还会用到。
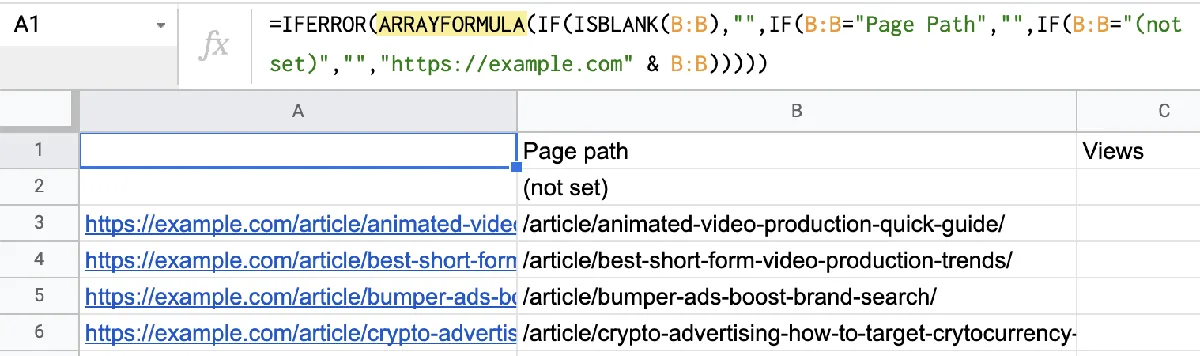
由于导出的是页面路径而非完整页面 URL,需要在表格中为所有单元格开头补上域名。这在 Google Sheets 中很简单:把 CSV 导入一张空白工作表,在左侧插入一个新列,再将以下公式粘贴到单元格 A1(记得把 example.com 替换为你自己的域名):
[['Text', '=IFERROR(ARRAYFORMULA(IF(ISBLANK(B:B),"",IF(B:B="Page Path","",IF(B:B="(not set)","","https://example.com" & B:B)))))']]
由于 URL 来源越多越好,我们还会从 Google Search Console(GSC)拉取数据。
GSC 导出仅限前 1,000 个 URL,但 Google Data Studio 有个小技巧可以拉取更多。
具体做法如下:
- 重新打开你的 Data Studio 报告。
- 新建一个页面(command + M)。
- 打开 Resource(资源) > Manage added data sources(管理已添加的数据源)。
- 点击 ADD A DATA SOURCE(添加数据源)。
- 选择 Search Console。
- 选择你要分析的网站 > URL impression(URL 展示) > web。
- 在报告里添加一个基础表格。
- 把维度设置为 Landing page(落地页)。
- 把指标设置为 Impressions(展示次数)。
- 将每页行数扩展到 5,000。
- 编辑日期范围,至少查看过去三个月。
- 导出表格结果。
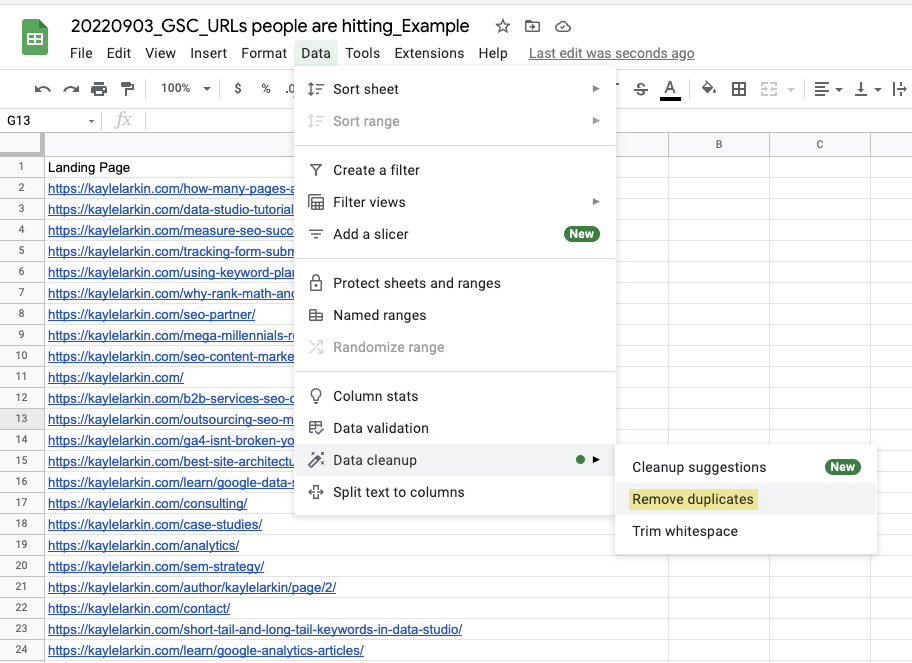
3. 交叉比对两个 URL 来源
最后一步是把可抓取 URL(来自 Ahrefs 的 Site Audit)与有访问量 URL(来自 GA 与 GSC)进行交叉比对。为此新建一个空白 Google 表格,创建三个工作表标签,分别命名为 crawl、hits 和 cross reference。

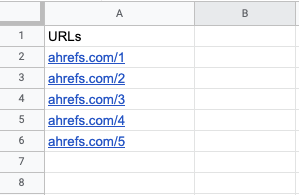
在第一个工作表 crawl 中,粘贴来自 Ahrefs Site Audit 的所有可抓取 URL。
要找出这些 URL,打开第 1 步导出的 CSV,筛选出 incomingAllLinks 等于零的结果。这一环节非常重要,因为这些正是孤立页面,若放进“crawl”标签会导致交叉比对结果不准确。
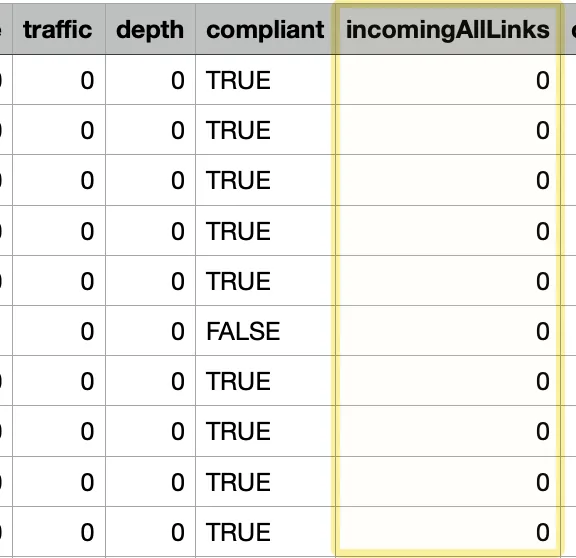
应改为把这些 URL 复制出来,添加到“hits”标签。
接着,把 Ahrefs 导出结果中剩余的 URL 粘贴到 Google 表格的 crawl 标签。
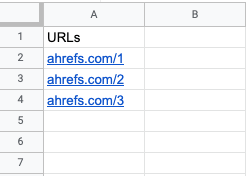
在第二个工作表 hits 中,粘贴第 2 步的所有 URL,即通过 Google Analytics、Google Search Console 或网站日志文件找到的、包含用户访问过的页面。
在第三个工作表 cross reference 中,把以下函数输入到第一个单元格:
[['Text', '=UNIQUE(FILTER(hits!A:A, ISNA(MATCH (hits!A:A, crawl!A:A, 0))))']]
按回车。该函数会自动拉取所有孤立页面,便于分析。
如何修复孤立页面
营销人员常犯的错误,是不加区分地给所有孤立页面添加内链。
问题在于:某个快速修复方案能套用到所有页面,并不意味着就应该这样做。
有些孤立页面是有意保留的,如 PPC 落地页;另一些则可直接删除,如测试页面。
不应把资源浪费在修复没有坏掉、或不太可能产生积极影响的东西上。
为解决这一问题,可使用以下决策树:
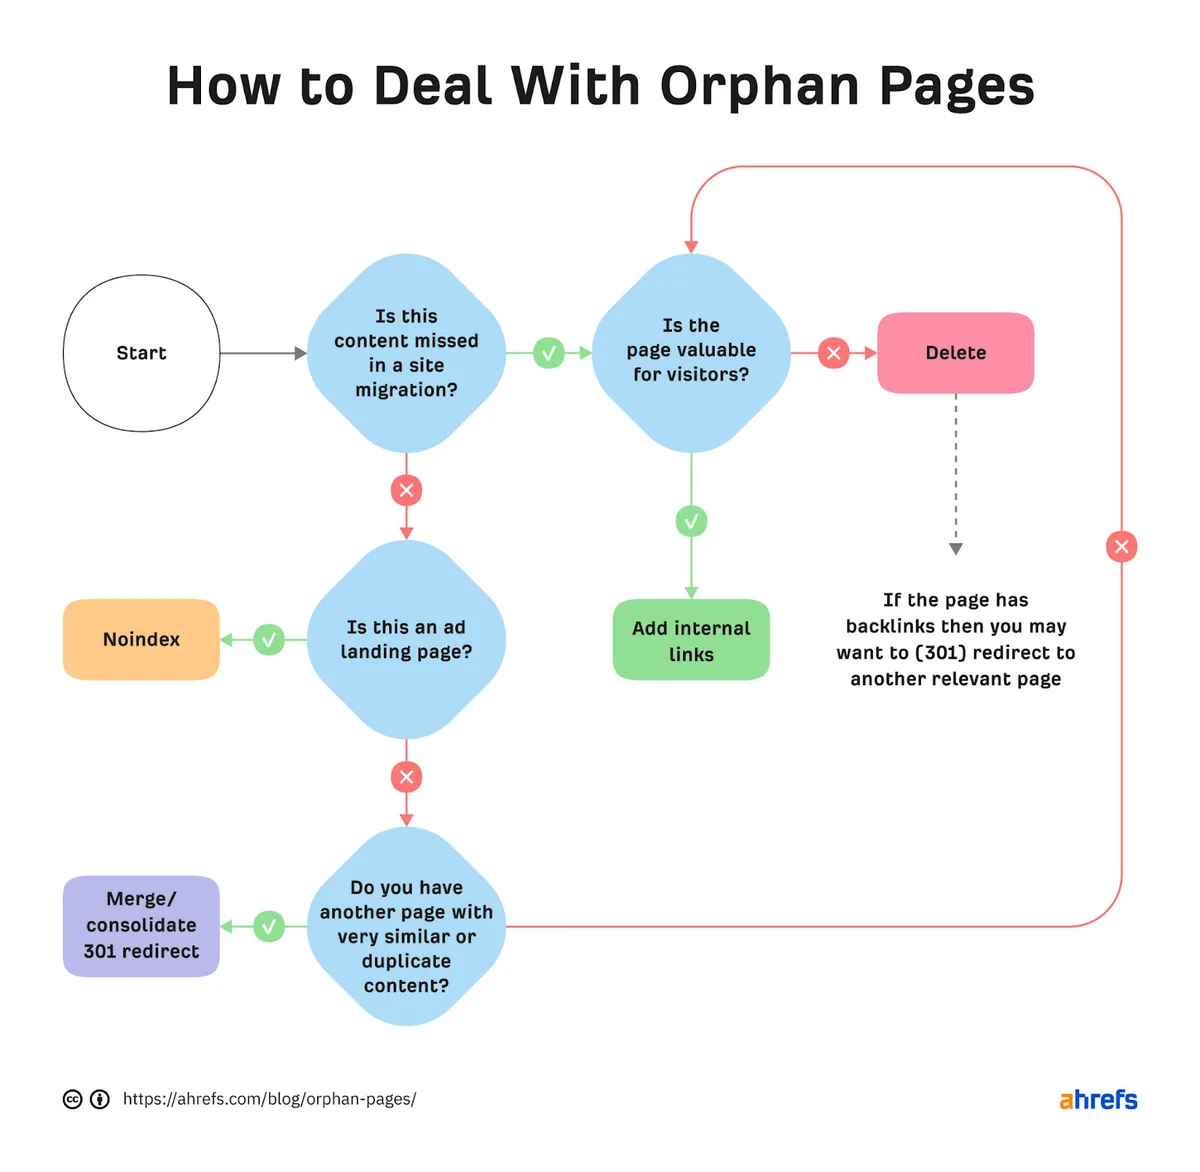
思路是对每个孤立页面进行批判性判断:究竟设为 noindex、删除、合并/整合,还是单纯添加内链才是最合适的修复方式。
例如,若某页面在网站迁移时被遗漏且对访客毫无价值,删除它大概是最佳选择。但若该页面有反向链接,把该 URL 重定向到另一个相关页面以保留外链权重,也可能是值得的。
以下为修复孤立页面的四种策略。
添加内链
对访客有价值的孤立页面应纳入网站内链结构,让访客与搜索引擎都更容易找到。
例如,某篇文章在网站迁移或改版时被遗忘。此时需要从一个确信 Google 很快会(重新)抓取的相关页面内链到它。
在 Ahrefs 中有一个简便方法:
- 打开 Site Audit
- 打开你网站最近一次抓取
- 在 Tools(工具)> 下打开 Page Explorer(页面浏览器)。
- 在 Page text(页面文本)中搜索某个词或词组。
- 按 Organic traffic(自然流量)对结果排序。
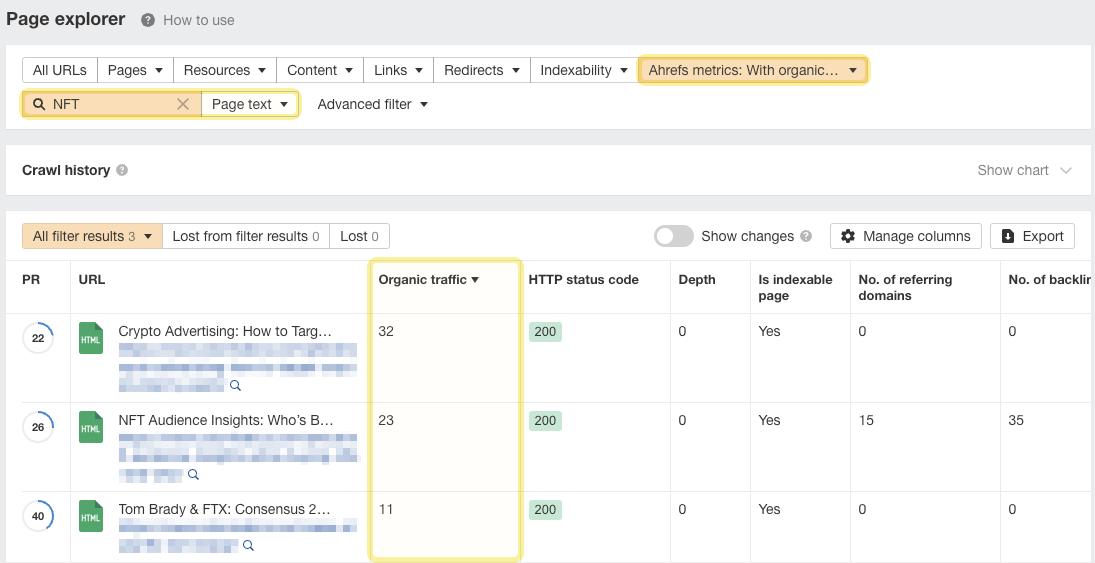
这样就能在获得自然流量的页面上找到相关内链机会,而 Google 很可能会更快重新抓取这些页面,从而看到改动。
了解更多:如何使用 Page Explorer
设为 noindex
有意不加内链的孤立页面(如广告落地页)应设为 noindex,以防出现在自然搜索结果中。
多数 SEO 插件只需勾选一个复选框即可完成,也可手动操作,把以下代码粘贴到页面的 <head> 部分:
[['Text', '<meta name="robots" content="noindex" />']]
合并/整合
与其他页面内容相同或相似的孤立页面应予以合并,即整合其内容,并把孤立页面的 URL 重定向到另一页面。
例如,同一产品你有两个产品页面,其中一个是孤立页面。应把孤立页面上独特有价值的信息提取出来加到另一页面,再把孤立页面重定向到那里。
删除
对访客毫无价值、也无其他用途(如付费流量活动)的孤立页面应删除。
例如,一个未使用的 CMS 主题页面可以移除,这会产生 404 页面,并随时间自然从搜索结果中消失。
如何预防孤立页面
如你所见,审计孤立页面颇为耗时。既然已经投入这份努力,自然希望日后能预防其出现。以下规范与流程值得考虑。
为网站迁移制定计划
每次网站迁移都应主动制定计划。可通过 301 重定向把旧页面指向新版本,避免网站出现死链与混乱。
构建利于成功的网站结构
若必须手动为新页面添加内链,必然会有遗漏,最终产生孤立页面。因此应选择能自动处理内链的网站结构。
多数 CMS 开箱即用即可做到。例如,每次发布新的博客文章时,WordPress 都会在博客首页与归档页自动添加一条内链。
若使用自定义方案,则需确保相关代码到位,以构建良好的网站结构。
了解更多: 网站结构:如何搭建你的 SEO 基础
妥善移除停产产品
若经营电商网站,应把停产产品从目录中移除(连同所有指向它们的内链),并设置 404 或 410 的状态码。未移除指向这类产品的内链,是产生孤立页面的常见原因。
若该页面有优质反向链接,且产品有更新或改进版本,则可考虑保留该页面以保住外链权重。
定期运行站点审计
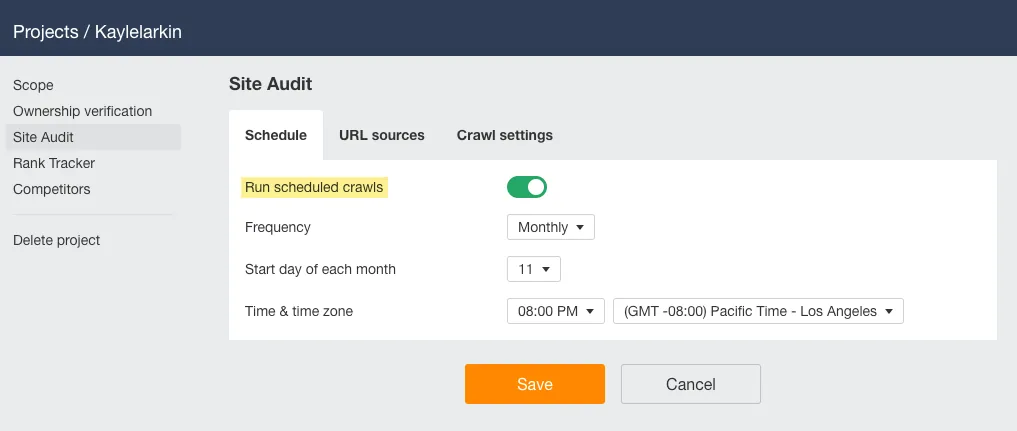
每月运行一次审计,即可及时掌握任何可能被漏掉的意外孤立页面。用 Ahrefs Site Audit 的定时功能即可轻松完成。
结语
面对一行行孤立页面错误,再要弄清那些晦涩的技术术语,确实令人望而生畏。
查找与修复孤立页面虽耗时,却不必苦不堪言。借助 Ahrefs 的 Site Audit 与孤立页面决策流程图,流程会顺畅许多。
如有疑问,可在 Twitter 上联系我。