搜索引擎是如何工作的
搜索引擎依靠网页爬虫抓取数十亿个页面。这些爬虫又称蜘蛛或机器人,在网上四处游走,顺着链接发现新页面;抓取到的页面随后被纳入索引,搜索引擎乃至 ChatGPT 这样的 AI 助手都从索引中提取结果。理解搜索引擎的运作方式,是做好 SEO 的前提。
搜索引擎依靠网页爬虫抓取数十亿个页面。这些爬虫又称蜘蛛或机器人,在网上四处游走,顺着链接发现新页面。抓取到的页面随后被纳入索引,搜索引擎乃至 ChatGPT 这样的 AI 助手都从索引中提取结果。
做 SEO,理解搜索引擎如何运作至关重要。不理解某样东西的工作机制,就很难对它做出优化。
这正是本指南要讲的内容。
搜索引擎基础
先来看搜索引擎是什么、为何存在,以及它们如何盈利。
什么是搜索引擎?
搜索引擎是可检索的网页内容数据库,由两个主要部分构成:
搜索索引。
搜索算法。
搜索引擎的目标是什么?
每个搜索引擎都力求为用户提供最好、最相关的结果,这也是它们赢得市场份额的方式。
搜索引擎如何赚钱?
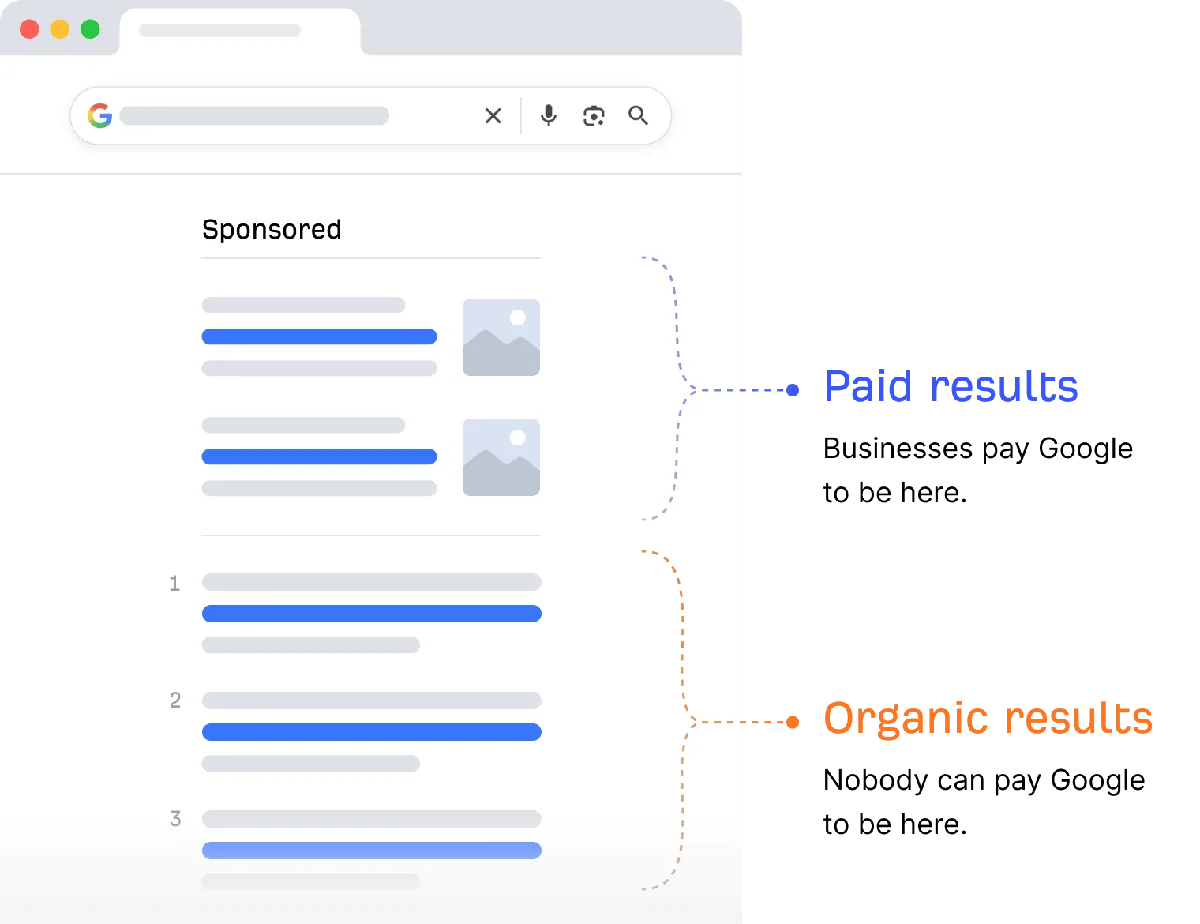
搜索引擎有两类搜索结果:
来自搜索索引的自然结果。
来自广告主的付费结果。
每当有人点击付费搜索结果,广告主就需向搜索引擎付费。这就是按点击付费(PPC)广告,也是市场份额如此重要的原因:用户越多,广告点击越多,收入也就越高。
搜索引擎通过广告赚钱
搜索引擎如何构建索引
每个搜索引擎构建搜索索引的流程各不相同。下面是 Google 所用流程的简化版本。1
Google 如何构建其搜索索引
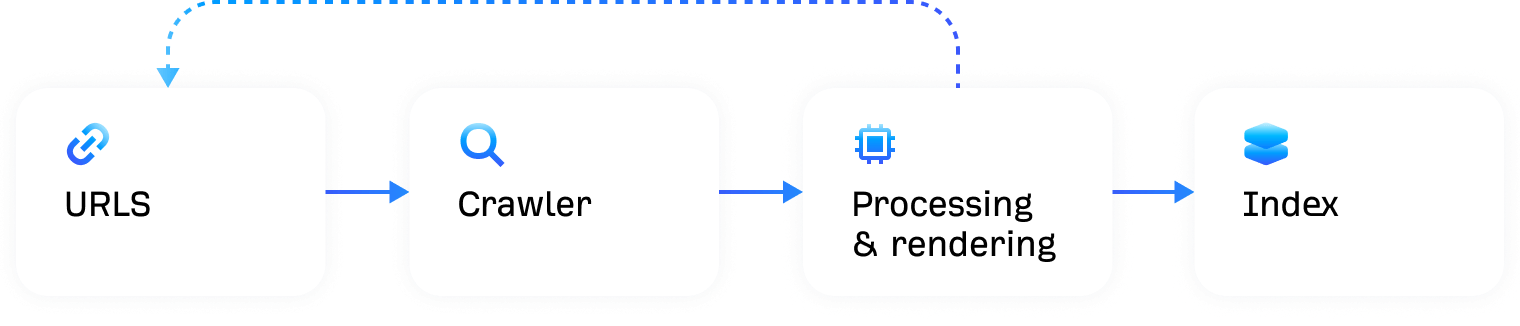
下面逐一拆解。
URL
一切都始于一份已知的 URL 清单。Google 通过多种方式发现这些 URL,最常见的三种是:
- 来自反向链接。Google 拥有一个包含数千亿个网页的索引。2 若有人从已知页面链接到新页面,Google 就能顺着找到它。
- 来自站点地图。站点地图会告诉 Google,你认为自己网站上哪些页面和文件是重要的。3
- 来自 URL 提交。Google 允许网站主在 Google Search Console 中请求抓取单个 URL。
抓取
抓取是指被称为蜘蛛的计算机机器人访问并下载已知 URL 的过程。Google 的爬虫是 Googlebot。4
处理与渲染
处理是指 Google 努力理解并提取已抓取页面中的关键信息。为此,它必须渲染页面,也就是运行页面代码,以理解它在用户眼中呈现的样子。
这个过程的每个细节,Google 之外无人知晓。但这并不重要。我们真正需要知道的只是:它涉及提取链接,并存储内容以供索引。
索引
索引是指将已抓取页面中经过处理的信息加入搜索索引的过程。
搜索索引就是你在使用搜索引擎时所检索的对象。ChatGPT、Claude 和 Gemini 等 AI 助手也会使用搜索索引来查找网页。这就是被 Google 和 Bing 等主流搜索引擎索引如此重要的原因:除非你进入索引,否则用户就找不到你。
你知道吗?
搜索引擎如何对页面进行排名
发现、抓取和索引内容只是拼图的第一部分。当用户进行搜索时,搜索引擎还需要一种方式对匹配到的结果排序,这就是搜索算法的任务。
什么是搜索算法?
搜索算法是将索引中相关结果进行匹配和排序的公式。Google 在其算法中使用了众多因素。
Google 的关键排名因素
无人知晓 Google 的全部排名因素,因为 Google 并未公开它们。但我们确实了解其中一些关键因素。下面来看其中几个。
反向链接
反向链接是从一个网站上的页面指向另一个页面的链接,是 Google 最强的排名因素之一。6 这或许就是我们在对超过 10 亿个页面的研究中,看到链接域名与自然流量之间存在强相关性的原因。7
引用域名与搜索流量之间的相关性
基于对 Ahrefs Content Explorer 索引中超过 10 亿个页面的研究。
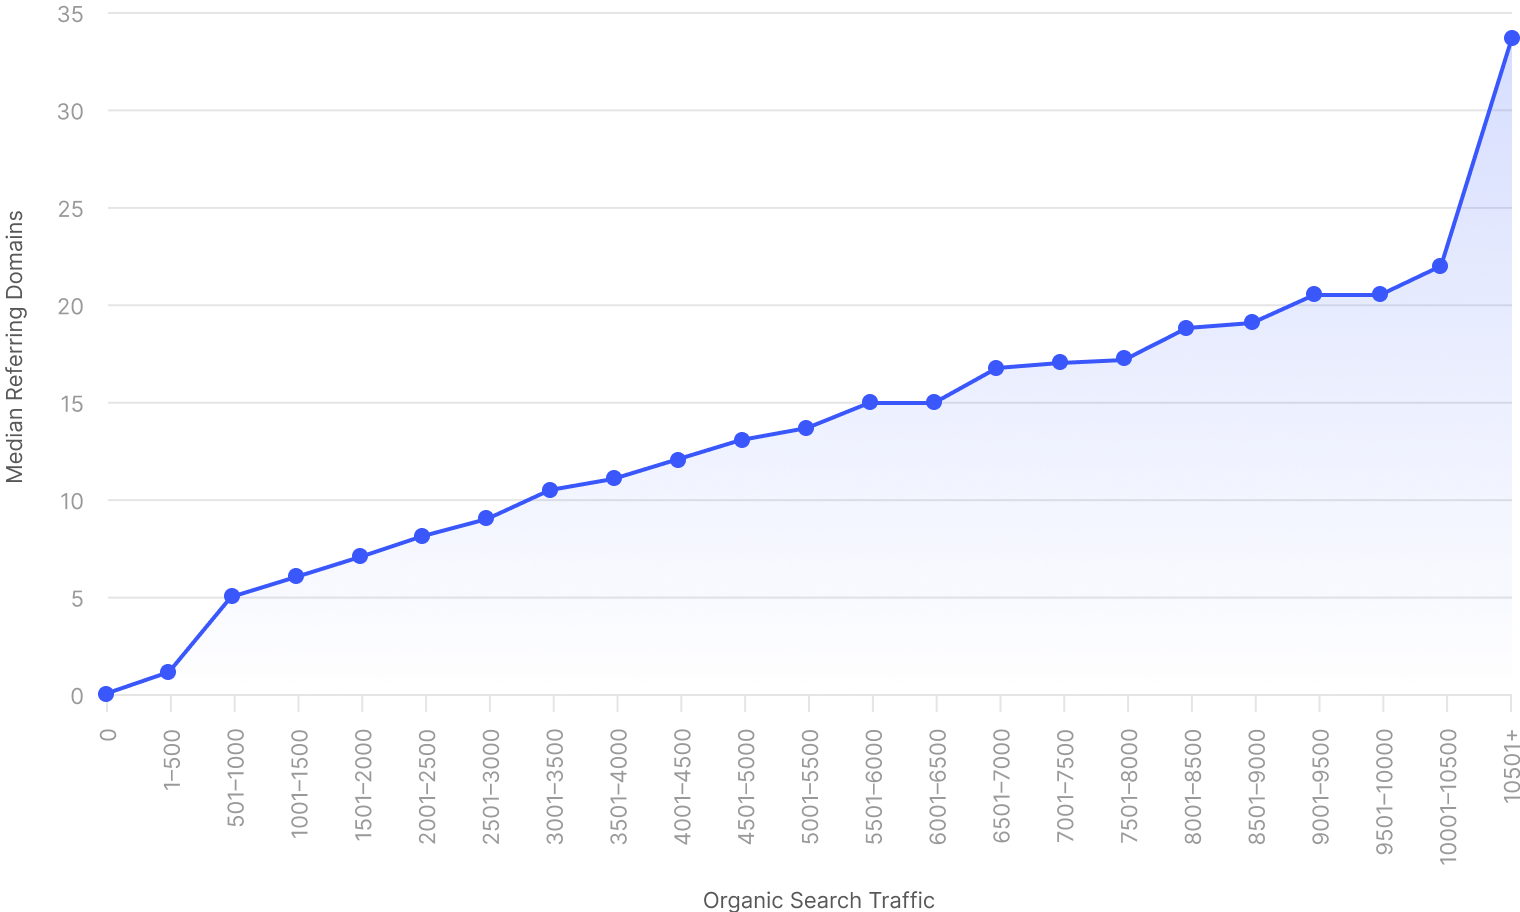
不过,这并不只是数量的问题,质量同样重要。拥有少量高质量反向链接的页面,往往能排在拥有大量低质量反向链接的页面之上。
你可以在 Ahrefs 中查看指向你网站的反向链接。
注册一个 Ahrefs Free 账号,在 Site Explorer 中输入你的域名,然后进入 Backlinks(反向链接)报告。
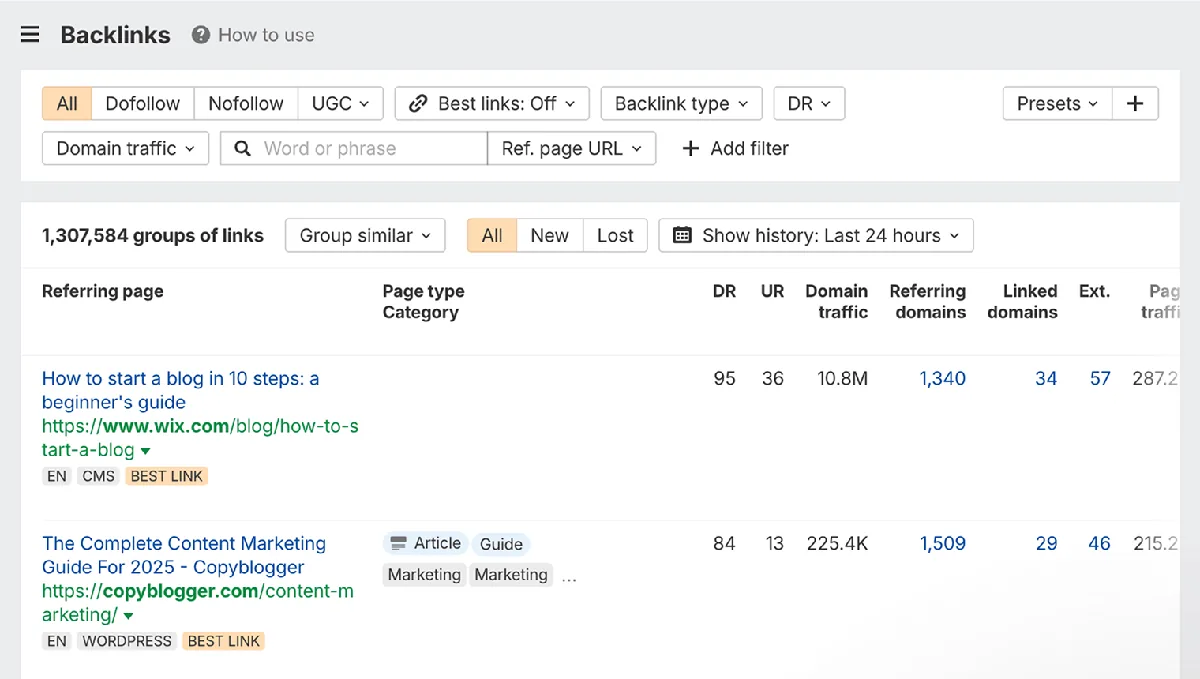
我们的爬虫是全网活跃度第五的爬虫,8 因此你能在这里看到相当完整的反向链接图景。
相关性
相关性是指某个结果对搜索者的有用程度。Google 有许多方式来判断这一点。在最基本的层面上,它会查找包含与搜索查询相同关键词的页面,也会查看交互数据,判断其他人是否觉得该结果有用。9
新鲜度
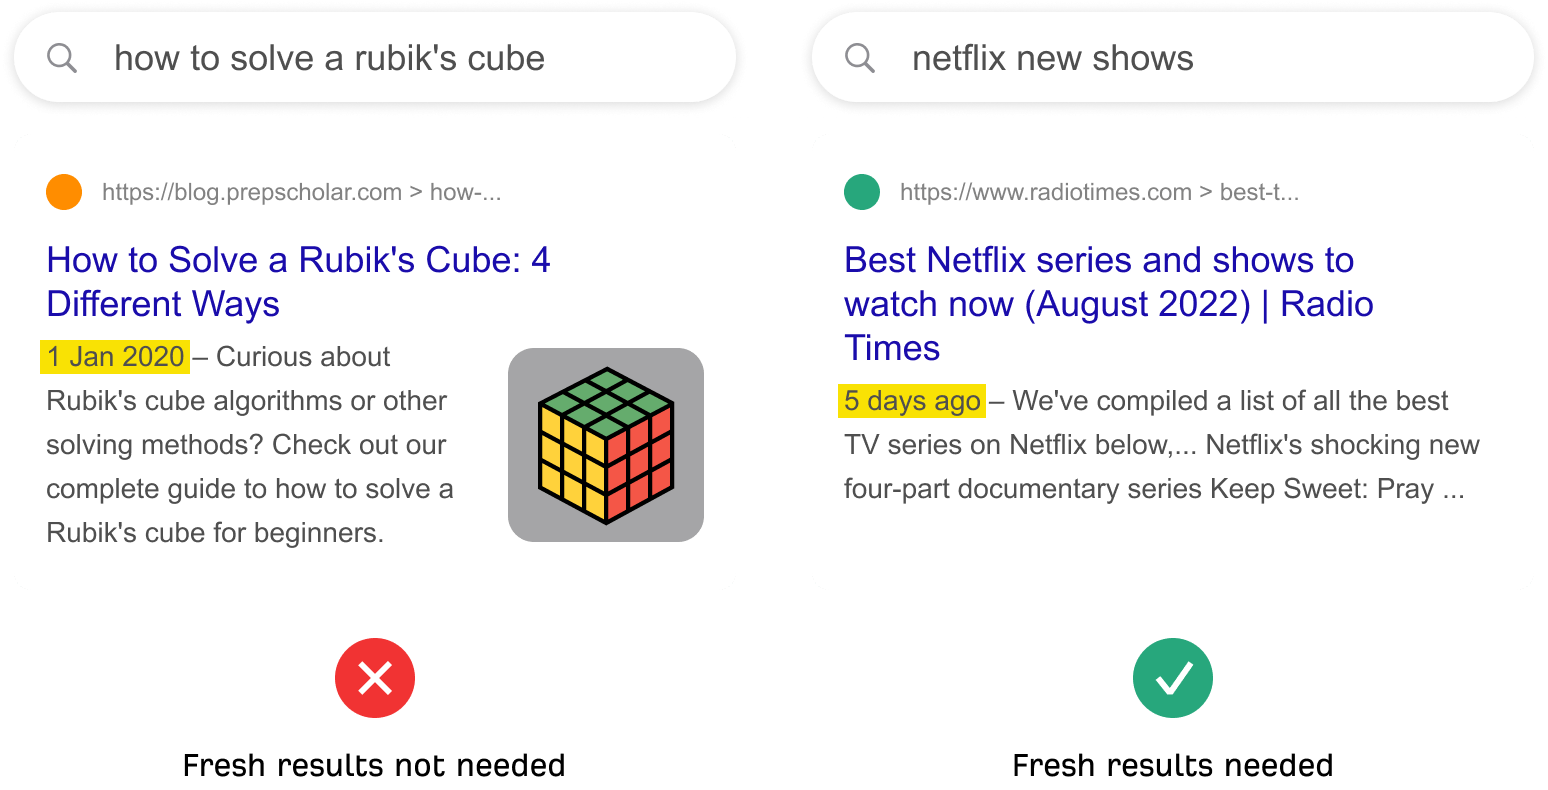
新鲜度是一个依赖查询的排名因素。对于需要新鲜结果的搜索,它的作用更强。9 这就是为什么搜索“new netflix series”时你会看到一个最近发布的顶部结果,而“how to solve a rubik's cube”则不会。
新鲜度是一个依赖查询的排名因素
页面速度
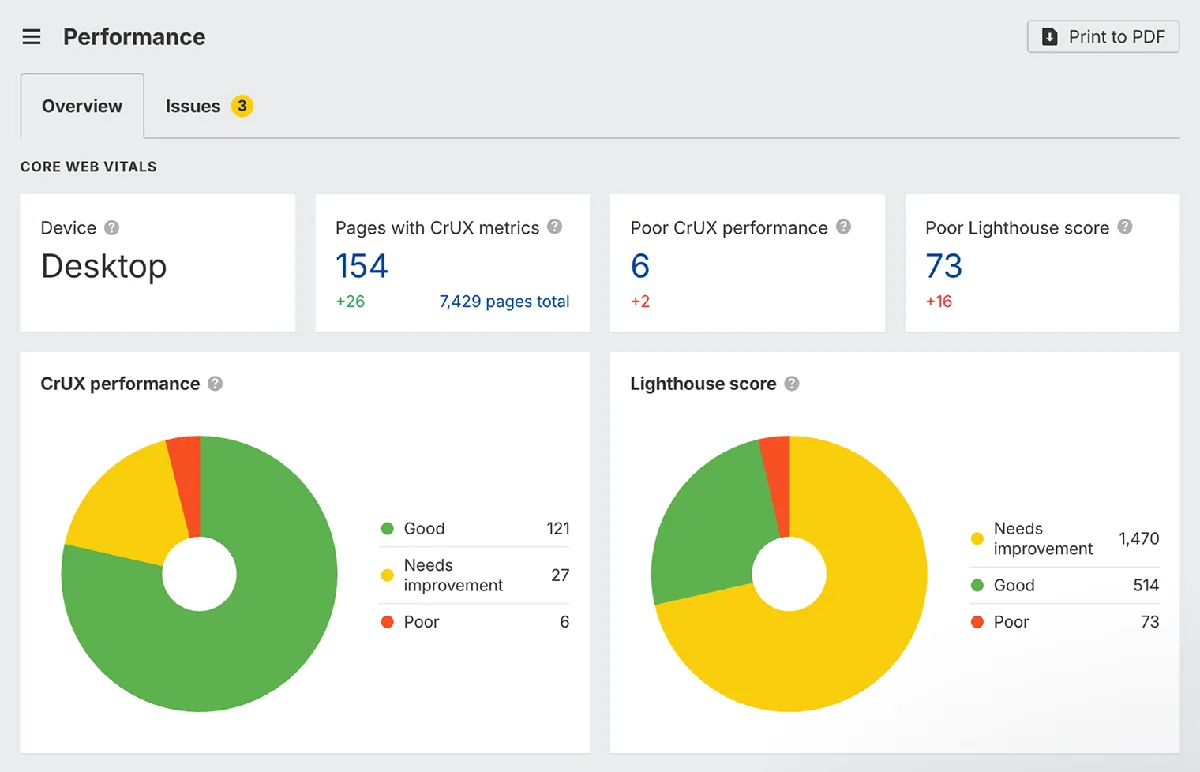
页面速度是桌面端和移动端的一个排名因素。10 11 但它更像是负面排名因素,而非正面因素:它对最慢的页面产生负面影响,而非对极快的页面产生正面影响。
你可以在 Ahrefs 中检查你的页面速度。
注册一个 Ahrefs Free 账号,用 Ahrefs 的 Site Audit 抓取你的网站,然后进入 Performance(性能)报告。一般来说,看到的红色越少越好。
移动端友好性
自 Google 于 2019 年转向移动优先索引以来,移动端友好性一直是移动端和桌面端的一个排名因素。12
搜索引擎如何对结果进行个性化
Google 会为每位用户定制搜索结果,依据的是你的所在地、语言和搜索历史等信息。9 下面细看这些因素。
所在地
对于带有本地意图的搜索,Google 会利用你的所在地来个性化结果。这就是为什么搜索“italian restaurant”返回的结果都来自或关于本地餐厅。Google 知道你不太可能为了吃顿午饭而飞越半个地球。
语言
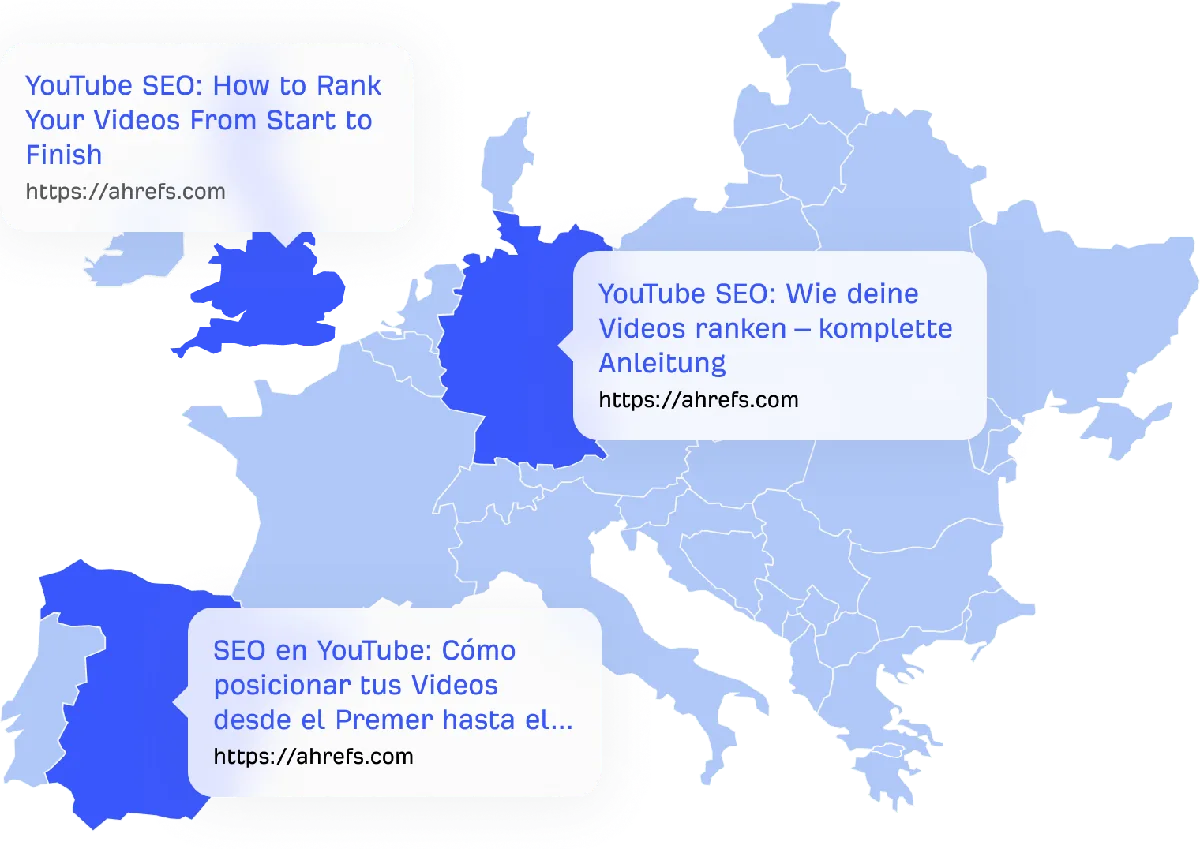
Google 知道,向说西班牙语的用户展示英语结果毫无意义。因此,它会向使用不同语言的用户展示内容的本地化版本(如有)。
Google 会为不同语言展示不同版本的结果
搜索历史
Google 会记录你所做的事情和你去过的地方,以提供更个性化的搜索体验。13 你可以选择退出这种追踪,但大多数人大概不会。
核心要点
- 搜索引擎由两个主要部分组成:索引和算法。
- 为构建索引,它会抓取已知页面,并顺着链接发现新页面。
- 搜索算法的目标是返回最好、最相关的结果。
- 搜索结果的质量对赢得市场份额很重要。
- 没有人知道 Google 自然结果的全部排名因素。
- 关键的排名因素包括反向链接、相关性和新鲜度。
- Google 会根据你的所在地、语言和搜索历史来个性化其结果。