Robots.txt 详解:语法、最佳实践与 SEO
了解如何使用 robots.txt 文件控制网站的抓取方式,并避免 SEO 问题。
什么是 Robots.txt 文件?
robots.txt 文件是一组规则,告诉网络爬虫应该抓取网站上的哪些页面或版块,以及应避免抓取哪些。
它长这样:
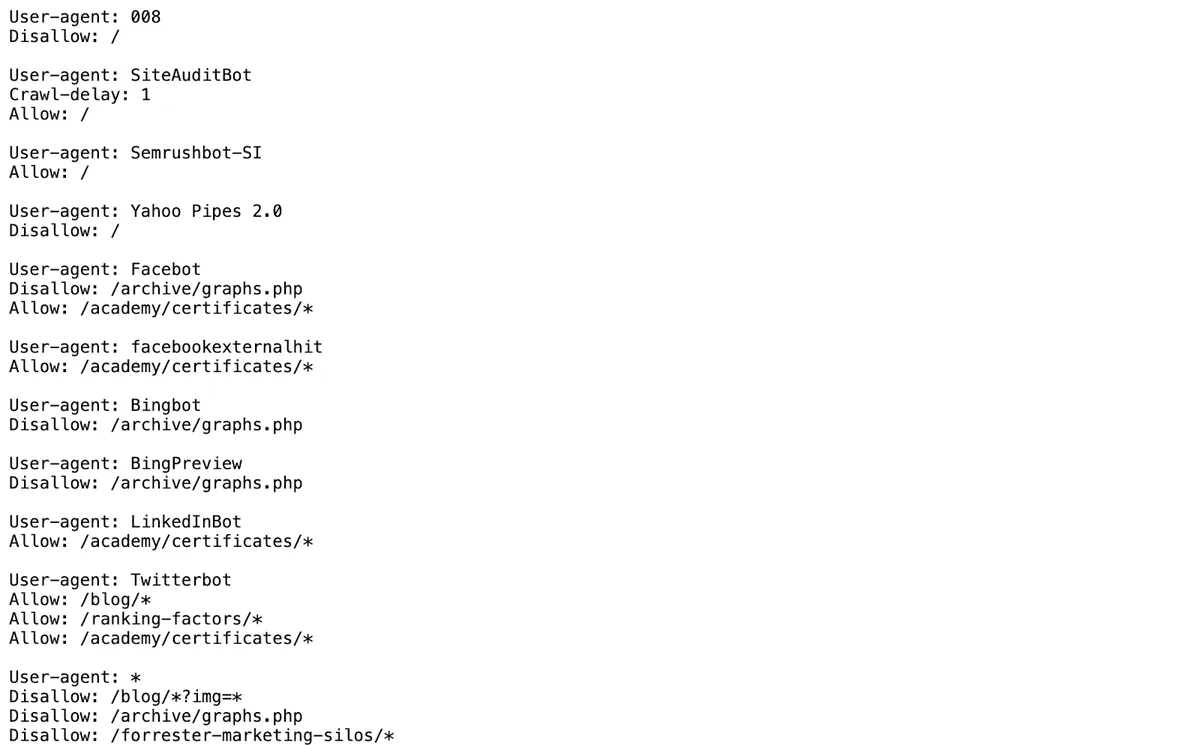
robots.txt 文件看起来可能很复杂。
但它的语法(计算机语言)很直白——“Allow”表示网络爬虫应该抓取它,而“disallow”表示爬虫不应抓取它。
但要记住:
虽然 robots.txt 会引导爬虫的行为,但它并不能保证某个页面不会出现在搜索结果中。其他因素(如外部链接)仍可能导致它被Google 索引。
要阻止索引,你应该使用 Meta Robots 和 X-Robots-Tag。
Robots.txt vs. Meta Robots vs. X-Robots
Robots.txt 告诉搜索引擎不要抓取什么——meta robots 标签和 X-Robots-Tag则告诉它们不要索引什么。
了解二者的区别,有助于在合适的情况下使用合适的工具。
以下是它们的对比:
- Robots.txt:该文件位于网站的根目录,向搜索引擎爬虫提供全站范围的指令,说明它们应该和不应该抓取网站上的哪些区域
- Meta robots 标签:这些标签是各个网页 <head> 部分中的代码片段,向搜索引擎提供页面级的指令,说明是否应索引(纳入搜索结果)和跟随(抓取页面上的链接)每个页面
- X-robot 标签:这些代码片段主要用于非 HTML 文件(如 PDF 和图片),在文件的 HTTP 头中实现
如果你想把某些内容排除在搜索结果之外,请(在可抓取的页面上)使用noindex meta 标签,或对该页面进行密码保护。
为什么 Robots.txt 很重要?
robots.txt 文件有助于控制机器人如何与你的网站交互。
SEO 从业者常用它来管理抓取负载,并通过屏蔽不重要或重复的页面来提高效率。它还可以用来阻止抓取行为,并防止内容被用于训练 AI 模型。
以下是 robots.txt 文件对 SEO 尤其重要的原因拆解:
它可以优化你的抓取预算
robots.txt 文件有助于搜索引擎将其抓取预算集中在你最有价值的页面上。
屏蔽低价值页面(如购物车、登录或筛选页面)有助于机器人优先抓取真正能带来流量和排名的内容,尤其是在拥有成千上万个 URL 的大型网站上。
例如:
屏蔽“/cart/”或“/login/”页面,有助于机器人转而专注于你的博客文章或产品页面。
它可以用来控制搜索中的呈现
通过管理抓取哪些内容,robots.txt 让你能对网站在搜索中的呈现有一定的控制。
虽然它不直接影响索引,但它会与下列内容协同,引导搜索引擎走向你的重要内容:
- 站点地图(Sitemap):一个列出你网站上重要页面的文件,帮助搜索引擎更高效地发现和抓取它们
- 规范标签(Canonical tags):一种 HTML 标签,当存在重复或相似内容时,告诉搜索引擎哪个版本的页面是首选索引版本
- Noindex 指令:一种信号(通过meta 标签或 HTTP 头),告诉搜索引擎不要把特定页面纳入用于搜索结果的索引
它有助于阻止抓取器和不受欢迎的机器人
robots.txt 是抵御不受欢迎爬虫的第一道防线,例如抓取器,或为训练 AI 模型而收集内容的机器人。
例如,如今许多网站通过 robots.txt 禁止 AI 机器人的 user-agent。
这向遵守该协议的机器人发出明确信号,并有助于减少非必要爬虫带来的服务器负载。
我们与 SEO 顾问 Bill Widmer 合作,做了一次快速实验,来演示 robots.txt 规则在现实条件下如何影响爬虫行为。
以下是发生的事情:
Bill 在他的 robots.txt 文件中有一条规则,屏蔽了一批爬虫。
他使用 Semrush 的 Site Audit 工具抓取整个网站,把抓取上限设置得足够高,以捕获所有在线页面。
但由于 robots.txt 的指令,他的网站没有被抓取。
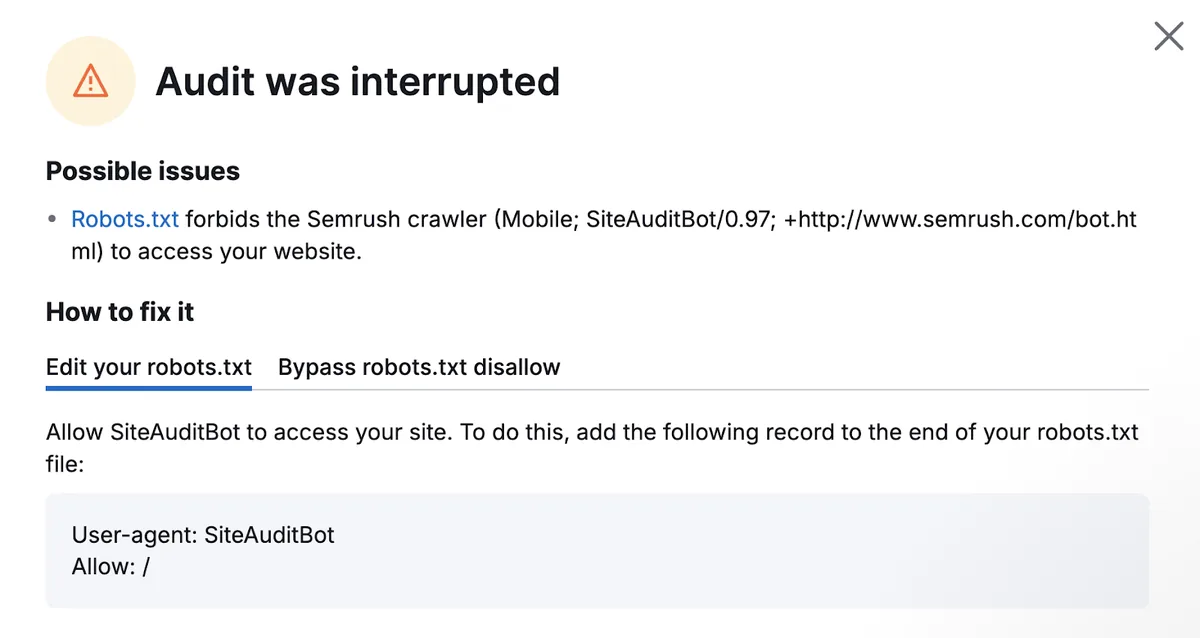
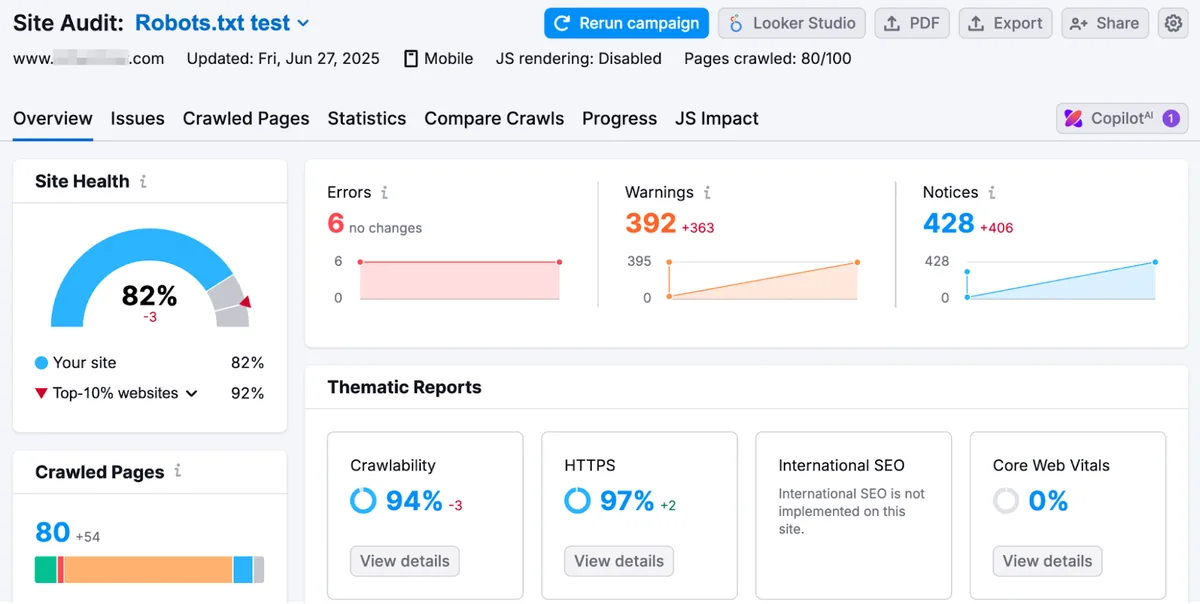
在调整了 robots.txt 文件后,他再次运行了抓取。
这一次,他的网站被成功抓取,并纳入了报告。
如何创建 Robots.txt 文件
创建 robots.txt 文件很简单——确定要屏蔽什么,把你的规则写进一个文本文件,然后上传到网站的根目录。
只需按照以下步骤操作:
1. 确定要控制什么
确定你网站上的哪些部分应该或不应该被抓取。
考虑屏蔽:
- 登录和用户账号页面(如 /login/),它们不提供公开价值,还可能浪费抓取预算
- 购物车和结账页面 (如 /cart/),你不想让它们出现在搜索结果中
- 感谢页面或表单提交确认页面(如 /thank-you/),它们对搜索者没有用处
如果你不确定,最好是宁可允许,也不要禁止。
错误的 disallow 规则可能导致搜索引擎错过重要内容,或无法正确渲染你的页面。
2. 针对特定机器人(可选)
你可以为所有机器人编写规则(User-agent: *),也可以根据你的具体需求,针对特定的机器人,如 Googlebot(User-agent: Googlebot)或 Bingbot(User-agent: Bingbot)。
在以下两种情况下这样做是合理的:
- 控制过于频繁或不那么重要的机器人:有些机器人抓取频繁,可能给你的服务器带来不必要的负载。你可能想限制或屏蔽这类机器人。
- 屏蔽用于训练生成式模型的 AI 爬虫:如果你不想让你的内容被纳入 ChatGPT 或其他 LLM 等工具的训练数据,你可以在 robots.txt 文件中屏蔽它们的爬虫(如 GPTBot)。
3. 创建 Robots.txt 文件并添加指令
使用像记事本(Windows)或 TextEdit(Mac)这样的简单文本编辑器创建你的文件,并保存为“robots.txt”。
在这个文件里,你会添加你的指令——告诉搜索引擎爬虫它们应该和不应该访问你网站哪些部分的语法。
一个 robots.txt 文件包含一个或多个指令组,每个组包含多行指令。
每个组都以一个 user-agent 开头,并指定:
- 该组适用于哪个(些)user-agent
- 该 user-agent 应该访问哪些目录(页面)或文件
- 该 user-agent 不应该访问哪些目录或文件
你还可以选择性地加入一个站点地图,告诉搜索引擎哪些页面和文件最重要。只是别忘了直接在 Google Search Console 中提交你的站点地图。
假设你不希望 Google 抓取你的“/clients/”目录,因为它主要供内部使用,对搜索者没有价值。
你文件中的第一个组会像这样一个代码块:
之后你可以为 Google 添加更多指令,像这样:
然后按两次回车,开始一个新的指令组。
例如,为所有搜索引擎阻止对“/archive/”和“/support/”目录的访问。
以下是一个阻止访问这些目录的代码块:
完成后,添加你的站点地图:
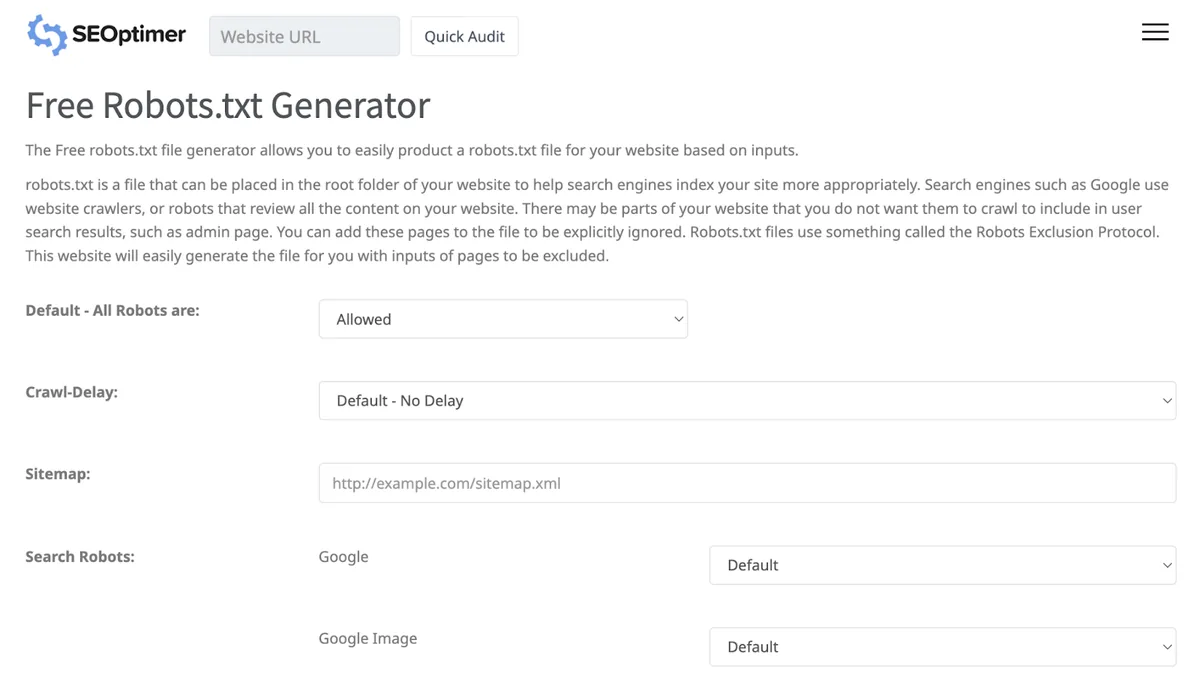
不太确定怎么做?
使用免费的 robots.txt 生成器,帮你生成 robots.txt 文件的文本。然后,把输出复制粘贴到一个文本编辑器中。
4. 把文件上传到网站的根目录
只有把你的 robots.txt 文件放在域名的根目录时,搜索引擎才会读取它。
这意味着该文件必须位于网站的顶层——而不是在某个子文件夹中。
要正确上传该文件,请使用你的网页托管文件管理器、FTP 客户端或 CMS 设置,把文件上传到根目录(通常称为“public_html”或“/www”)。
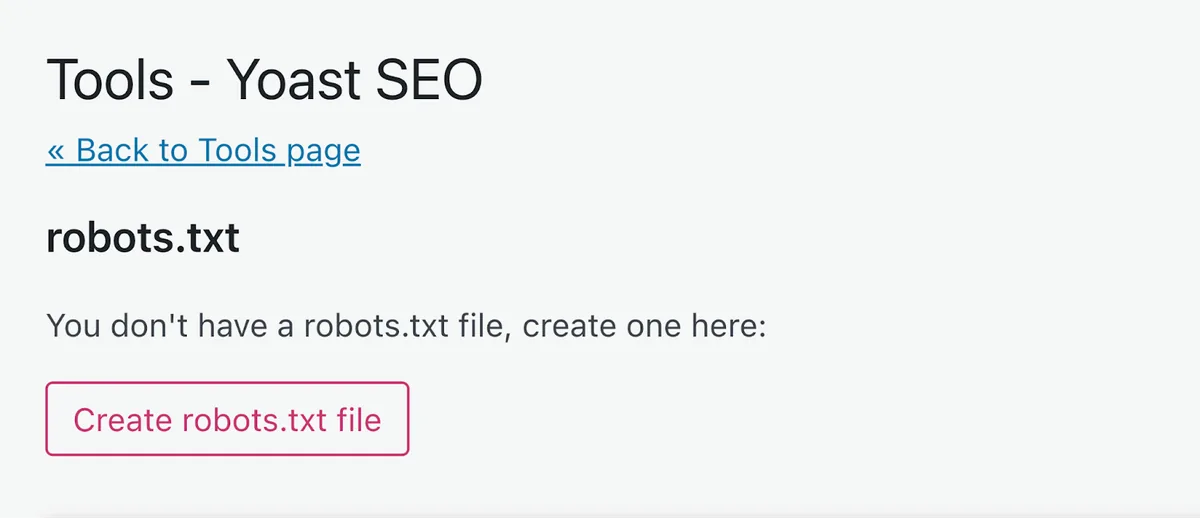
如果你使用的是 WordPress,可以使用像 Yoast SEO 或 Rank Math 这样的插件,替你上传文件到网站的根目录。
只要打开插件的设置,导航到 robots.txt 选项,然后上传你的文件。
5. 确认文件上传成功
在 Search Console 中使用 Google 的 robots.txt 报告检查错误,并确认你的规则按预期运作。
在 Search Console 中,导航到“Settings”页面,然后点击“robots.txt”旁边的“Open Report”。
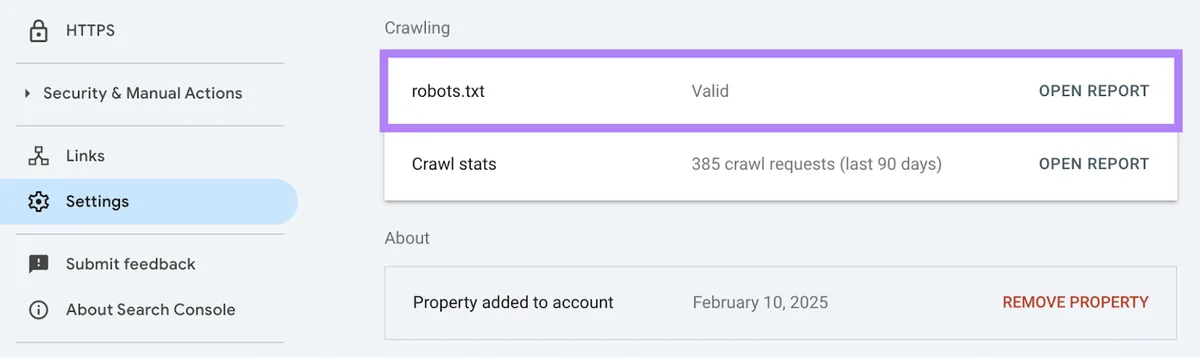
在状态列下,“Fetched”旁边应该有一个绿色的对勾。
但如果出现错误,你会在“Not Fetched”旁边看到一个红色的感叹号。在这种情况下,请查看Google 的指南,确定错误是什么以及如何修复。
如果你对 robots.txt 还不太熟悉,理解 Google 对错误的解决方案可能比较困难。
如果你想要更简单的方法,可以对你的网站运行一次免费的 SEO 检查,快速审查 robots.txt。
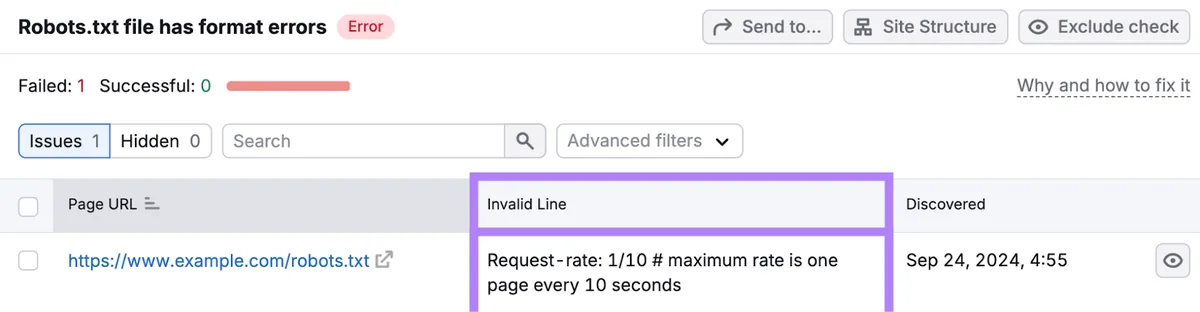
若要进行更深入的全站分析并获得详细的修复说明,请使用 Semrush Site Audit 工具。
设置一个项目并运行一次审计。
当工具准备就绪后,导航到“Issues”标签页并搜索“robots.txt”。
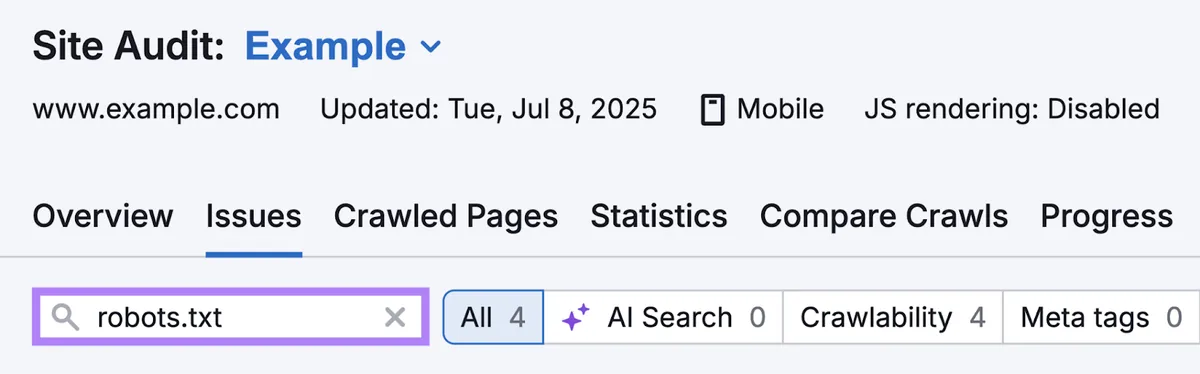
如果出现“Robots.txt file has format errors”,就点击它。
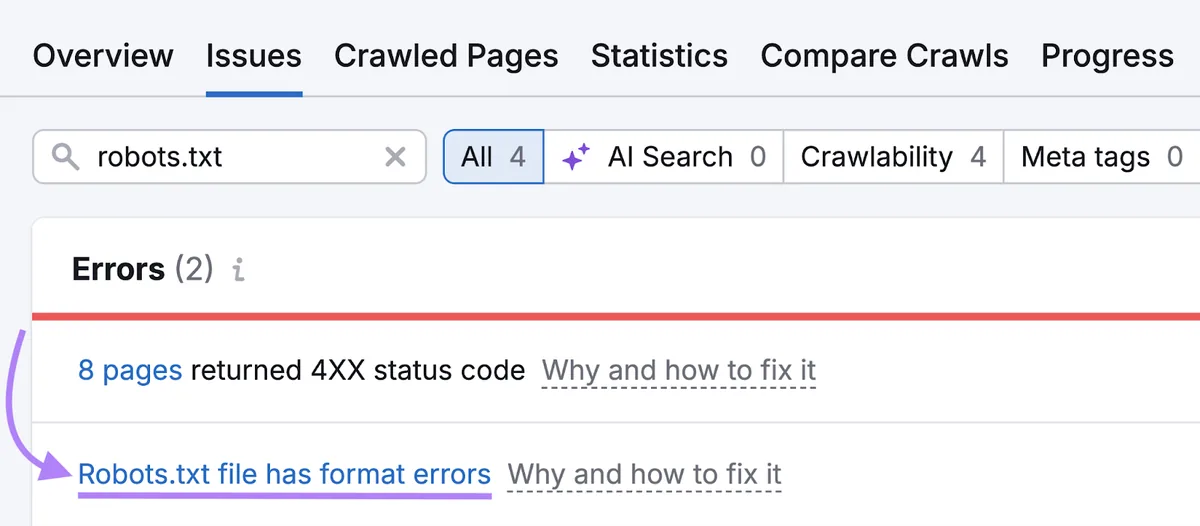
查看无效行的列表,确定到底需要处理什么。
定期检查你的 robots.txt 文件。即使是很小的错误也可能影响你网站的可索引性。
Robots.txt 最佳实践
遵循这些最佳实践,确保你的 robots.txt 文件有助于你的 SEO 和网站表现:
谨慎使用通配符
通配符(* 和 $)让你能匹配 URL 中的宽泛模式,精确地使用它们很重要,以免意外屏蔽重要页面。
- * 匹配任意字符序列,包括斜杠。它用于屏蔽共享某一模式的多个 URL。(示例:“Disallow: /search*”会屏蔽“/search”“/search?q=shoes”和“/search/results/page/2”。)
- $ 匹配 URL 的结尾。当你只想屏蔽以特定方式结尾的 URL 时使用它。(示例:“Disallow: /thank-you$”会屏蔽“/thank-you”,但不会屏蔽 /thank-you/page。)
以下是一些错误使用它们的示例:
Disallow: /*.php 会屏蔽所有以“.php”结尾的 URL,其中可能包括像“/product.php”或“/blog-post.php”这样的重要页面
Disallow: /.html$ 会屏蔽所有以“.html”结尾的页面,可能包括你网站的全部主要内容
如果你不确定,在 robots.txt 文件中使用通配符之前,明智的做法是咨询专业人士。
避免屏蔽重要资源
不要屏蔽渲染你网站所需的 CSS、JavaScript 或 API 端点。Google 需要它们来理解布局、功能和移动端适配情况。
因此,让爬虫可以访问:
- /assets/
- /js/
- /css/
- /api/
屏蔽这些可能会让 Google 看到你页面的残缺版本,从而损害你的排名。
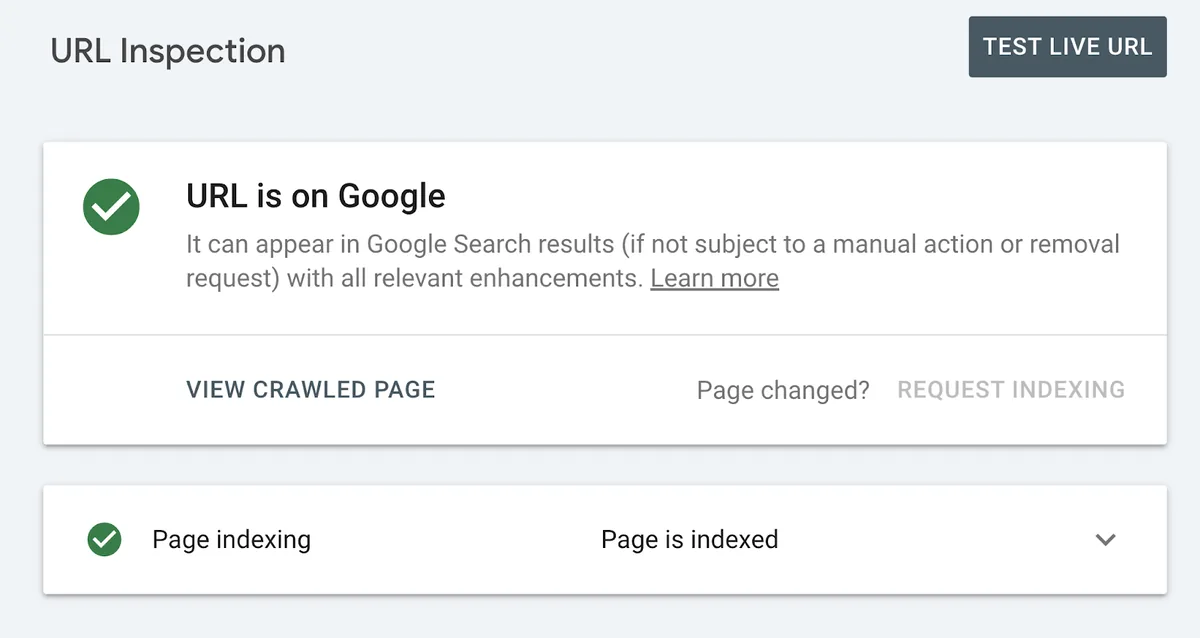
始终在 Google 的 URL 检查工具中测试你的网站,以确保被屏蔽的资源不会干扰渲染。
输入一个你想测试的 URL。
如果操作正确,你应该会看到一个绿色的对勾。如果你看到“Blocked by robots.txt”,则说明该页面(或它所依赖的某个资源)被禁止抓取。
不要用 Robots.txt 来让页面远离搜索结果
如果一个 URL 从别处被链接,Google 仍可能将其索引并显示在搜索结果中——即使你已经在 robots.txt 中禁止了它。
这意味着你不应该依赖 robots.txt 来隐藏:
- 敏感或私密数据(如管理后台、内部报告)
- 重复内容(如经过筛选或分页的 URL)
- 预发布或测试站点
- 任何你不想出现在 Google 中的页面
添加注释
使用注释来记录你的规则,这样其他人(或未来的你)就能理解你的意图。
通过在行首添加“#”来开始一条注释。同一行中它后面的任何内容都会被爬虫忽略。
例如:
对于不断壮大的团队和复杂的网站来说,注释尤其重要。
Robots.txt 与 AI:你应该屏蔽 LLM 吗?
像 ChatGPT 这样以及基于其他大语言模型(LLM)构建的 AI 工具,都是用网络内容训练出来的——而你的 robots.txt 文件是你管理它们如何抓取你网站的主要方式。
要允许或屏蔽用于训练模型的 AI 爬虫,只需像为 Googlebot 那样,在你的 robots.txt 文件中添加 user-agent 指令。
例如,OpenAI 的 GPTBot 用于收集可用于训练大语言模型的公开数据。要屏蔽它,你可以加入一行“User-agent: GPTBot”,后面跟上你选择的 disallow 规则。
你什么时候应该允许或屏蔽 AI 爬虫?
在以下情况下你应该允许 AI 爬虫:
- 你想增加曝光,且不介意你的内容被用于生成式工具
- 你认为提升可见度和品牌知名度带来的好处,超过对内容如何被用于训练生成式 AI 工具的控制
在以下情况下你应该考虑屏蔽 AI 爬虫:
- 你担心自己的知识产权
- 你希望对内容如何被使用保持完全控制
请注意,一个名为 llms.txt 的新文件正在被提议,用来帮助 AI 模型理解你的网站是关于什么、以及哪些内容最重要。但它并不完全是面向 AI 模型的 robots.txt 翻译版。
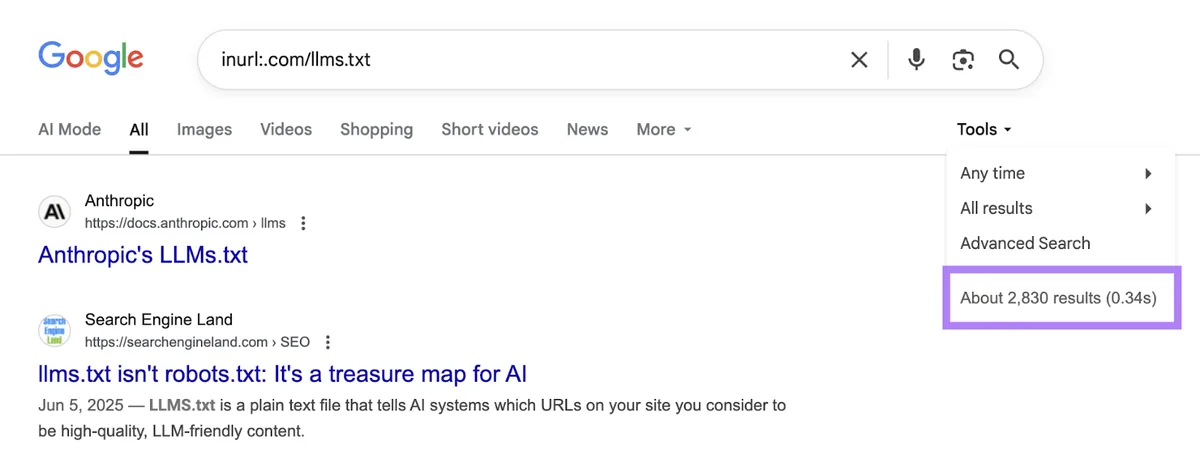
我们想看看有多少 .com 网站拥有 llms.txt 文件,以了解这种新文件类型的使用有多普遍。
这个粗略的实验显示,在被 Google 索引的 .com 网站中,只有约 2,830 个拥有 llms.txt 文件。
随着新更新的推出,llms.txt 文件可能会变得越来越重要。只有时间能给出答案。
检查你网站的 Robots.txt 和其他技术问题
配置良好的 robots.txt 文件是引导搜索引擎、保护你的资源和保持网站高效运转的有力工具。
但确保你的文件没有技术错误很重要。
使用我们免费的 SEO 检查工具,自动检查 robots.txt 错误、抓取问题、失效链接和其他技术 SEO 问题。