如何让 Google 索引你的网站
本文将说明如何检查 Google 是否已索引你的网站、未被索引时该如何处理,以便网站出现在搜索结果中。
网站要出现在 Google 的自然搜索或 AI 搜索结果中,被 Google 索引是前提。
下面介绍几种确认 Google 是否已索引网站的方法,以及一些常见的索引问题:
- robots.txt 文件出错
- 无意中使用 noindex 标签
- 规范标签使用不当
- 内链问题
- 返回 404 错误的 URL
- 重复内容
- 网站质量不佳
读完本文,就能掌握发现并修复索引问题的方法,并确认 Google 是否已索引最重要的页面。
什么是 Google 索引?
Google 索引是 Google 已抓取网页构成的一个庞大数据库。
索引属于结构化数据库,Google 借此把搜索查询与相关结果即时匹配。网页若不在这套索引中,就不会出现在自然搜索结果、AI Overviews、AI Mode 或 Gemini 里。
未被 Google 索引还会影响网站在 ChatGPT 等 AI 工具中的可见性。已有证据表明,这些 AI 系统至少有一部分时候依赖 Google。
一切正常时,索引流程按以下顺序推进:
- 抓取:Googlebot 在网络中发现新的或更新的页面
- 索引:Google 分析页面并存入数据库
- 选择:Google 的算法从索引中挑选最相关的页面用于搜索结果
索引由 Google 的算法控制,但网站所有者仍可通过一些措施影响这一过程。
如何检查 Google 是否已索引你的网站?
使用“site:search”运算符或 Google Search Console,检查 Google 是否已索引你的网站。
使用“site:search”运算符
“site:search”运算符会在搜索结果中显示某个网站已被索引的页面。
用法如下,可查看自己的页面是否已被索引:
- 打开 Google
- 在搜索栏中输入“site:[yourdomain.com]”
搜索后,已索引页面会以搜索结果的形式列出。想查看总数,点击“工具”下拉菜单,即可看到大致的结果数量。结果为零,说明没有任何页面被索引。
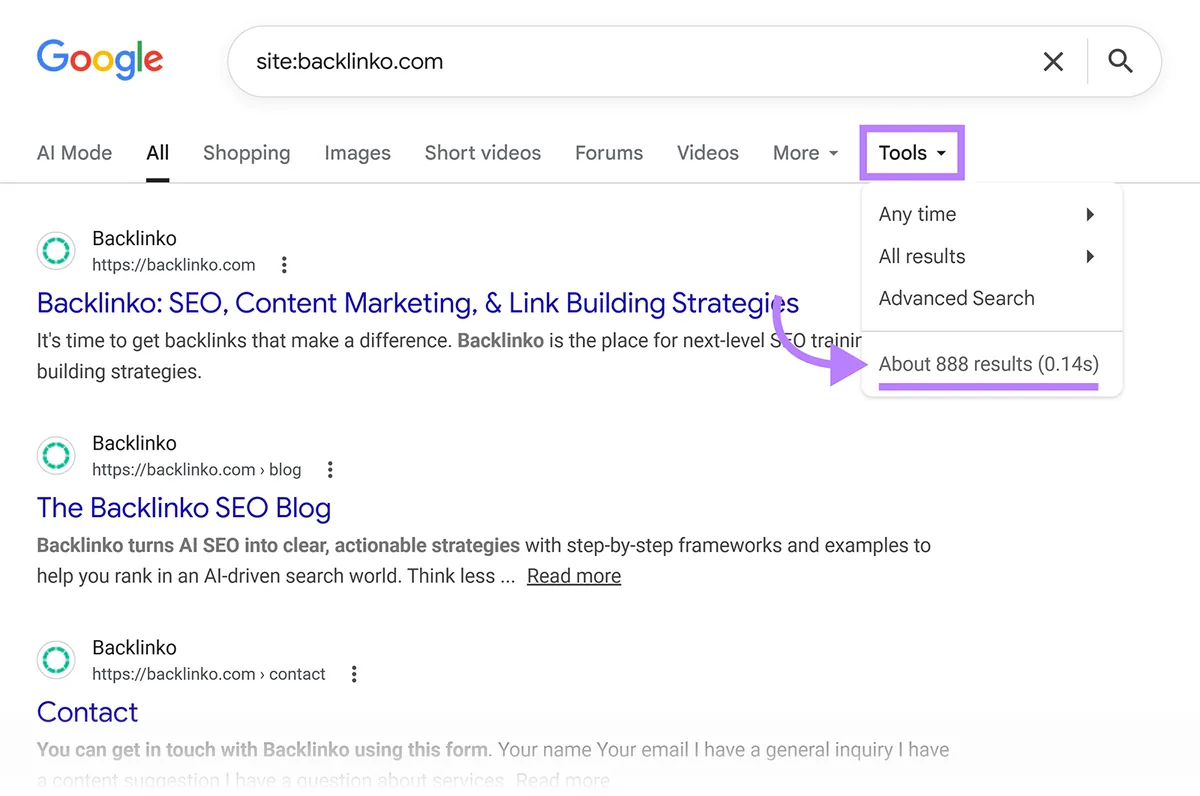
“site:search”运算符只能判断页面是否被索引,无法识别尚未被索引的页面。要找出这些页面,需要借助 Google Search Console(GSC)。
使用 Google Search Console
Google Search Console 的“页面索引”报告会列出网站上已被索引和未被索引的页面。
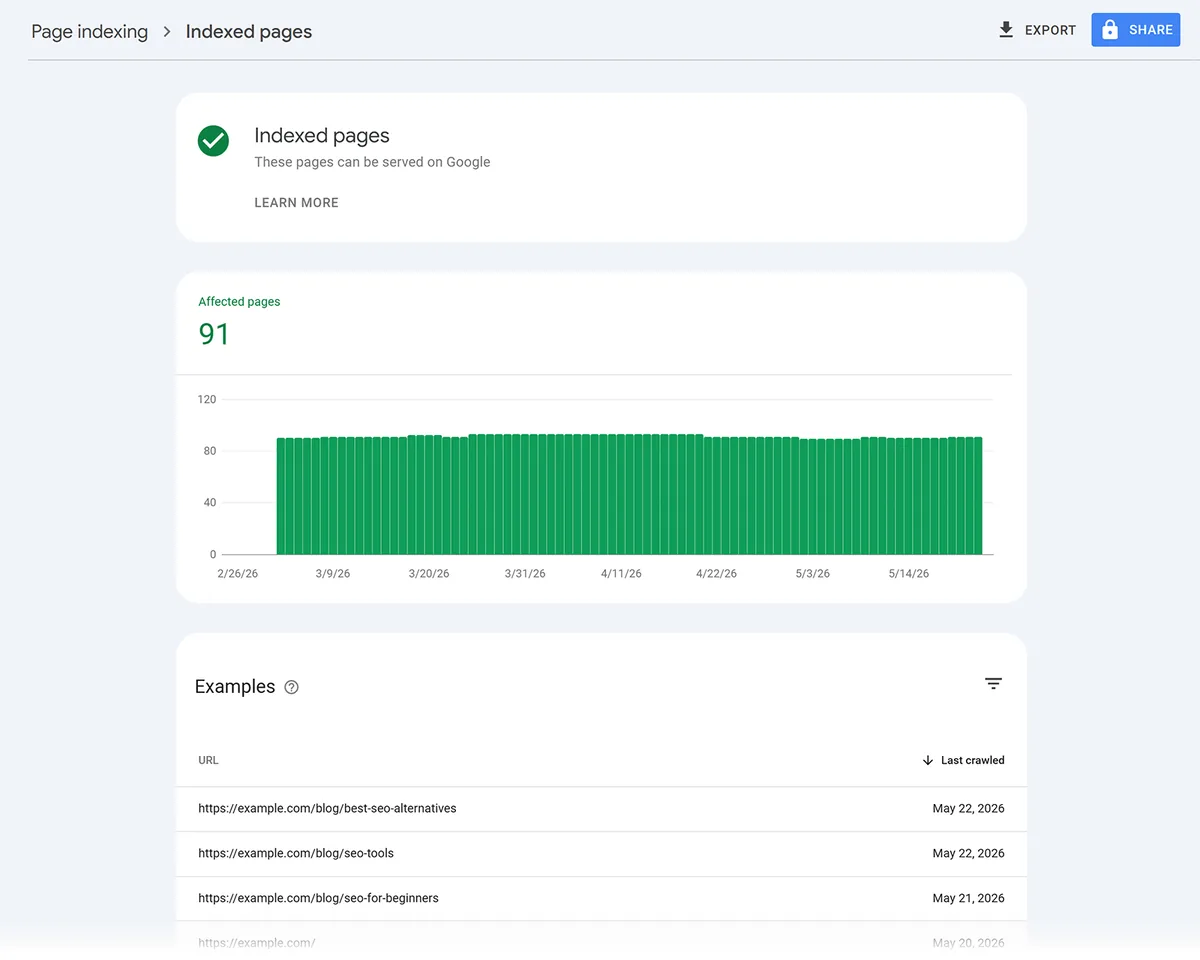
打开 GSC 账户,进入“页面”(位于“索引编制”下)。点击“查看已编入索引的页面数据”,获取一份已索引页面的样本列表。
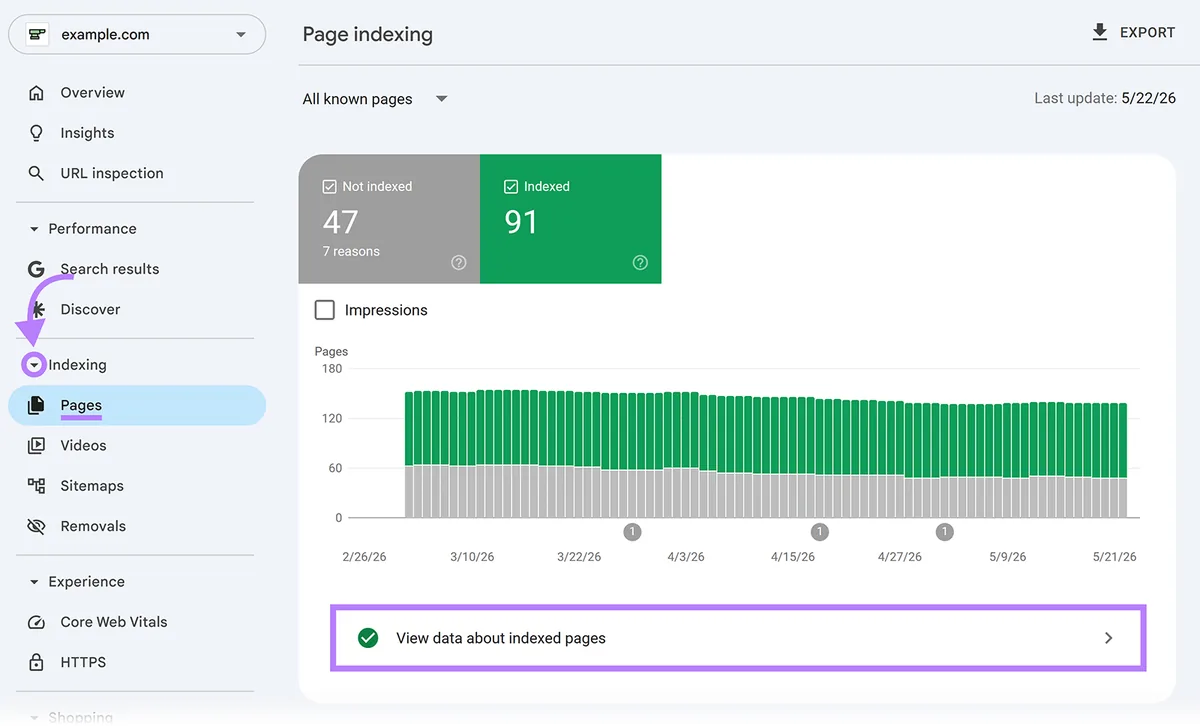
如果超过 1,000 个条目的上限,或部分内容是在最近一次抓取之后才新增的,“已索引页面”报告未必会列出全部已索引页面。
回到“页面索引”报告,向下滚动即可查看未被索引的页面。表格中,GSC 会列出页面未被索引的原因。点击任一原因,即可查看受影响的页面列表。
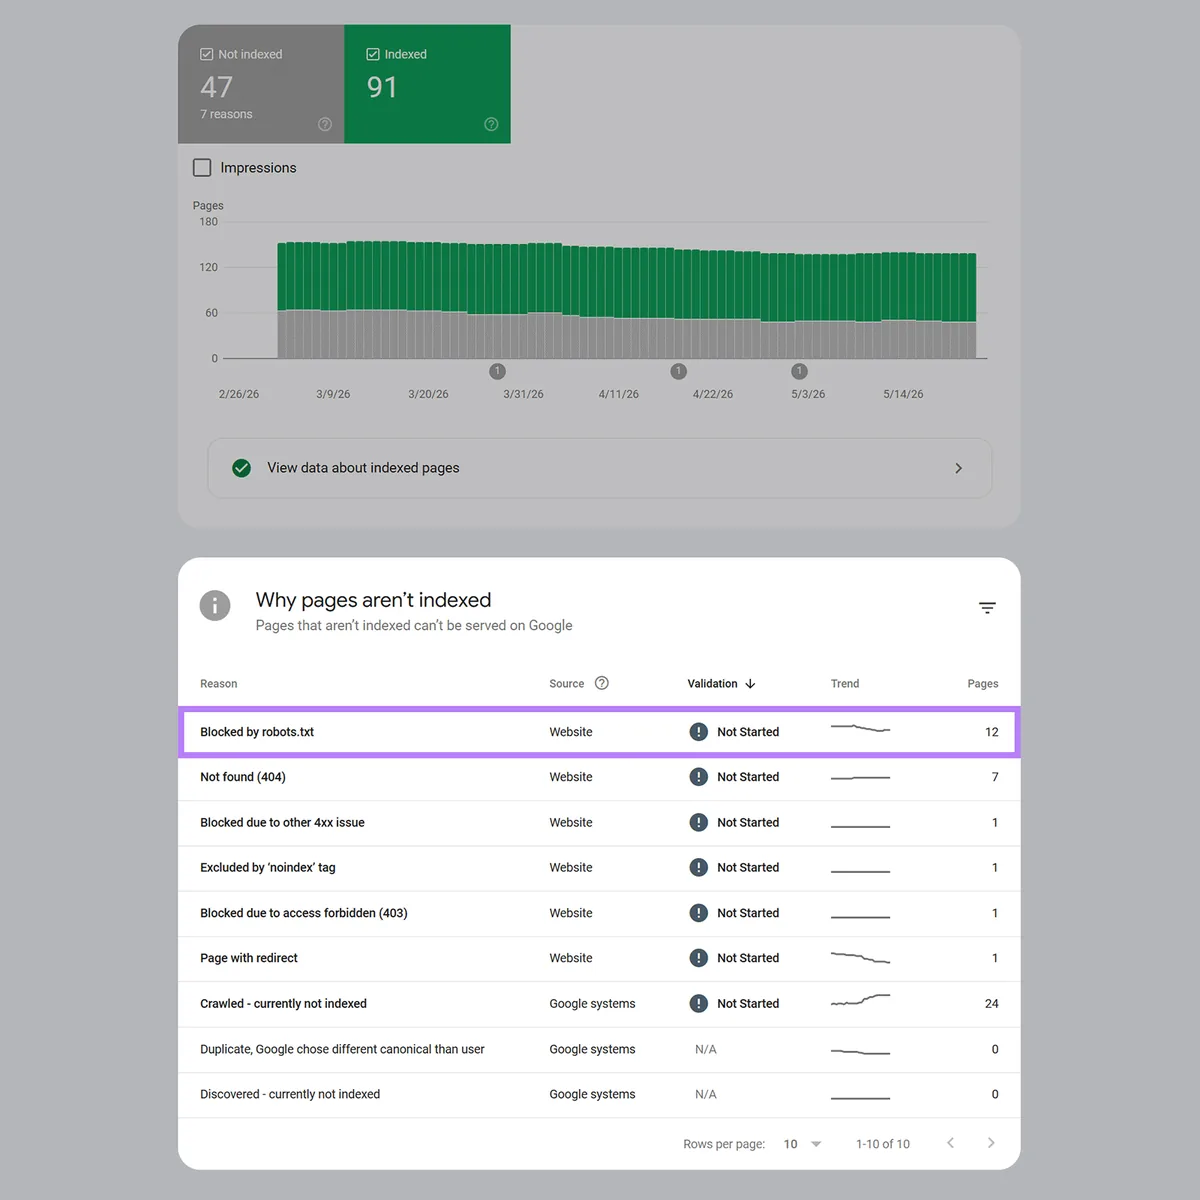
每种状态都对应一个具体问题。下表解释了几种常见的 Google Search Console 索引错误及其处理方式。
状态 | 含义 | 如何应对 |
|---|---|---|
已发现——尚未编入索引 | Google 已知该页面存在,但尚未抓取。通常是因为 Google 认为抓取该页面会让网站负载过重。 | 请求索引、加强指向该页面的内链,或减少占用抓取预算的重复页面和单薄页面 |
已抓取——尚未编入索引 | Google 已访问该页面,但决定不索引。这通常意味着存在质量问题。 | 补充原创内容,并确保页面能充分回答读者的问题,以此提升页面质量 |
被 robots.txt 屏蔽 | 一条 robots.txt (用于告知机器人可抓取和不可抓取内容的文件)指令要求 Googlebot 不要抓取该 URL | 打开 robots.txt 文件,检查是否有要求爬虫避开该页面的规则。若该页面应当被索引,就移除或调整该规则。 |
重复,Google 选择的规范网址与用户不同 | Google 发现该页面存在多个版本,并认定另一个 URL 为主版本 | 在所有版本上使用指向首选 URL 的规范标签 |
被“noindex”标签排除 | 页面 HTML 中的一条 <meta name="robots" content="noindex"> 标签明确要求 Google 不要索引该页面 | 若希望该页面被索引,就从页面源代码中移除 noindex 标签 |
未找到(404) | 该 URL 返回404 错误,说明该地址上不存在这个页面 | 页面被删除就恢复它;URL 有误就修正它;或者设置一条指向内容当前版本的301 重定向(永久重定向) |
如何让 Google 索引你的网站?
除了等待,无需额外操作 Google 也会索引网站;但创建并提交站点地图,或使用 Google Search Console 的 URL 检查工具,可以加快这一过程。
创建并提交站点地图
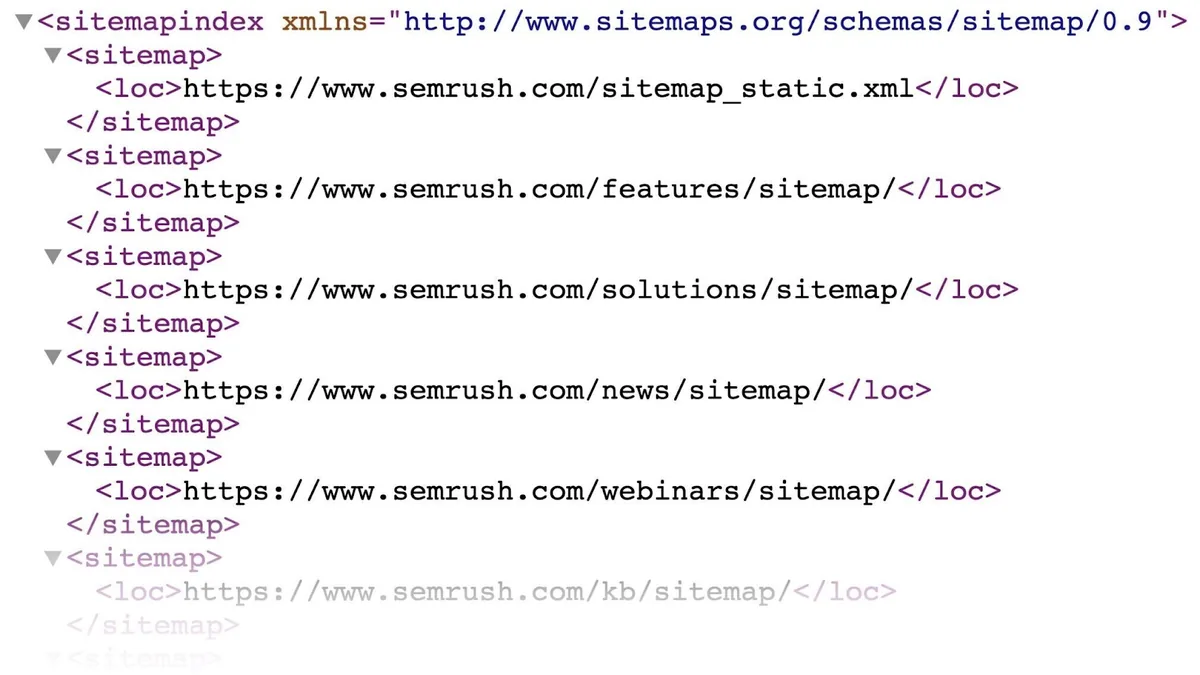
创建并提交站点地图(一份列出所有重要 URL 及其相互关系的文件),能帮助爬虫更快找到重点页面。
站点地图大致如下:
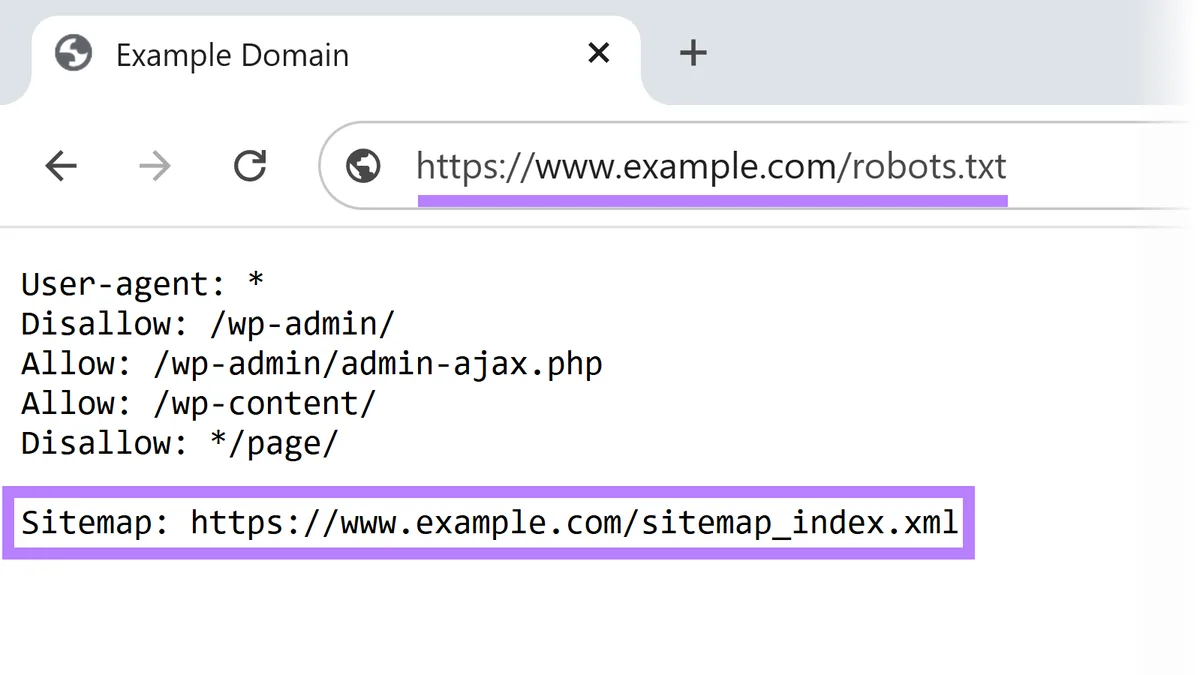
若不清楚站点地图 URL,可查看 robots.txt 文件获取。访问“https://[yourdomain.com]/robots.txt”,查找站点地图 URL(可能需要向下滚动)。
尚无站点地图的话,可参考创建 XML 站点地图指南。
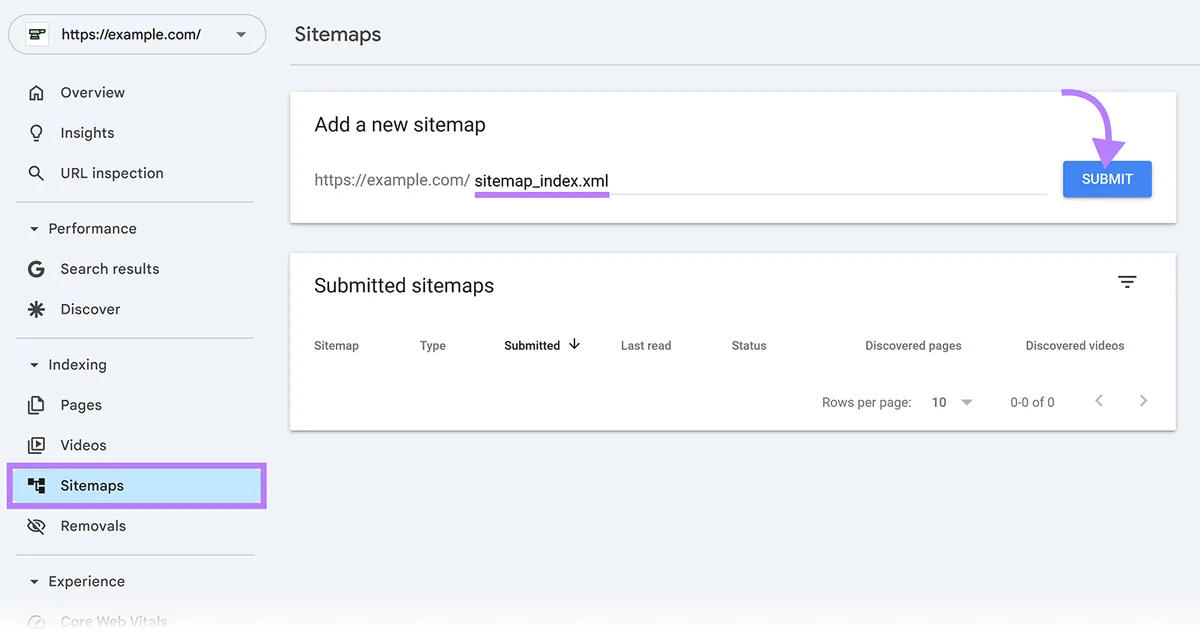
要在 GSC 中提交站点地图:
- 在 GSC 菜单的“索引编制”部分进入“站点地图”
- 在“添加新的站点地图”下输入站点地图 URL
- 点击“提交”
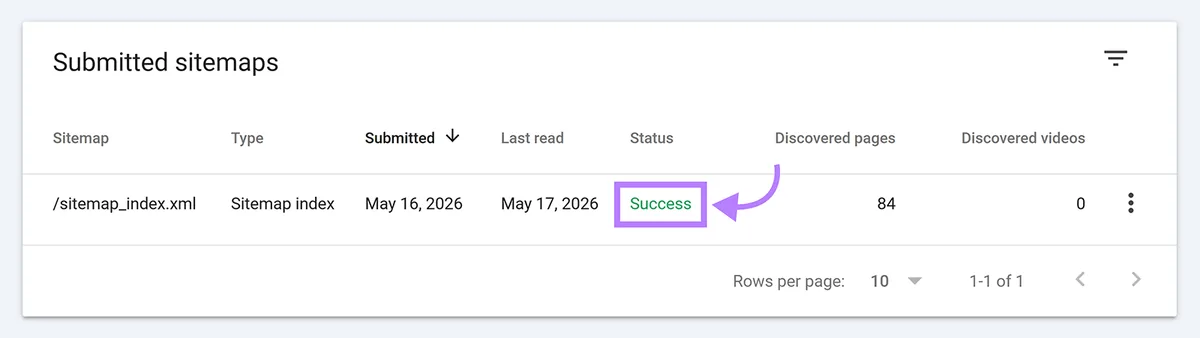
处理通常需要几天时间。完成后,站点地图链接旁会显示绿色的“成功”状态。
使用 URL 检查工具
GSC 的 URL 检查工具可以为某个具体页面请求索引。
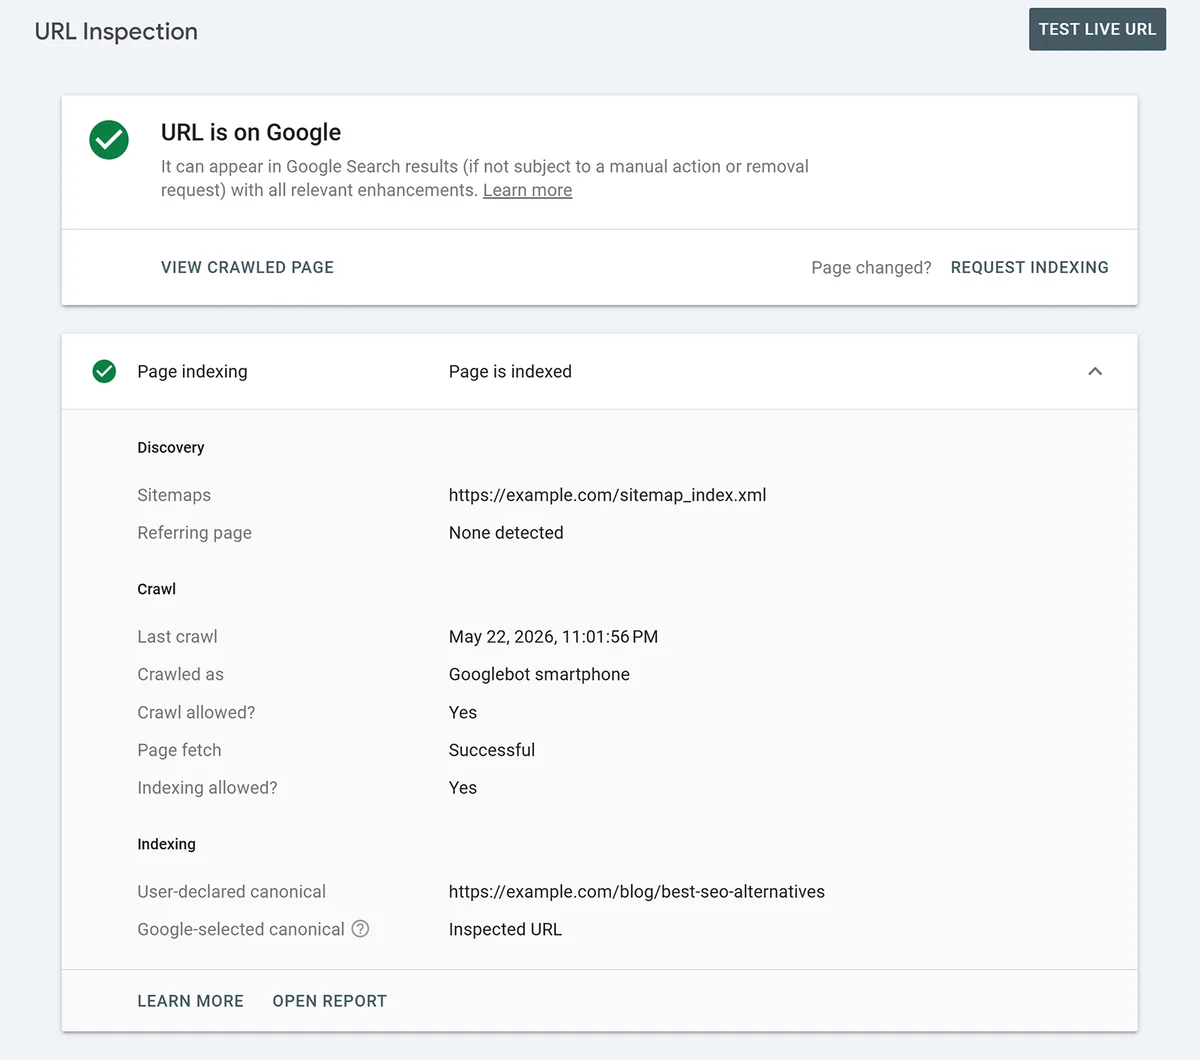
在 GSC 顶部的搜索栏输入 URL 并按回车。若顶部附近显示“URL 已在 Google 上”,说明该页面已被索引。还能看到 Google 上次抓取该页面的时间、该页面是否为 Google 选定的规范 URL,以及是否为页面自己指定的规范 URL。
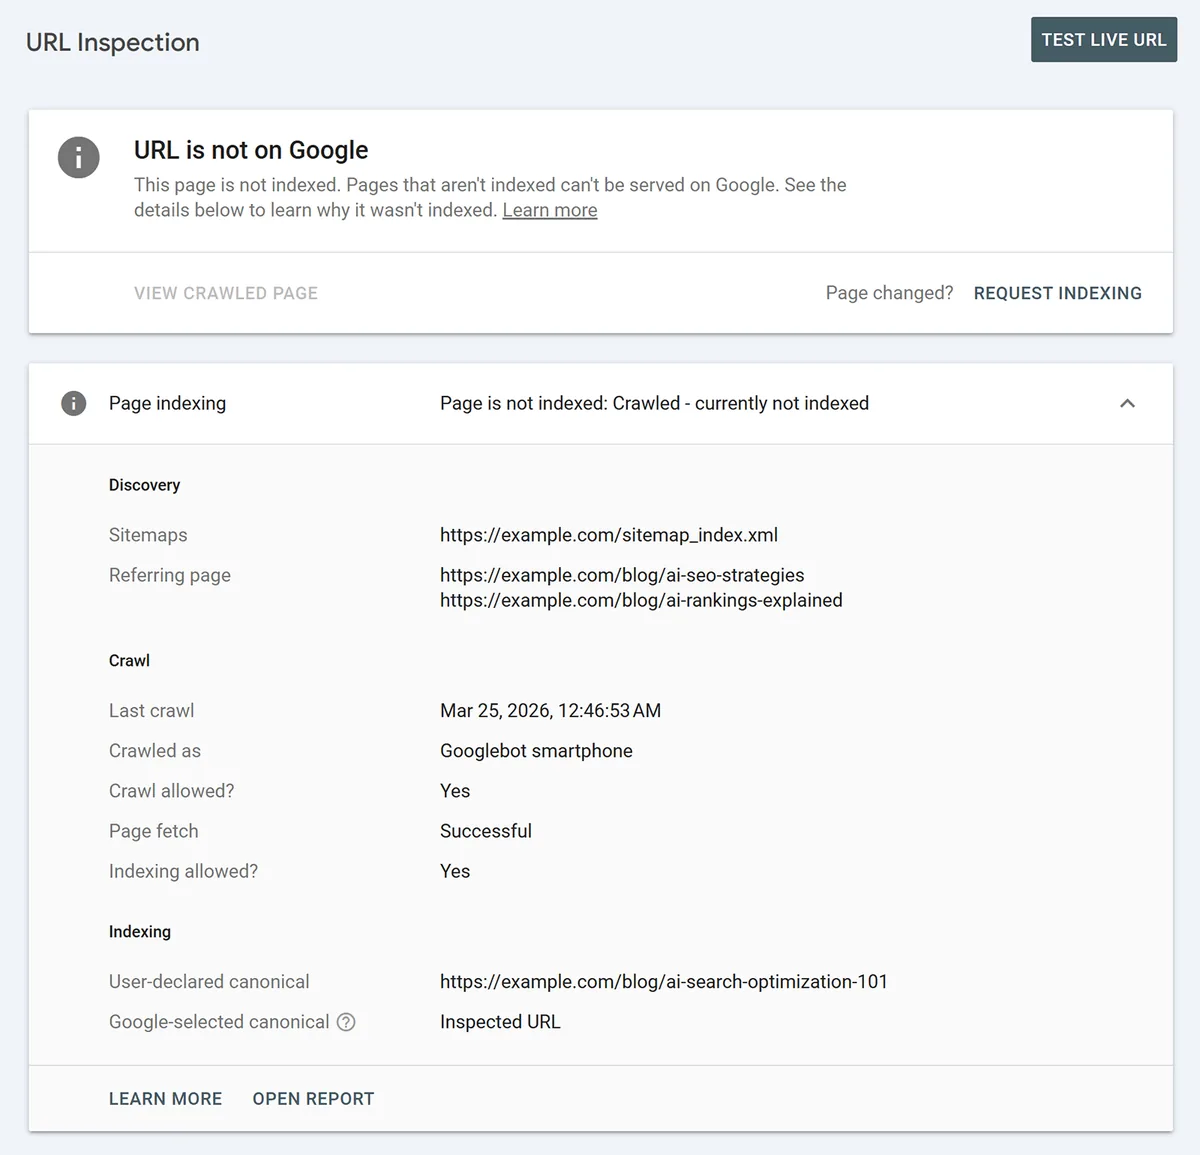
若状态为“URL 不在 Google 上”,说明该 URL 未被索引,也不会出现在搜索结果中。查看给出的原因并逐一解决。
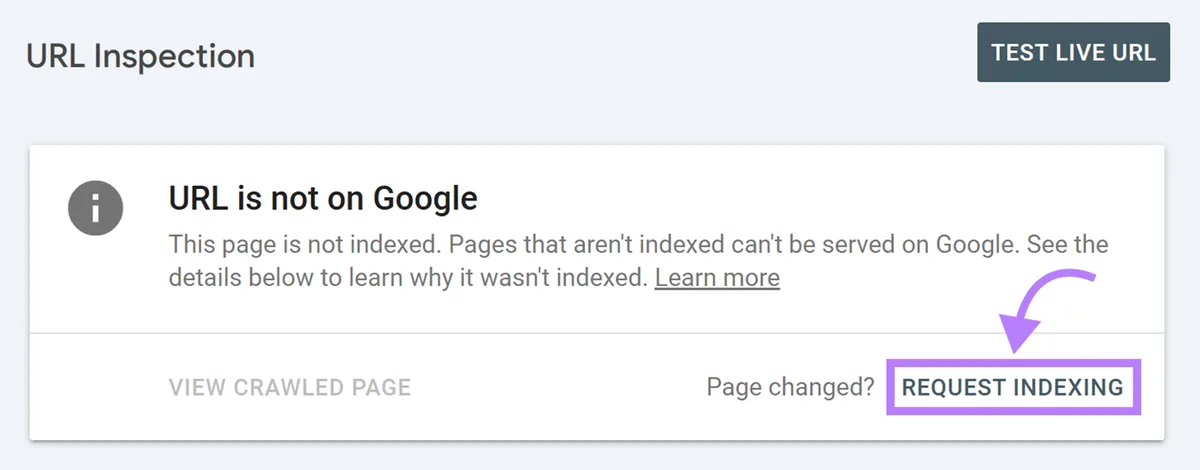
解决所列问题后,点击“请求索引”链接,请 Google 优先抓取该页面。这不能保证立即被索引,但 Google 通常会在几周内处理这类请求。定期用 URL 检查工具复查该页面,确认 Google 已将其索引。
需要发现并修复的常见索引问题
常见的索引问题包括:robots.txt 文件出错、缺乏移动端可用性、加载速度慢和重定向问题。
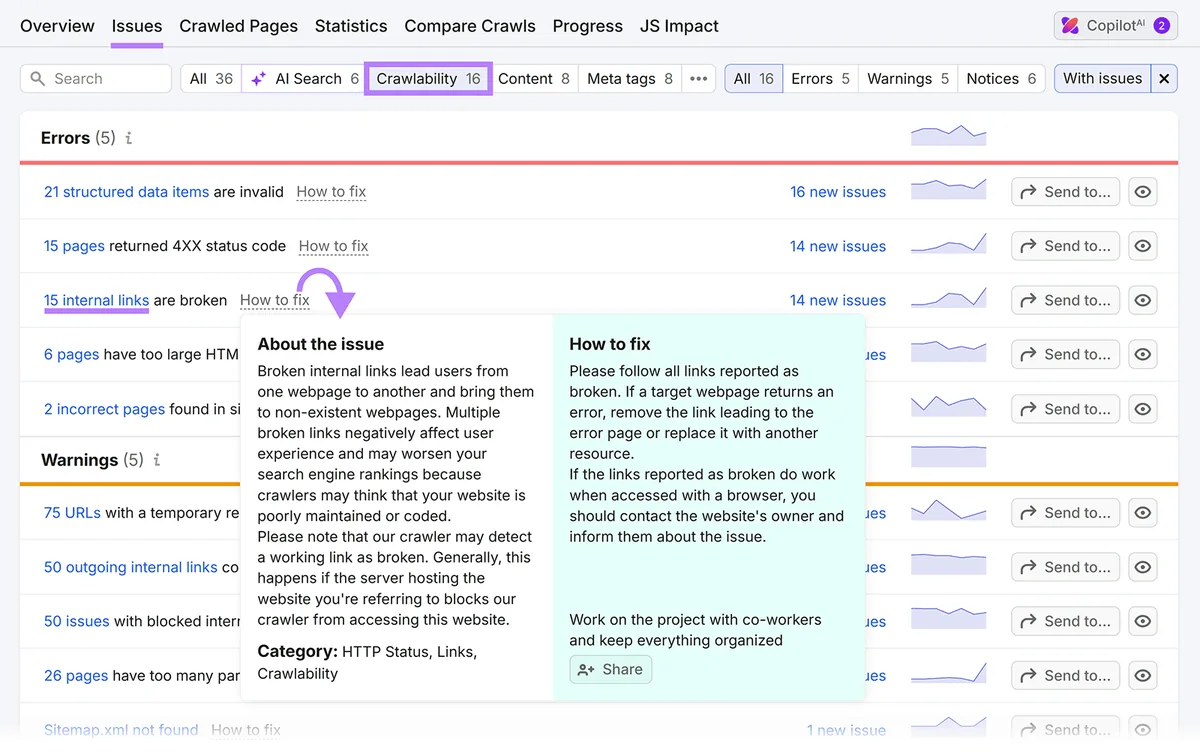
借助 Semrush Site Audit 找出网站特有的索引问题。配置 Site Audit 后,点击“问题”,按“可抓取性”筛选,即可看到阻碍搜索引擎抓取网站的问题。
点击具体错误可查看受影响的页面,点击“如何修复”可查看对应的解决提示。
下面详细介绍几种最常见的索引问题:
robots.txt 文件出错
robots.txt 文件出错,可能导致 Google 不抓取某些页面,甚至整个网站。
下面这份 robots.txt 要求某个机器人不要抓取整个网站。若该指令针对的是 Googlebot,Google 就不会抓取该网站。
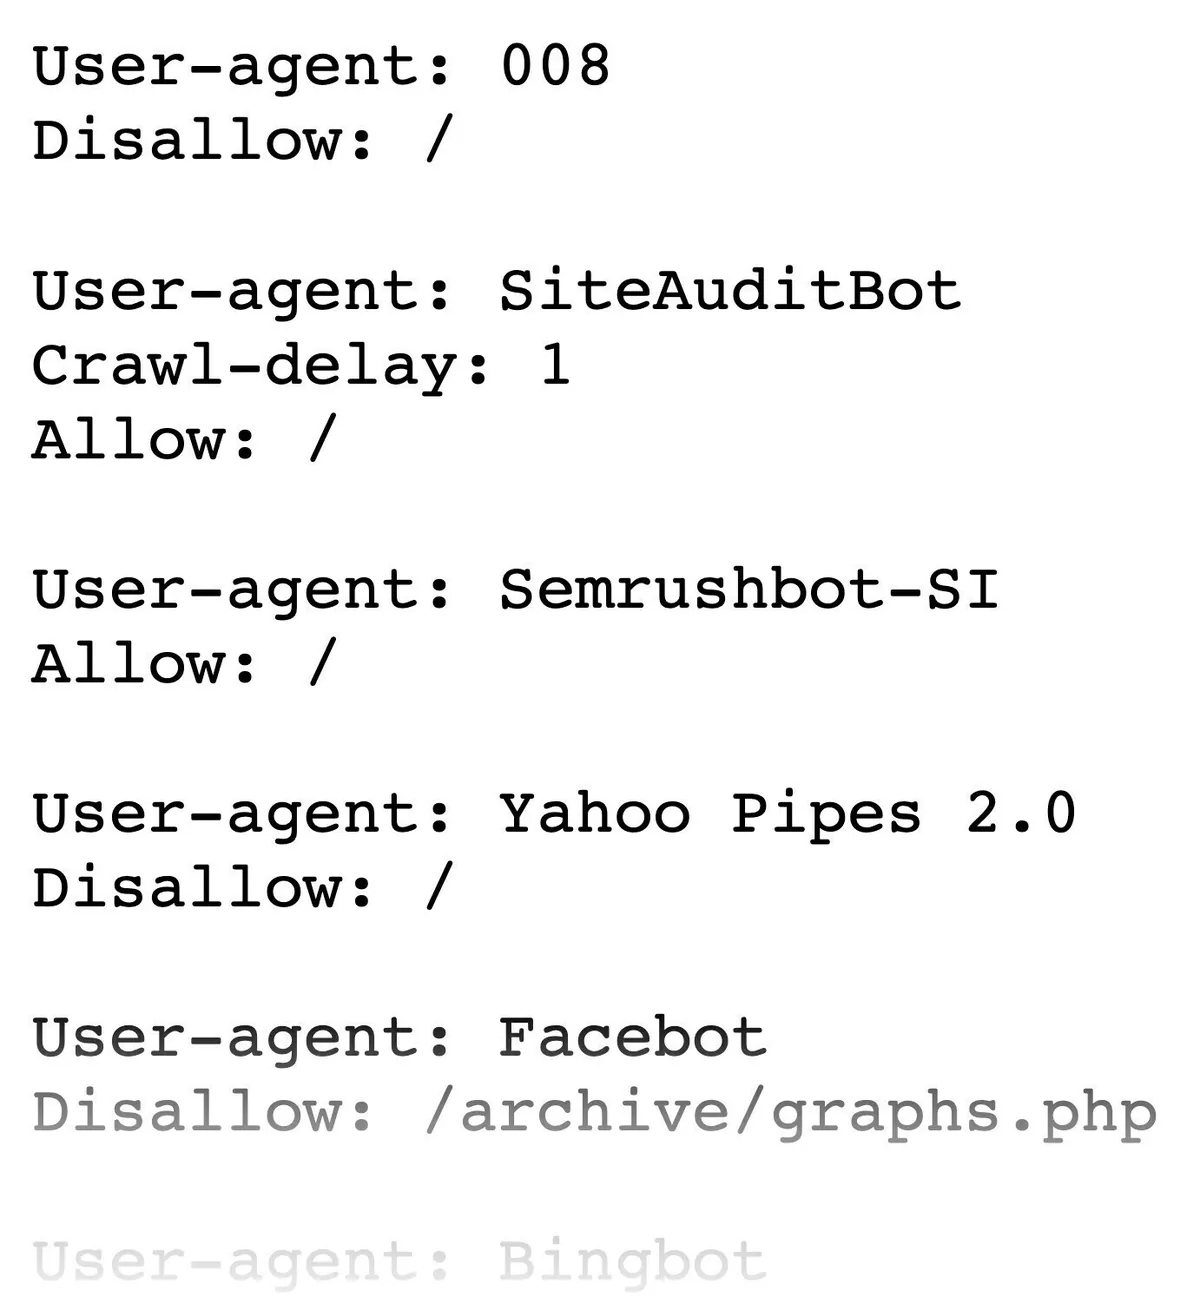
在“https://[yourdomain.com]/robots.txt”找到网站的 robots.txt。尚未创建、需要指引的话,可参考robots.txt 指南。
可以通过指令让爬虫避开重复页面、私有内容或资源文件。但如果 robots.txt 要求机器人完全不抓取,被索引的可能性就极低。
以下示例要求所有机器人不要抓取整个网站:
因此,请检查 robots.txt,确保没有指令阻止 Google 抓取希望被索引的页面。
无意中使用 noindex 标签
误加“noindex”robots meta 标签(页面内的 HTML 标签),会告知爬虫不要索引该页面。
noindex 标签的写法如下:
在 GSC 中检查哪些页面带有 noindex 标签:
- 点击左侧菜单“索引编制”下的“页面”
- 滚动到“页面未被索引的原因”
- 如果存在,点击“被“noindex”标签排除”
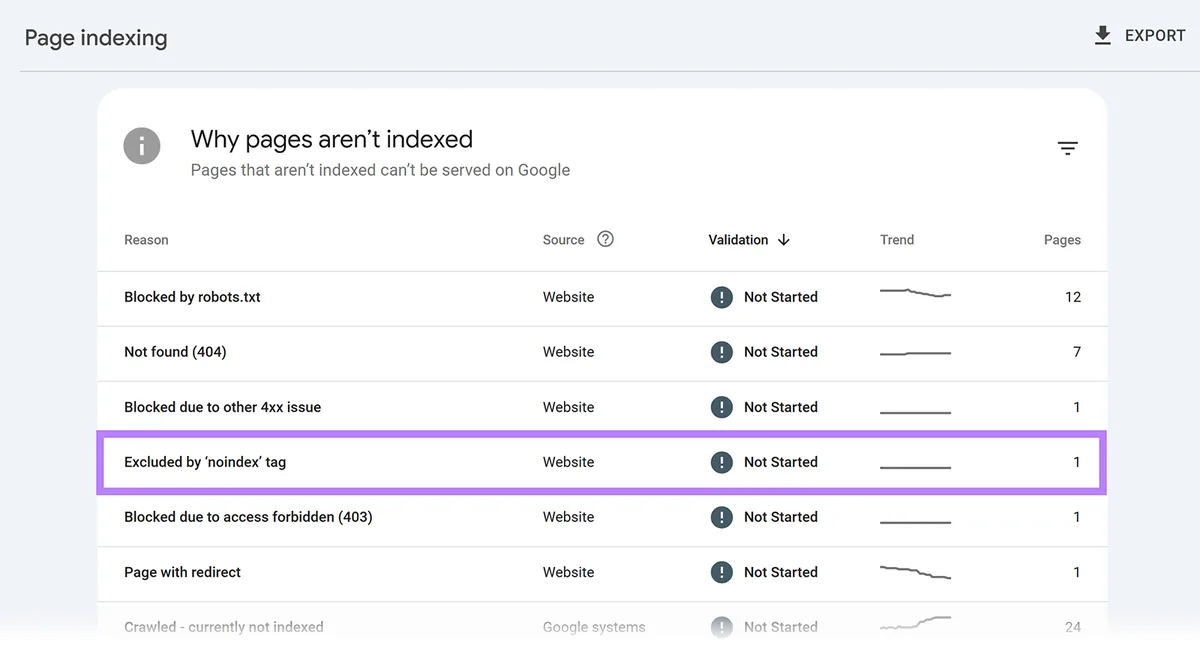
对列表中希望出现在 Google 索引里的页面,移除其 noindex 标签。
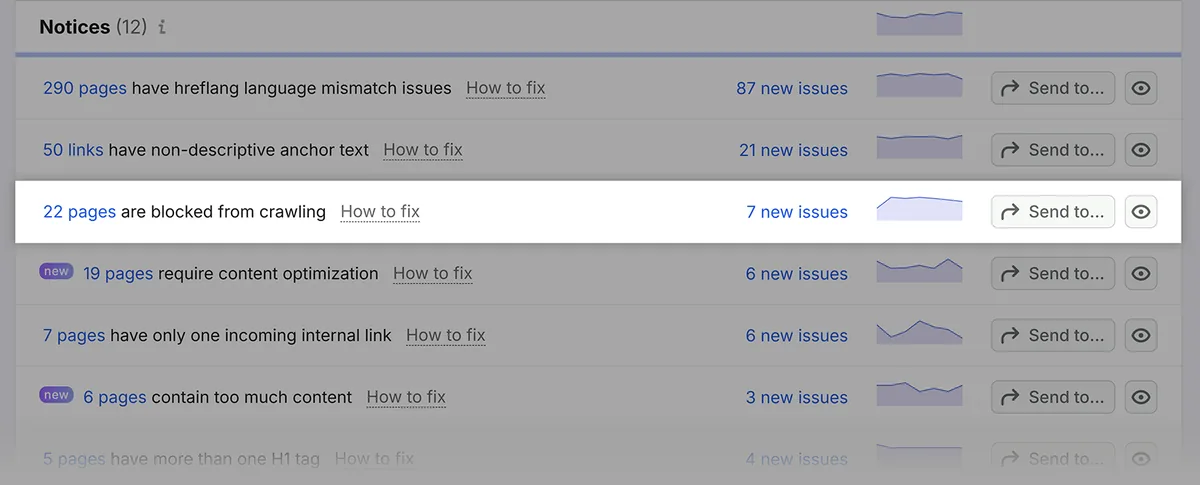
Site Audit 会针对通过 robots.txt 或 noindex 被屏蔽的页面发出警告。
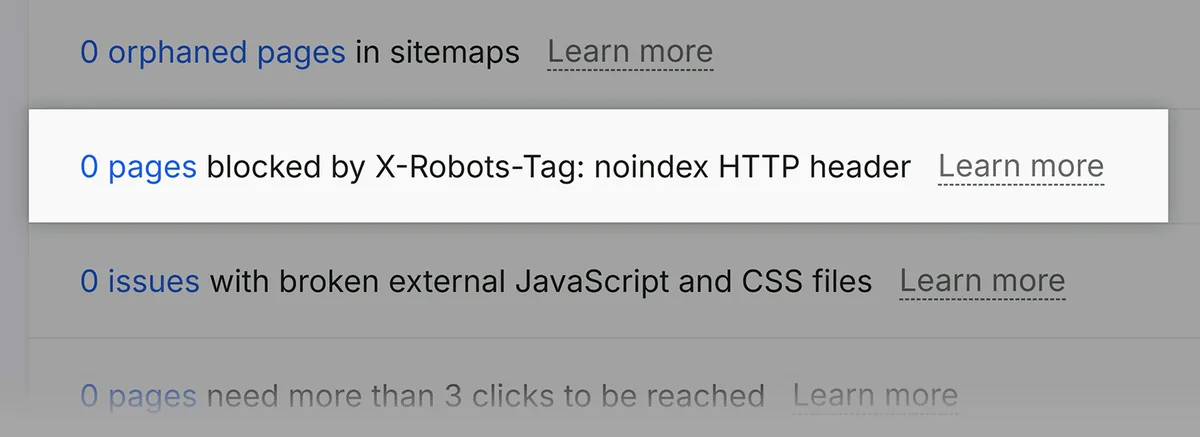
Site Audit 也会提示被 x-robots-tag 屏蔽的资源,这类标签通常用于 PDF 等非 HTML 文档。
规范标签使用不当
规范标签使用不当、把 Google 指向错误的 URL,会导致期望出现的页面无法展示在搜索结果中。
在 GSC 的“页面索引”报告中找出使用不当的规范标签:
- 滚动到“页面未被索引的原因”
- 点击“带有正确规范标签的备用页面”
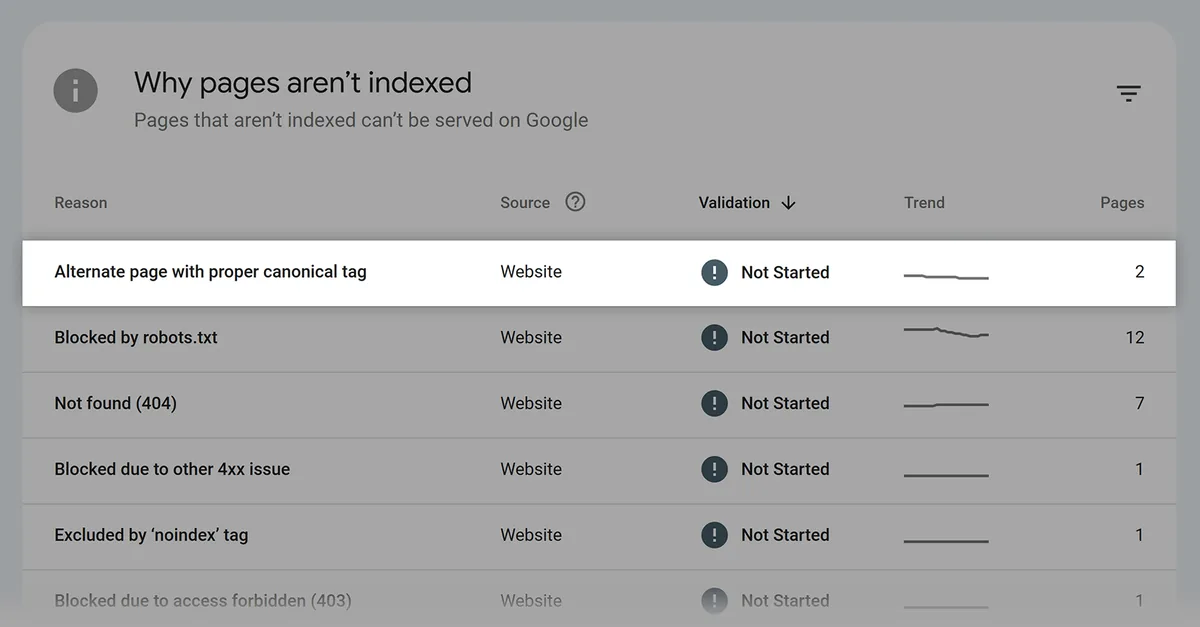
查看受影响的页面列表。若其中有希望被索引的页面(说明规范标签用错了),就调整该页面所有版本的规范标签,使其指向偏好的版本。
内链问题
内链问题会阻碍爬虫发现页面,导致这些页面无法进入 Google 索引。
在 Site Audit 的“内链”专题报告中查找内链问题。报告会列出一份内链问题清单,点击任一问题的数量链接即可查看受影响的页面。
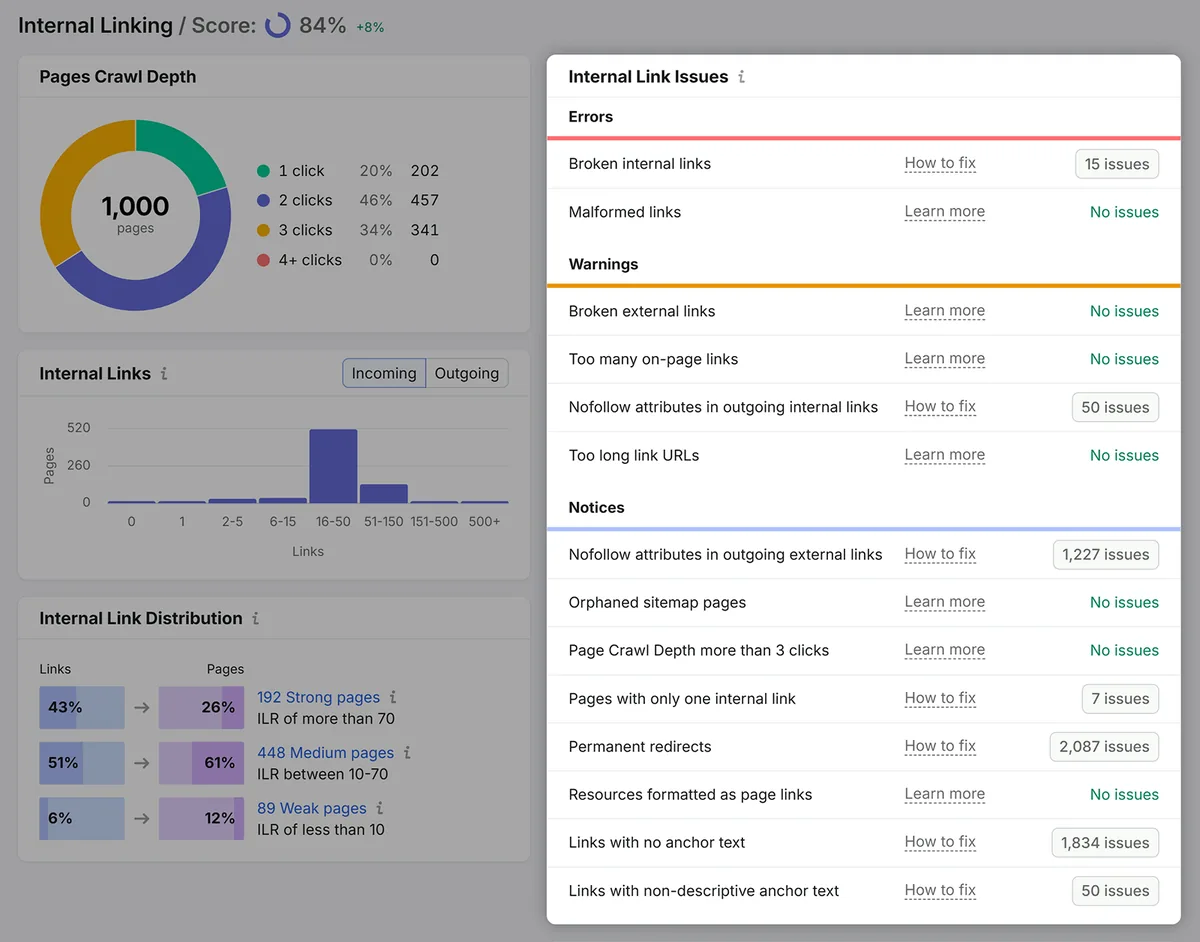
以下是抓取和索引方面最需要处理的问题:
- 出站内链中的 nofollow 属性:nofollow 链接通常要求 Google 不跟随该链接、也不向其传递权重;站内链接若使用了 nofollow,Google 可能会忽略这些页面
- 页面抓取深度超过 3 次点击:若从首页需要点击三次以上才能到达某个页面,它就可能不会被抓取和索引。为这些页面补充内链(并检查网站架构)。
- 站点地图中的孤立页面:没有任何内链指向的页面称为“孤立页面”。由于 Google 难以发现,它们很少被索引。通过链接指向孤立页面即可解决。
构建内链时,优先链接到最重要的页面,同时主动链接到新页面,以加快索引。
404 错误
服务器找不到某个页面时就会返回 404 错误,这会阻碍 Google 找到并索引该页面。
404 错误还会损害用户体验。
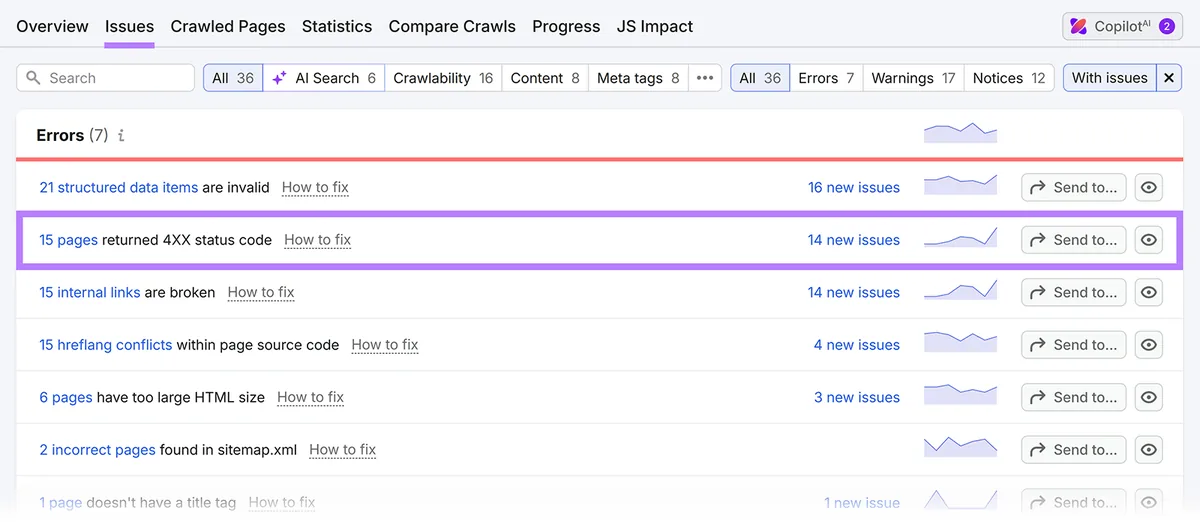
在 Site Audit 的“问题”选项卡中查找网站的 404 错误,点击“# 个页面返回了 4XX 状态码”中的链接。
对每个“404”页面,点击“查看失效链接”,查看哪些页面链接到了它。
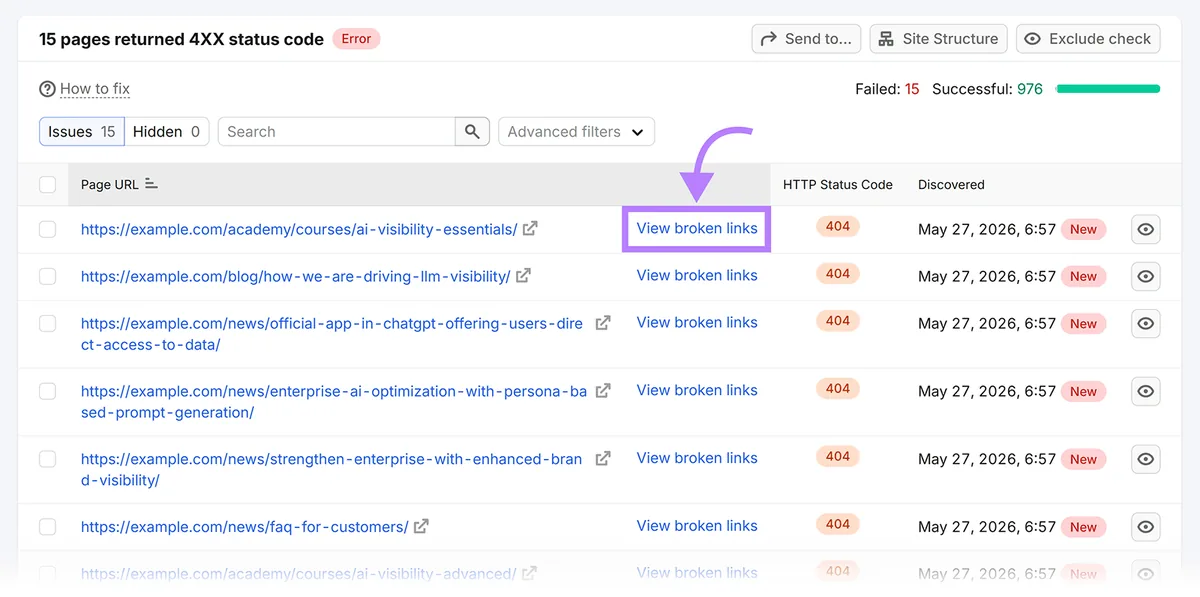
修复 404 错误的方式包括:修正 URL 拼写错误、把链接更新到新页面位置,或在内容已不存在时用相关替代内容替换链接。
重复内容
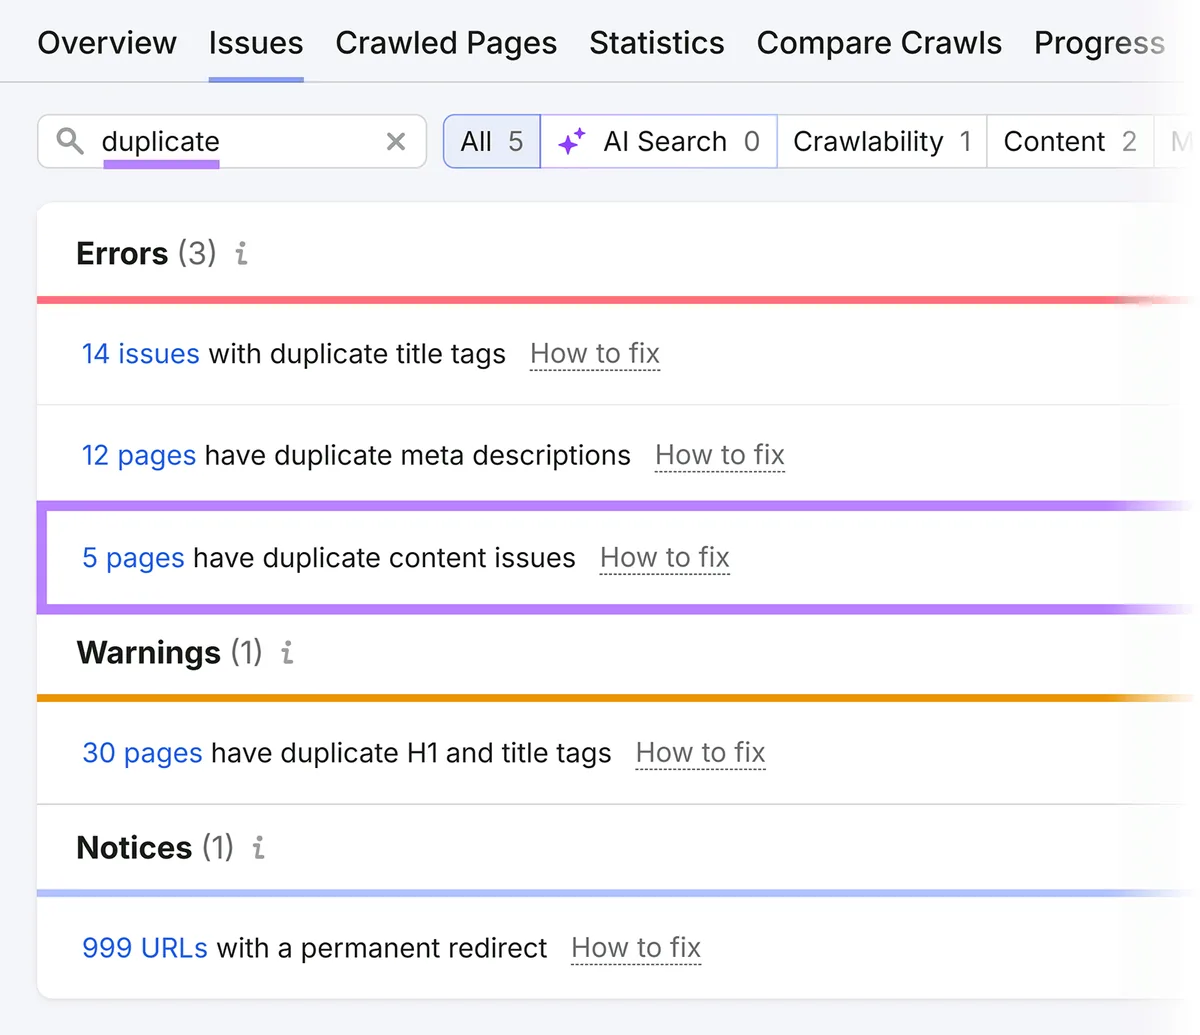
重复内容(多个 URL 上相同或高度相似的内容)会让搜索引擎困惑,还可能导致不期望的页面被索引。
点击 Site Audit 中的“问题”,搜索“duplicate”,再点击“# 个页面存在重复内容问题”中的超链接。
通过以下方式修复重复内容问题:
- 消除不需要的重复内容:把内容合并到主页面、删除重复内容,并对主页面设置301 重定向
- 保留必要的重复内容:使用规范标签来指明偏好的版本
网站质量不佳
网站质量不佳会降低被索引的机会,因为 Google 优先抓取和索引它认定的高质量网站。
以下三种方法可让网站对 Google 显得可信:
创建高质量内容
创作真正能帮助读者的高质量内容,能提高被索引并出现在搜索结果中的机会。
可按以下要点创作优质内容:
- 满足用户需求:给出可执行的方案,解决相关问题,回答关键疑问
- 展现专业能力:发布由主题专家撰写、包含真实案例与一方数据的内容
- 保持内容最新:定期更新,填补空白并修正过时信息,以维持相关性
建设相关外链
从相关的高质量网站建设外链,能为 Google 提供更多发现页面的途径,也能传递权威性信号。
以下是一些外链建设策略:
- 客座文章:为所在细分领域的有声誉网站撰稿,触达新受众,并有机会获得外链
- 向专家投稿专栏:找出邀请竞争对手发声的出版物或播客,将自己作为专家来源推荐过去。许多出版物乐于链接到来源方网站。
- 内容替换:找出竞争对手获得过链接的内容,创作一个明显更好的版本,再作为升级版推荐给同一批出版物
- 竞品外链分析:找出竞争对手的链接来源,通过外联复制其中最优质的机会
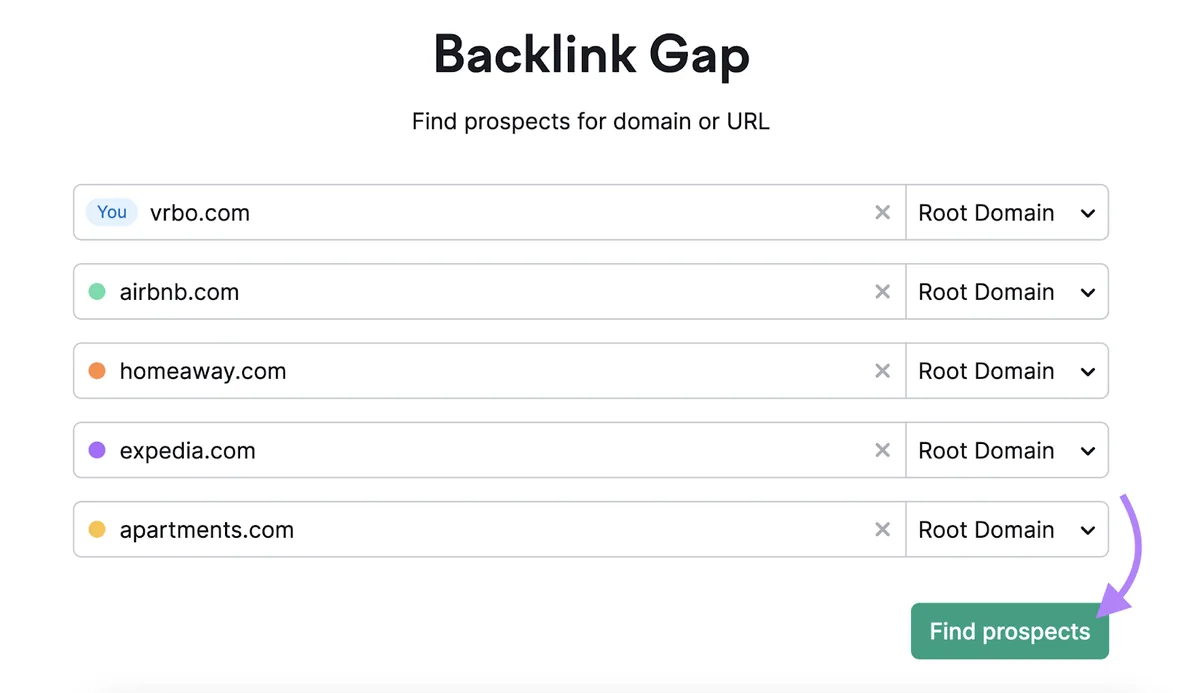
用 Backlink Gap 做竞品外链分析。输入自己的域名和最多四个竞争对手的域名,点击“Find prospects”。
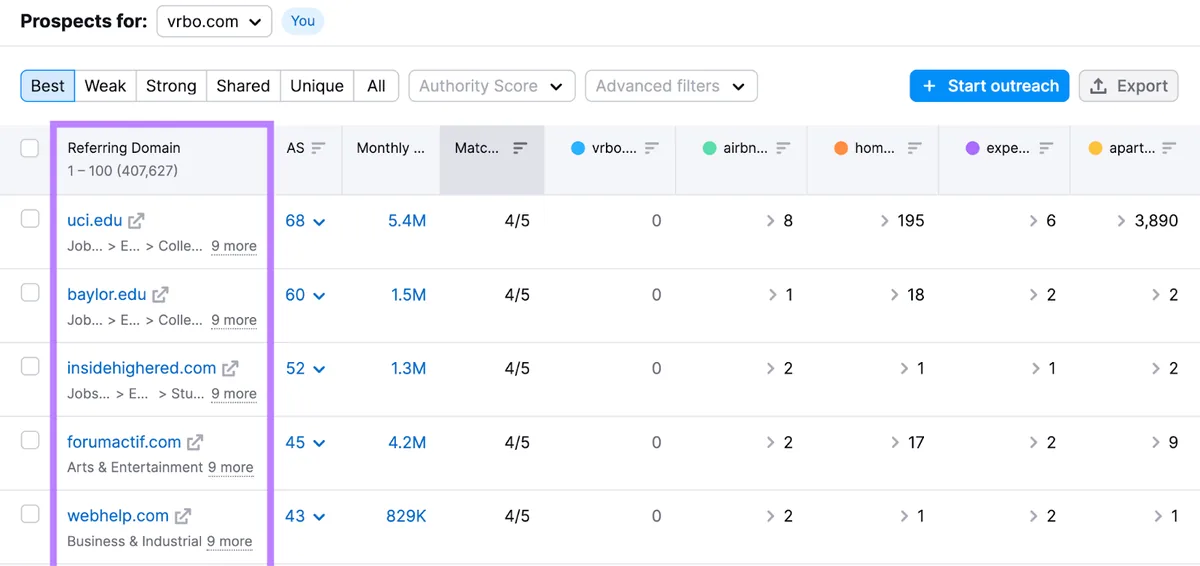
Backlink Gap 的“最佳”选项卡会列出链接了所有竞争对手、却没有链接你的网站。这类网站通常值得争取——它们既然已经在链接你的全部竞争对手,很可能也愿意链接你。
优先重视 E-E-A-T
聚焦经验、专业、权威和可信(E-E-A-T)——这是 Google 人工质量评估员评估页面质量的标准——有助于内容符合 Google 对良好内容的定义。
E-E-A-T 并非 Google 的排名因素,但遵循这一框架有助于创作优质内容。
要强化 E-E-A-T,应力求做到以下几点:
- 提供透明的作者信息。突出撰稿人在所写主题上的亲身经历和专业能力。
- 与主题专家协作。纳入行业专家的见解,或聘请他们审核内容的准确性。
- 为论断提供支撑。在发布的所有内容中引用可信来源,让读者知道信息来自有声誉的一方。
监控网站的索引问题
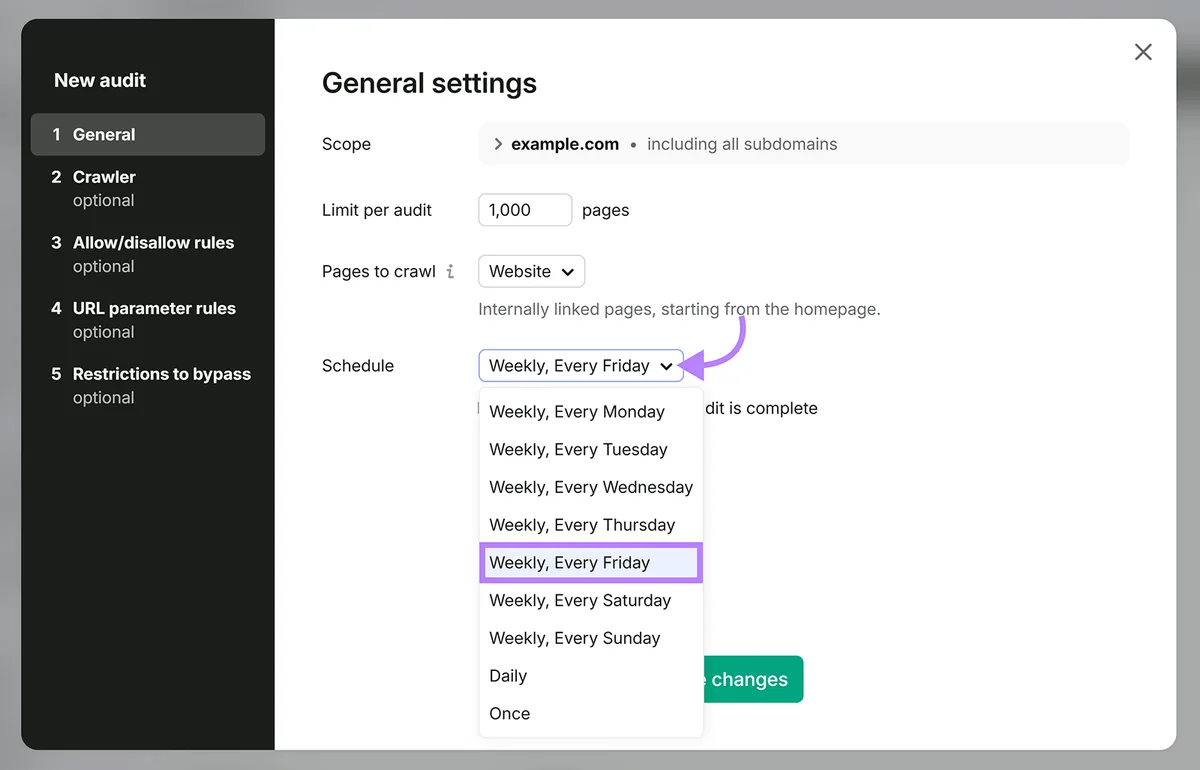
通过安排定期审计来监控索引问题,一旦出现问题就能立即发现。
使用 Site Audit,可将审计安排为每周或每天运行,出现新问题时即可立刻收到提醒。
想马上发现并修复索引问题?立即试用 Site Audit。