15 个可抓取性问题及修复方法
可抓取性问题会阻止搜索引擎访问网站页面,进而影响排名。以下列出 15 类常见问题及对应的排查与修复方法。
你是否曾疑惑,为什么有些页面没有出现在 Google 的搜索结果中?
可抓取性问题可能就是原因。
本指南会解释什么是可抓取性问题、它们如何影响 SEO,还有修复方法。
下面开始。
什么是可抓取性问题?
可抓取性问题会阻止搜索引擎访问你网站的页面。
Google 等搜索引擎使用自动化机器人读取和分析你的页面,这个过程被称为抓取。
存在可抓取性问题时,这些机器人可能遇到障碍,无法正常访问你的页面。
常见的可抓取性问题包括:
- Nofollow 链接(它告诉 Google 不要跟踪该链接,也不要把排名权重传递给那个页面)
- 重定向循环(当两个页面互相重定向,形成无限循环时)
- 糟糕的网站结构
- 缓慢的网站速度
可抓取性问题如何影响 SEO?
可抓取性问题会让搜索引擎看不到你部分或全部页面,严重损害 SEO 表现。
搜索引擎找不到页面,就无法索引它们,也就无法把它们存入数据库,以便日后在相关搜索结果中展示。
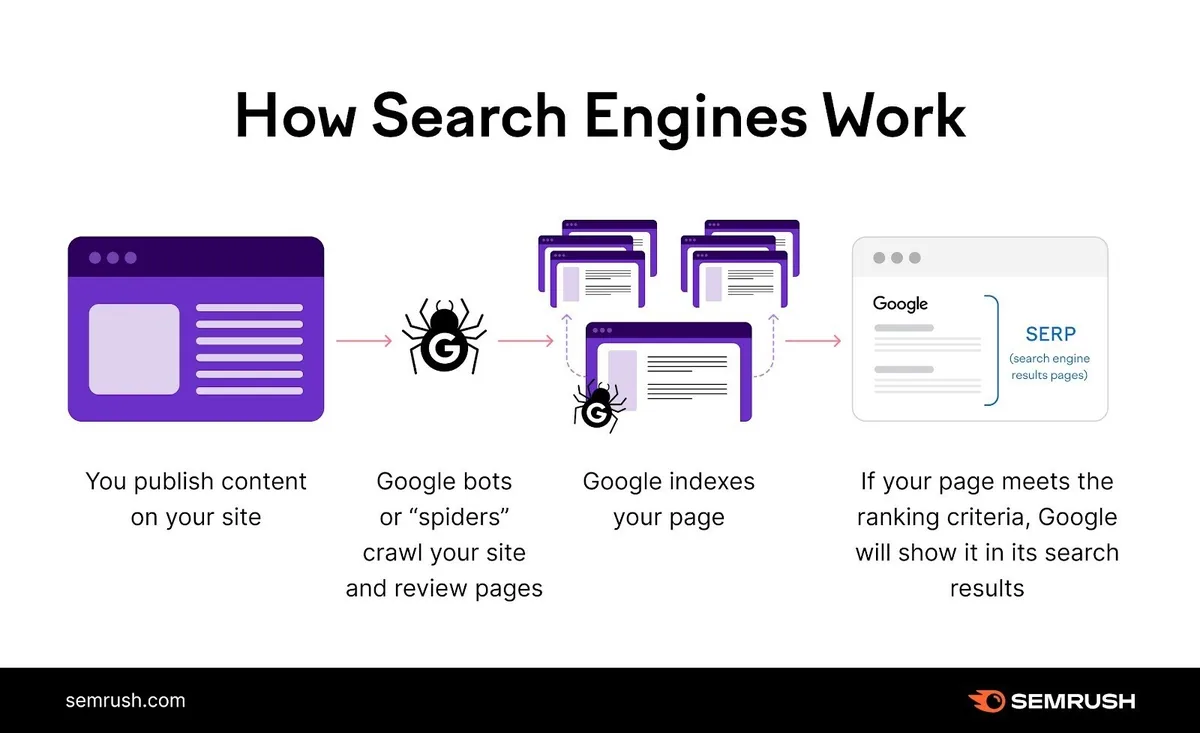
这会造成自然流量和转化的潜在损失。
页面必须同时可抓取且可索引,才能在搜索引擎中排名。
15 个可抓取性问题及修复方法
1. 页面被 robots.txt 屏蔽
搜索引擎会先检查你的 robots.txt 文件,以确定哪些页面应抓取、哪些不应抓取。
若 robots.txt 文件如下所示,则整个网站都被禁止抓取:
要解决这个问题,把“Disallow”指令替换为“Allow”,让搜索引擎能够访问整个网站:
某些情况下,只有特定页面或目录被屏蔽。例如:
这里“/products/”子文件夹中的所有页面都被禁止抓取。
要解决这个问题,把指定的子文件夹或页面从“Disallow”指令中移除。
空的“Disallow”指令表示没有任何需要禁止的页面:
也可以如前所示,用“Allow”指令代替“Disallow”,指示搜索引擎抓取整个站点。
2. Nofollow 链接
nofollow 标签告诉搜索引擎不要抓取网页上的链接。
该标签的形式如下:
页面存在这个标签时,搜索引擎可能不会抓取你链接到的页面,在网站上造成可抓取性问题。
使用 Semrush 的网站审计工具检查 nofollow 链接:
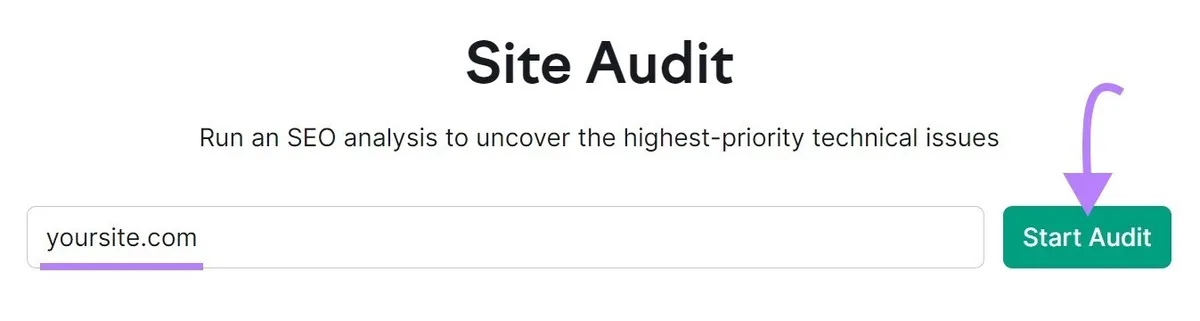
1. 打开工具,输入你的网站,点击“开始审计”。
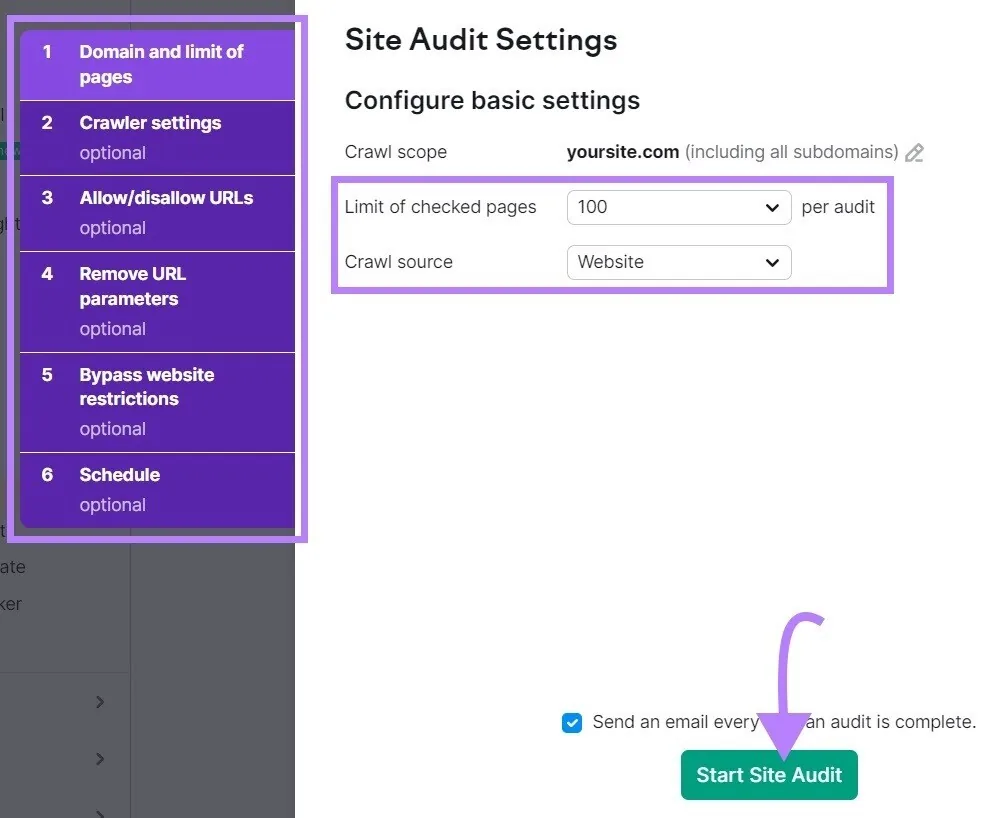
2. 出现网站审计设置窗口。配置好基本设置,点击“开始网站审计”。
3. 审计完成后,进入“问题”标签页,搜索“nofollow”。
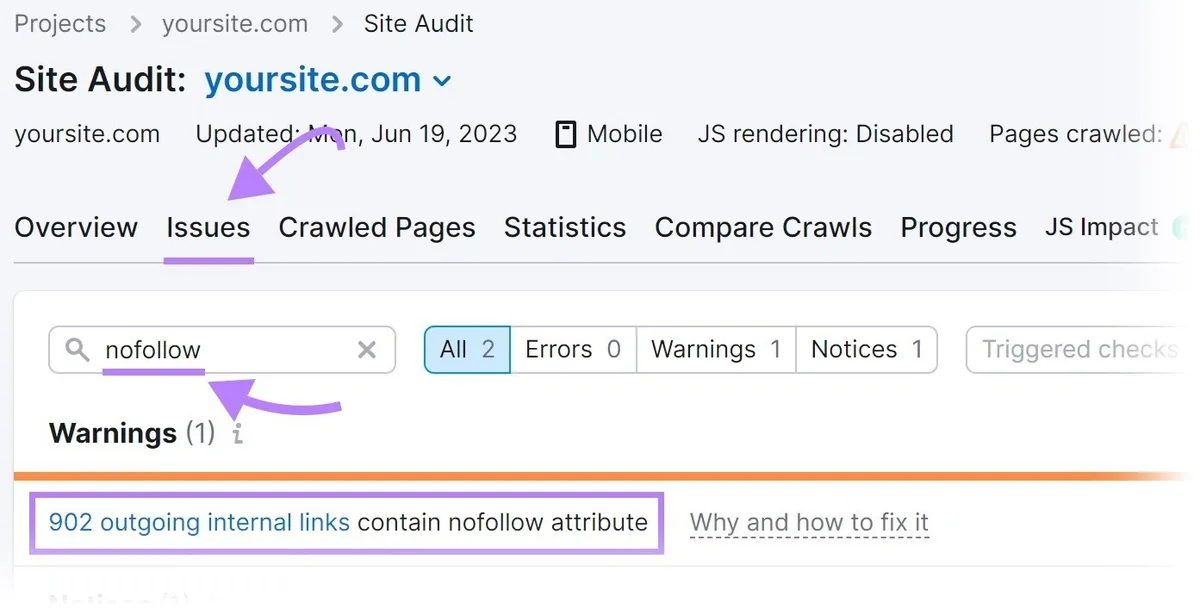
4. 若检测到 nofollow 链接,点击“# 个内部出站链接包含 nofollow 属性”,查看带有 nofollow 标签的页面列表。
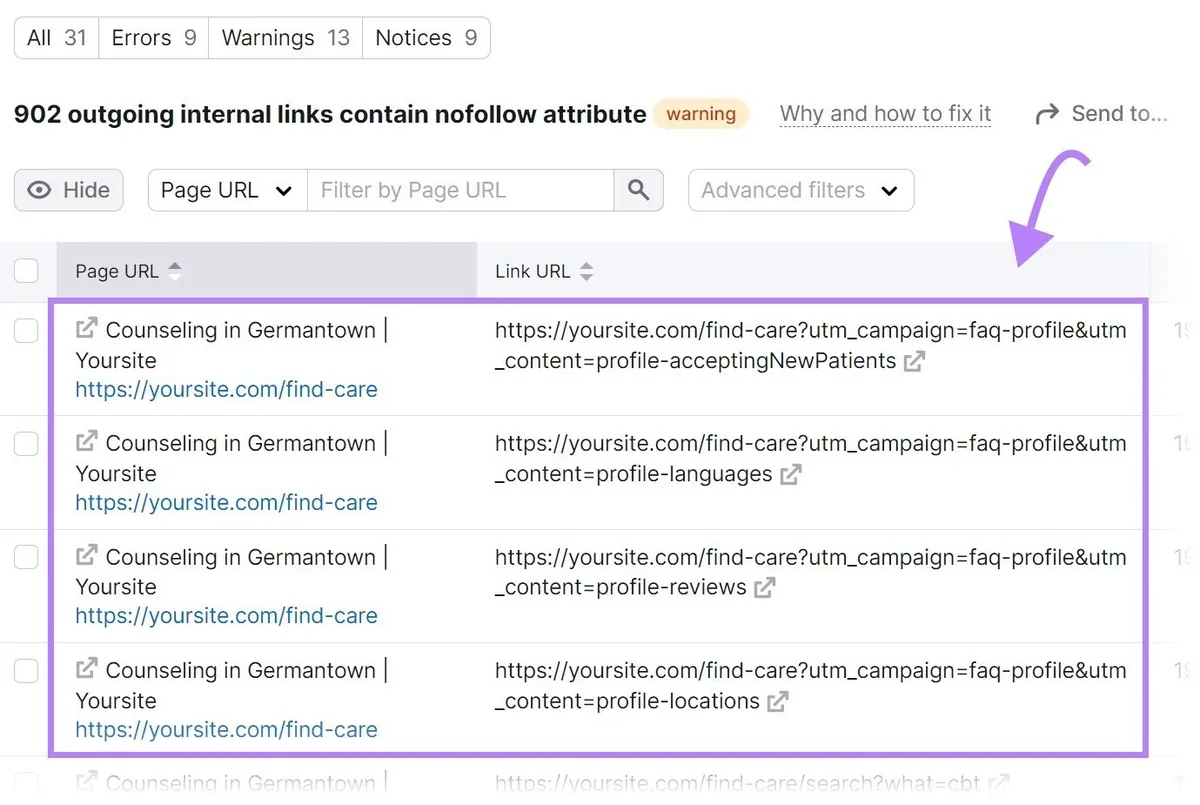
5. 检查这些页面,若 nofollow 标签本不该存在,就将其移除。
3. 糟糕的网站架构
网站架构指页面在整个网站中如何组织。
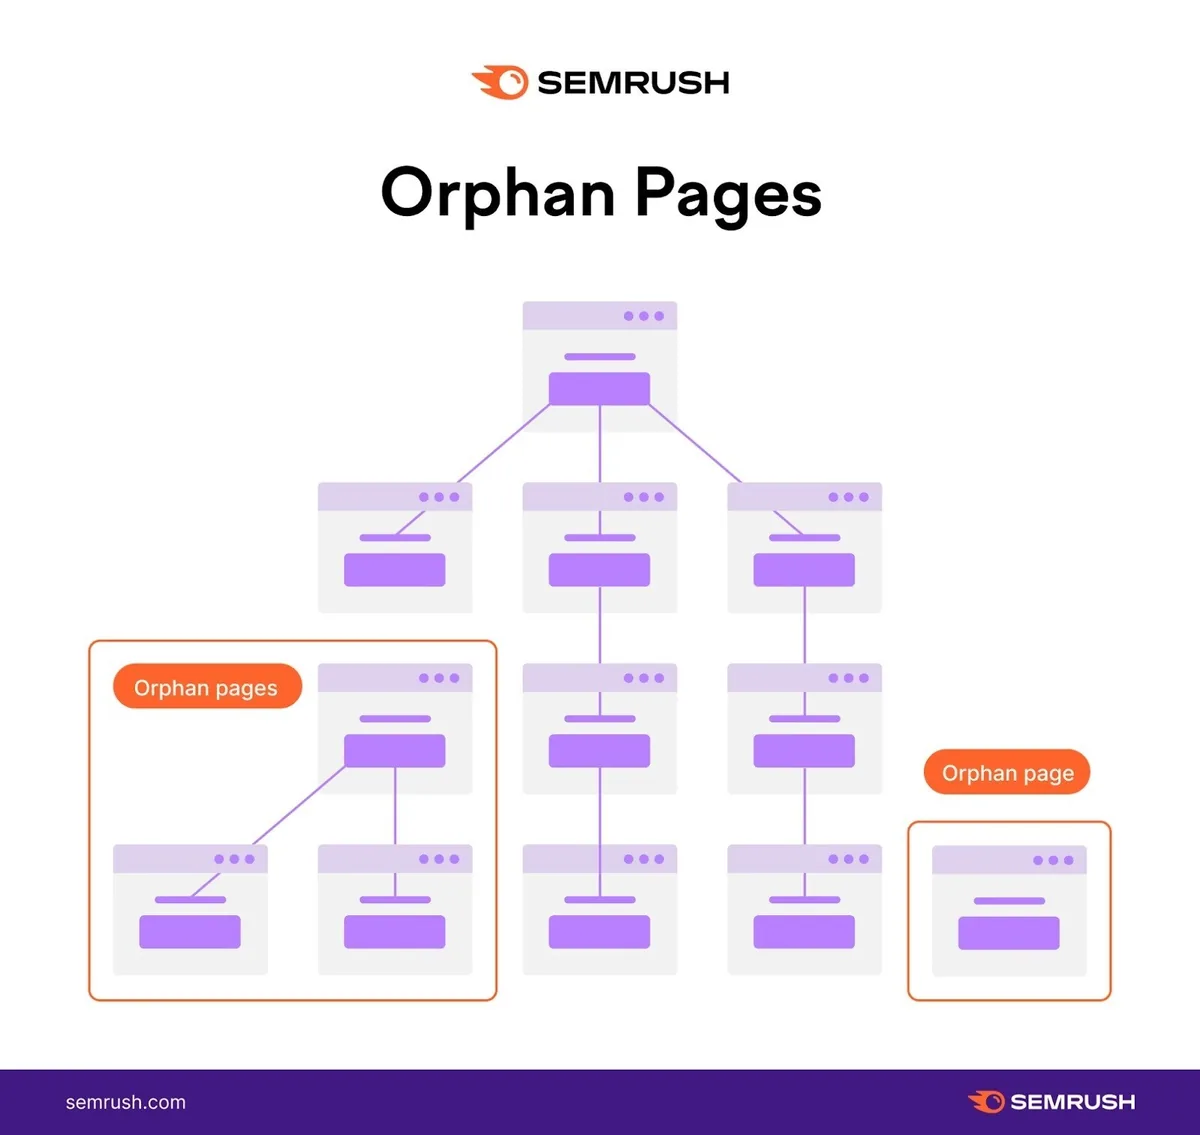
良好的网站架构能确保每个页面都只需点击几次即可从首页到达,且没有孤立页面(即没有任何内链指向的页面)。
这有助于搜索引擎轻松访问所有页面。
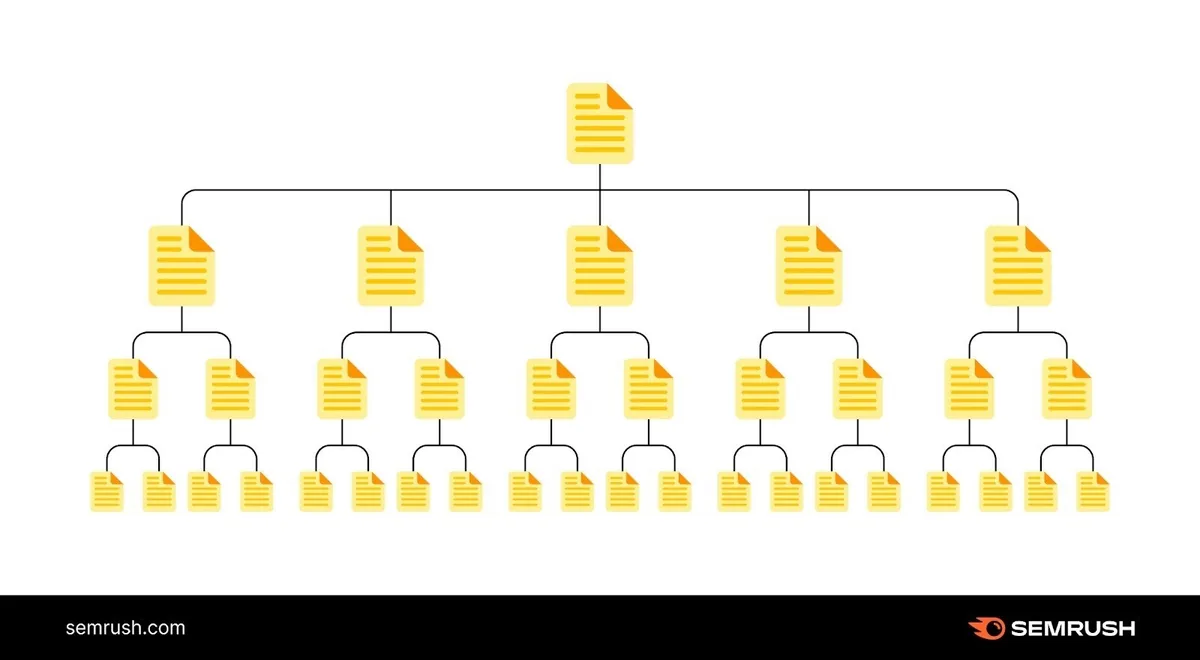
然而,糟糕的网站架构会造成可抓取性问题。
来看下面这个示例站点结构,它存在孤立页面。
由于从首页到这些页面没有可沿链接到达的路径,搜索引擎抓取网站时可能找不到它们。
解决办法很直接:创建一个通过内链把页面按层级合理组织的站点结构。
例如:
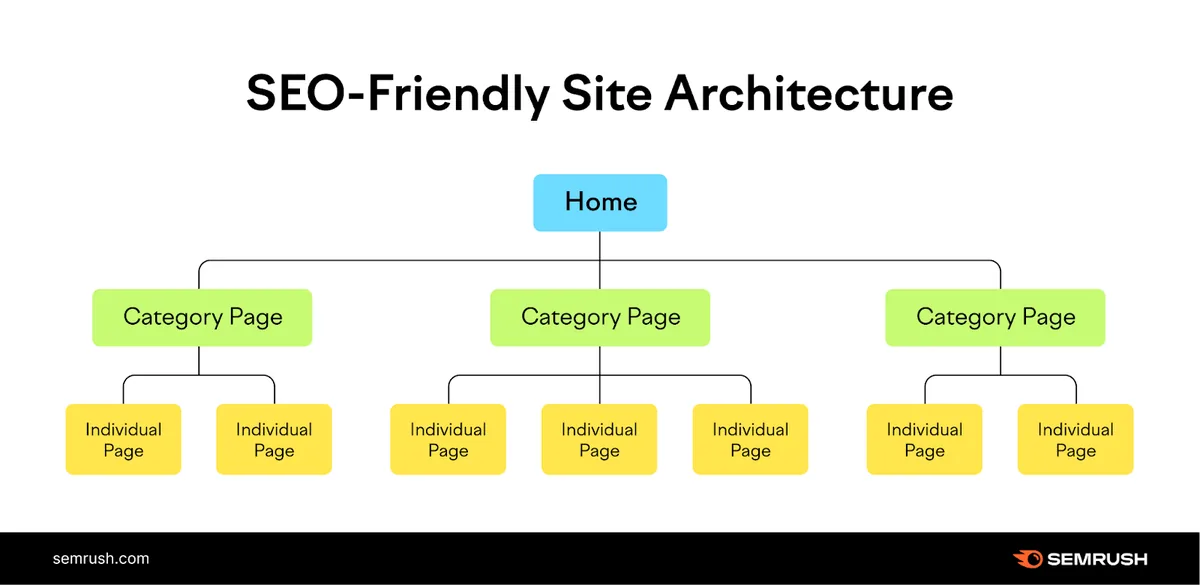
在上面的示例中,首页链接到分类页面,分类页面再链接到网站上的各个独立页面。
这为抓取机器人找到你所有重要页面提供了一条清晰路径。
4. 缺少内链
没有内链的页面会造成可抓取性问题。
搜索引擎很难发现缺少内链的页面。
要避免这些问题,找出孤立页面并给它们添加内链。
如何找到孤立页面?
使用 Semrush 的网站审计工具。
配置好工具并运行一次审计,然后进入“问题”标签页,搜索“orphan”。
工具会显示网站上的任何孤立页面。
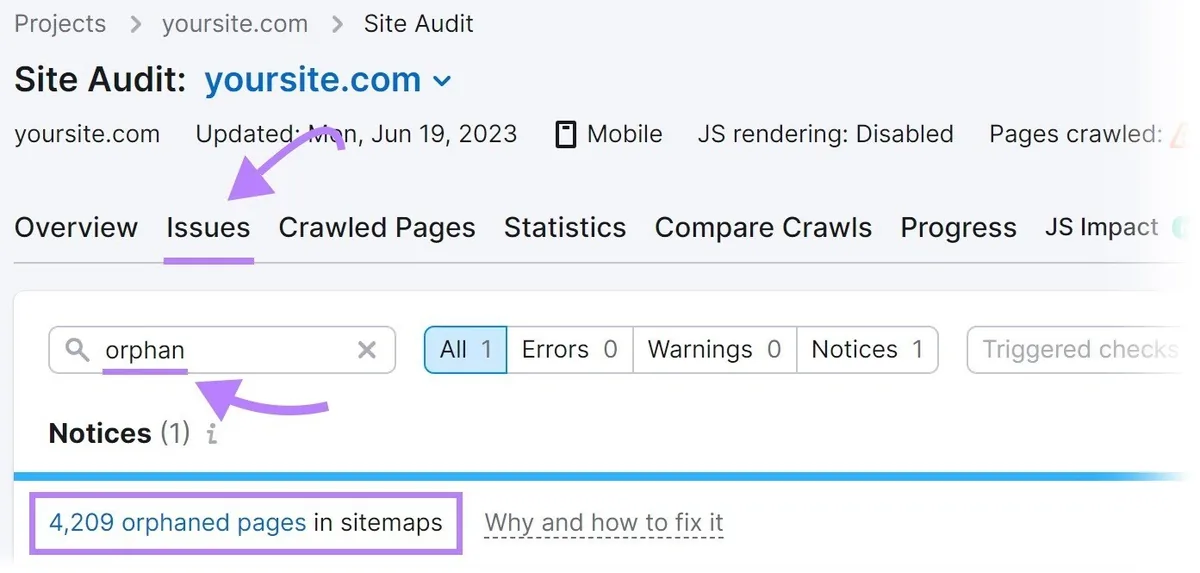
要解决这个问题,从网站上其他相关页面给孤立页面添加内链。
5. 站点地图管理不当
站点地图列出你希望搜索引擎抓取、索引并排名的网站页面。
若站点地图遗漏了你希望被找到的页面,这些页面可能被忽视,造成可抓取性问题。
使用 XML Sitemaps Generator 之类的工具,把所有应被抓取的页面都包含进来。
要生成站点地图,在工具中输入你的网站 URL,它会自动为你创建。
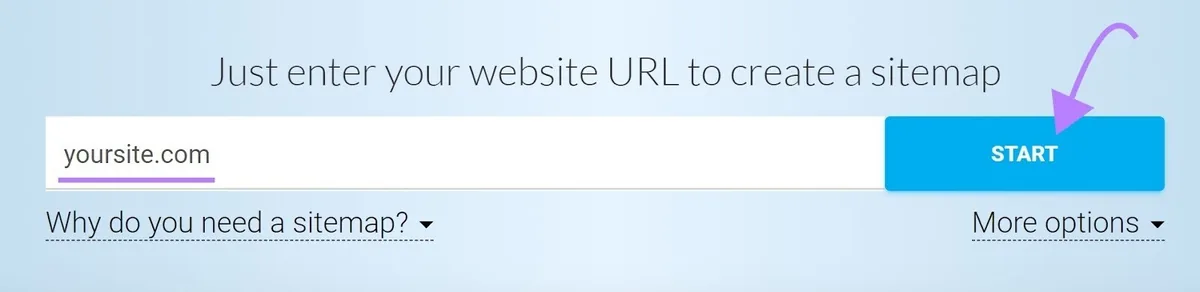
把文件保存为“sitemap.xml”,并上传到网站的根目录。
例如,若你的网站是 www.example.com,站点地图 URL 应为 www.example.com/sitemap.xml。
最后,通过你的 Google Search Console 账号把站点地图提交给 Google。
登录你的账号,点击左侧菜单中的“站点地图”,输入站点地图 URL,然后点击“提交”。
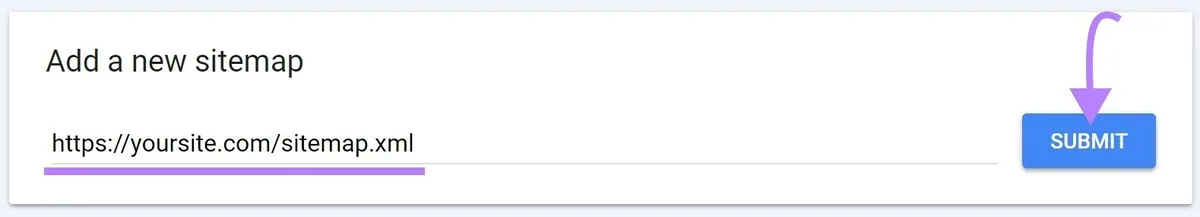
6. “Noindex”标签
“noindex” meta robots 标签会指示搜索引擎不要索引某个页面。
该标签的形式如下:
noindex 标签的用途是控制索引,但若长期留在页面上,就会造成可抓取性问题。
正如 Google 的 John Mueller 所确认的,Google 会把长期的“noindex”标签当作 nofollow 标签处理。
随着时间推移,Google 会完全停止抓取那些页面上的链接。
若页面没有被抓取,长期存在的 noindex 标签可能就是原因。
使用 Semrush 的网站审计工具找出这些页面。在工具中设置项目并运行抓取,完成后进入“问题”标签页,搜索“noindex”。
工具会列出网站上带“noindex”标签的页面。
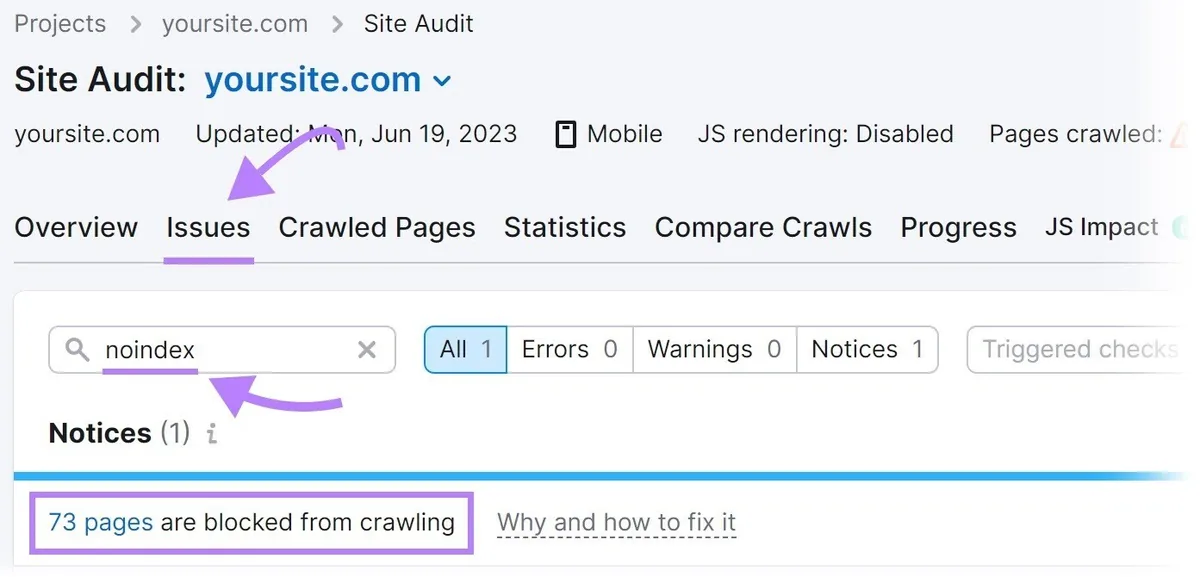
检查这些页面,并在适当之处移除“noindex”标签。
7. 网站速度缓慢
搜索引擎机器人用于抓取网站的时间和资源有限,这被称为抓取预算。
网站速度缓慢会导致页面加载变慢,减少机器人在一次会话中能抓取的页面数量,重要页面可能因此被漏掉。
要解决这个问题,改善网站的整体性能和速度。
可以从我们的页面速度优化指南开始。
8. 内部死链
内部死链指指向网站上失效页面的超链接。
它们会返回 404 错误页面。
死链会显著影响网站的可抓取性,因为它们会阻止搜索引擎机器人访问被链接的页面。
要找出网站上的死链,使用网站审计工具。
进入“问题”标签页,搜索“broken”。
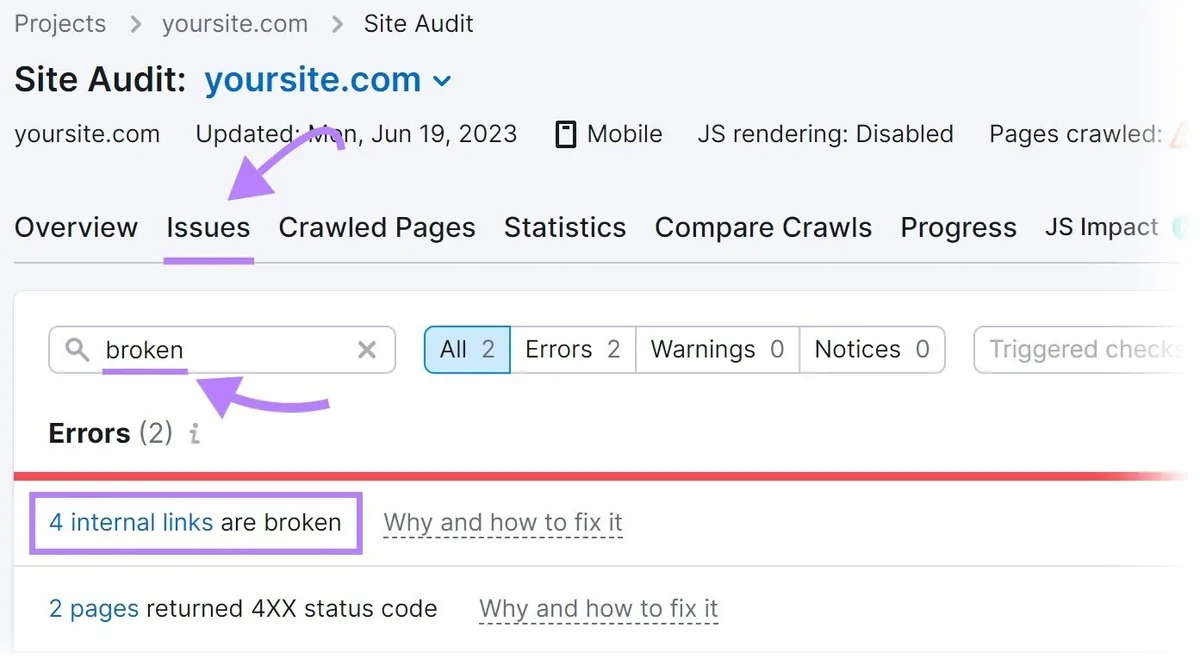
点击“# 个内部链接已断开”,会看到一份列出所有死链的报告。
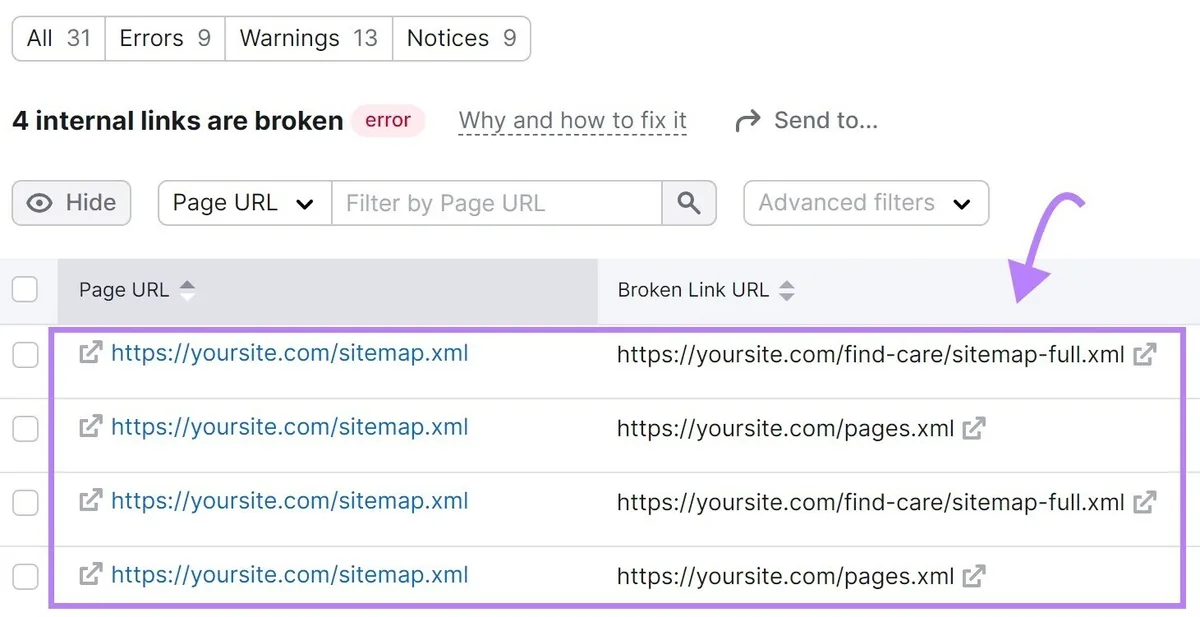
要修复这些死链,可以替换为另一个链接、恢复缺失的页面,或添加一个301 重定向指向网站上其他相关页面。
9. 服务器端错误
服务器端错误,例如 500 HTTP 状态码,会因服务器无法完成请求而扰乱抓取过程。
这会让机器人难以抓取网站内容。
要找出并修复服务器端错误,使用 Semrush 的网站审计工具。进入“问题”标签页,搜索“5xx”。
若存在错误,点击“# 个页面返回了 5XX 状态码”查看受影响页面的完整列表。
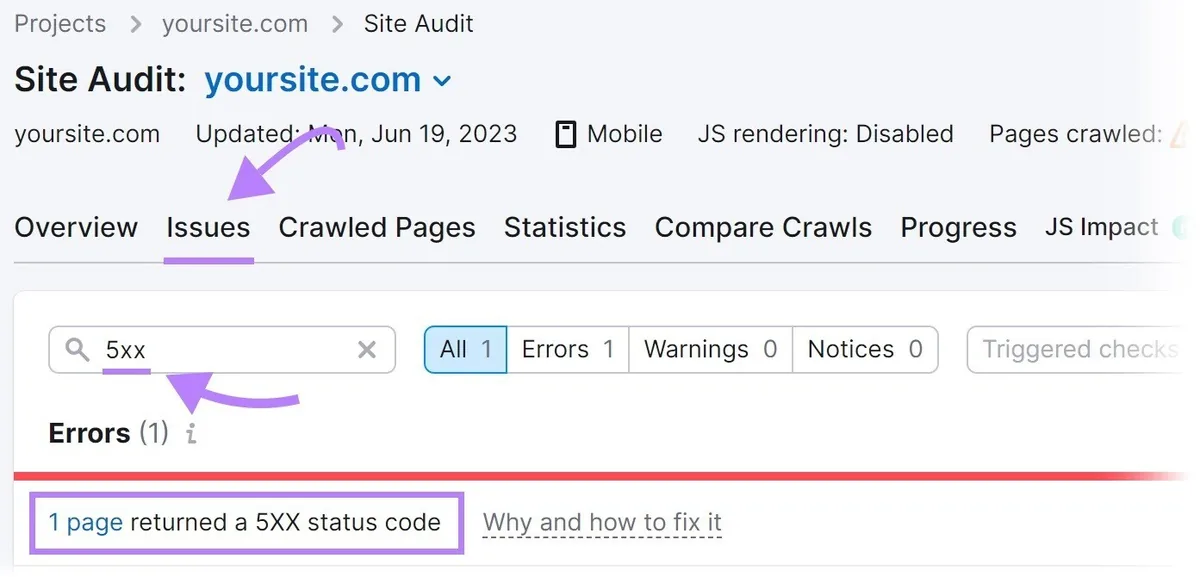
随后把这份列表发给你的开发人员,让他们正确配置服务器。
10. 重定向循环
当一个页面重定向到另一个页面,后者又重定向回原页面、形成不断循环时,就会发生重定向循环。
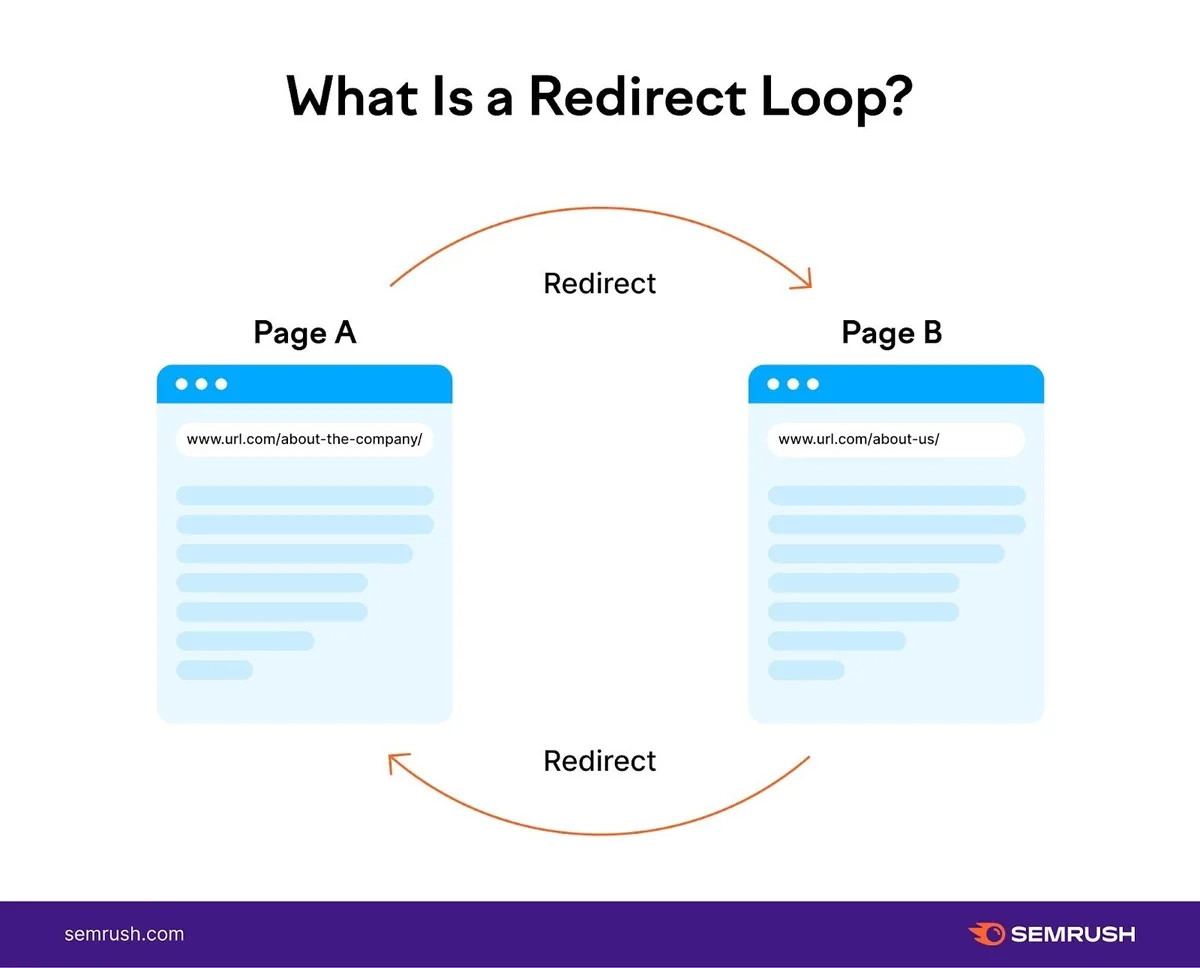
重定向循环会阻止搜索引擎机器人到达最终目标,因为它们会陷入两个或多个页面之间无休止的重定向,白白消耗本可花在重要页面上的抓取预算。
要找出并修复网站上的重定向循环,使用网站审计工具。
进入“问题”标签页,搜索“redirect”。
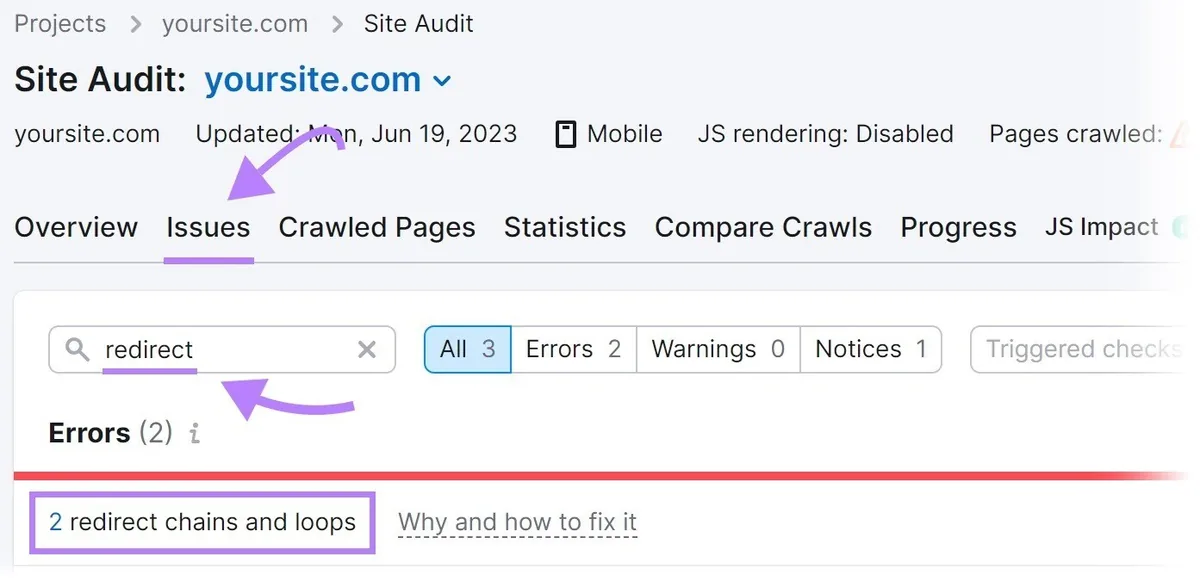
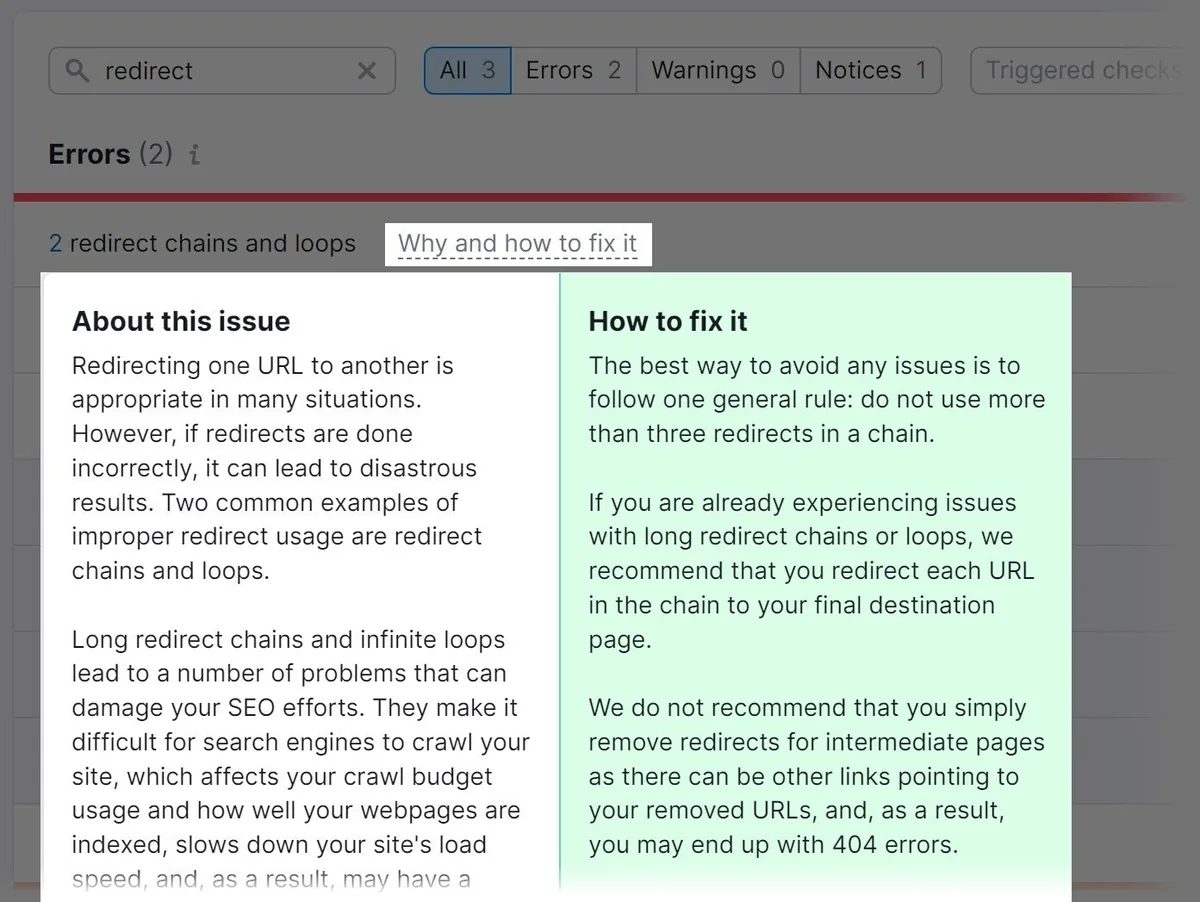
工具会显示任何重定向循环,并在你点击“为什么、如何修复”时提供处理建议。
11. 访问限制
带有访问限制的页面,例如位于登录表单或付费墙之后的页面,会阻止搜索引擎机器人抓取它们。
这些页面可能因此不出现在搜索结果中,限制了用户对它们的可见度。
某些情况下,限制部分页面的访问是合理的。
例如,会员制网站或订阅平台通常会把页面限制给付费会员或注册用户。
这让网站能够提供专属内容、特别优惠或个性化体验,营造价值感,并激励用户订阅或成为会员。
然而,若网站有很大一部分都受到限制,这就成了可抓取性错误。
评估每个页面是否有必要限制访问,只在真正需要的页面上保留限制。
对不需要限制的页面移除限制。
12. URL 参数
URL 参数,也叫查询字符串,是 URL 中位于问号(?)之后的部分,用于辅助追踪和组织。
例如:example.com/shoes?color=blue。
URL 参数会如何影响网站的可抓取性?
URL 参数可以产生几乎无穷无尽的 URL 变体。
这在电商分类页上很常见;应用尺码、颜色或品牌等筛选条件时,URL 会随之改变以反映这些选择。
若网站的商品目录很大,最终可能会有成千上万甚至上百万个 URL。
若这些带参数的 URL 管理不当,Google 可能会把它们浪费掉抓取预算,导致一些重要页面没有被抓取。
你需要判断哪些 URL 参数对搜索有帮助、应该被抓取。
判断方法是了解人们是否会搜索应用某个参数后生成的具体内容。
例如,网购时人们经常按颜色搜索,比如“black shoes”。
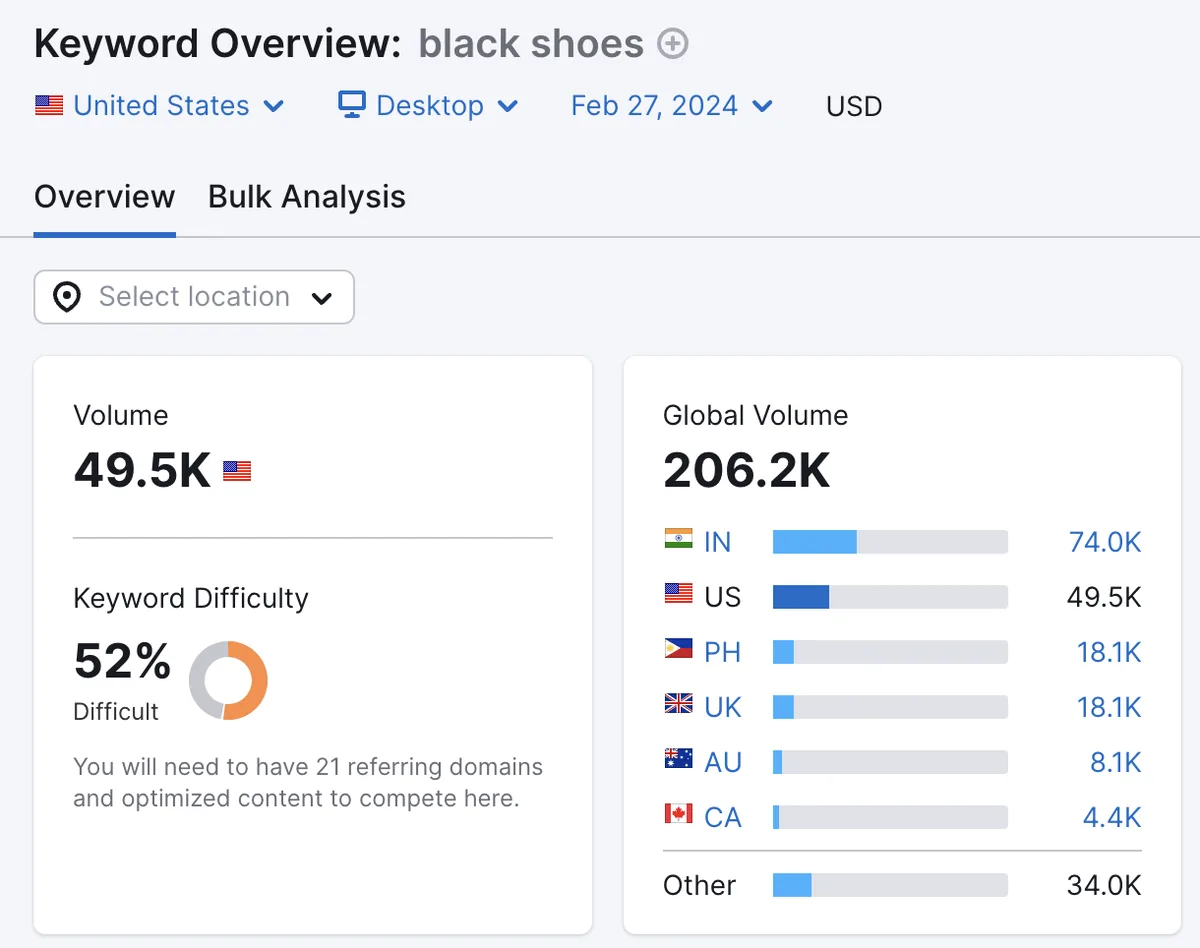
这意味着“color”参数是有帮助的,像 example.com/shoes?color=black 这样的 URL 应该被抓取。
但有些参数对搜索没有帮助,不应被抓取。
例如,“rating”参数会按客户评分筛选产品,如 example.com/shoes?rating=5。
很少有人按客户评分搜索鞋子。
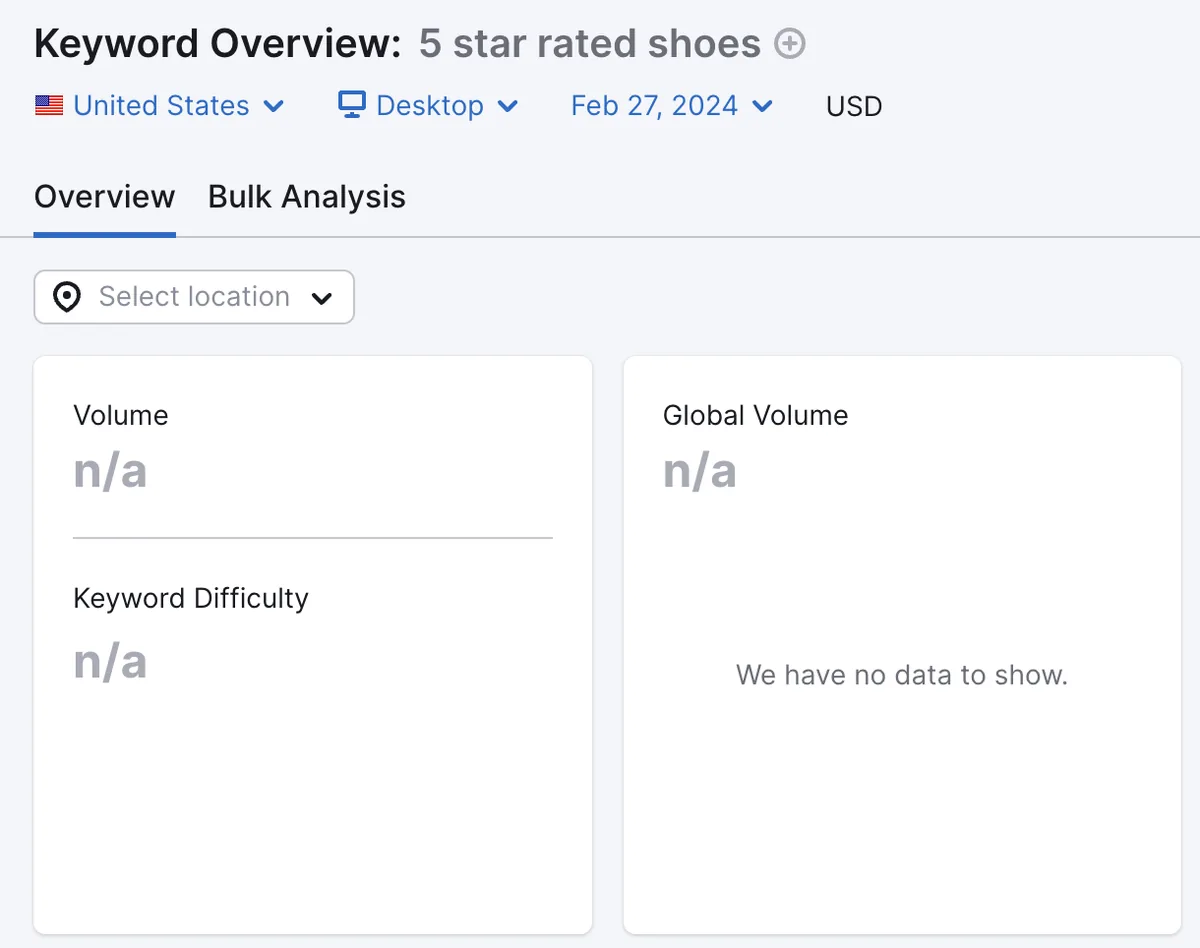
因此,应阻止对搜索没有帮助的 URL 被抓取,要么使用 robots.txt 文件,要么给指向这些带参数 URL 的内链添加 nofollow 标签。
这样能确保抓取预算被高效地用在正确的页面上。
13. JavaScript 资源被 robots.txt 屏蔽
许多现代网站使用 JavaScript,它包含在 .js 文件中。
通过 robots.txt 屏蔽对这些 .js 文件的访问会造成可抓取性问题,尤其是屏蔽了关键的 JavaScript 文件时。
例如,若屏蔽了某个加载页面主要内容区域的 JavaScript 文件,抓取机器人可能就无法看到那些内容。
检查 robots.txt 文件,确保没有屏蔽重要的 JavaScript 文件。
或者使用 Semrush 的网站审计工具,进入“问题”标签页,搜索“blocked”。
若检测到问题,点击蓝色链接。
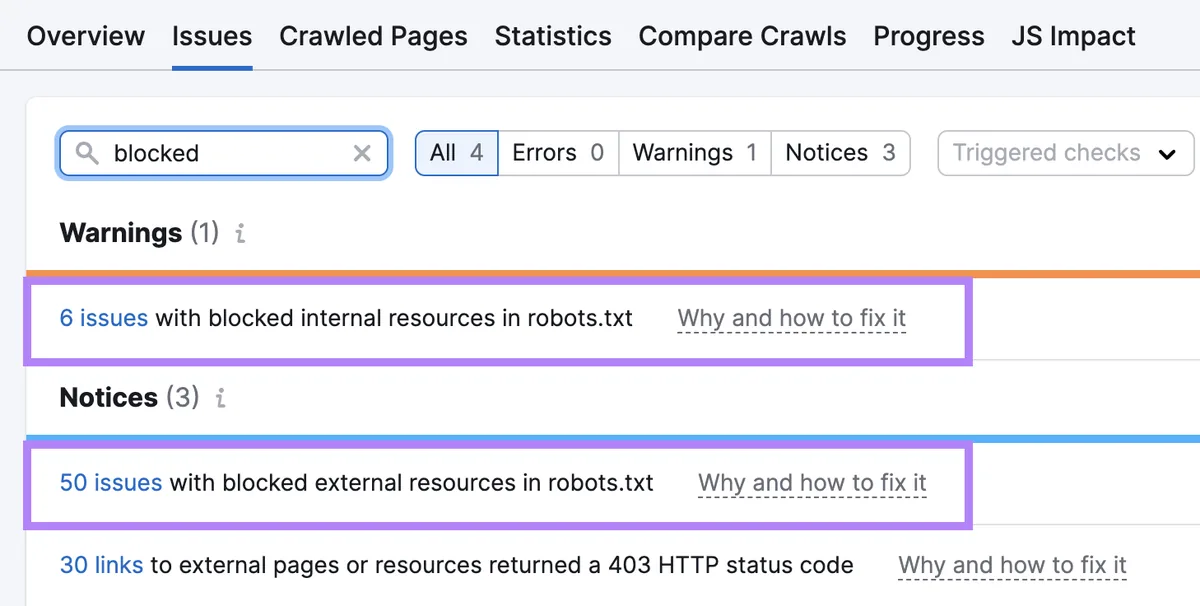
你会看到被屏蔽的确切资源。
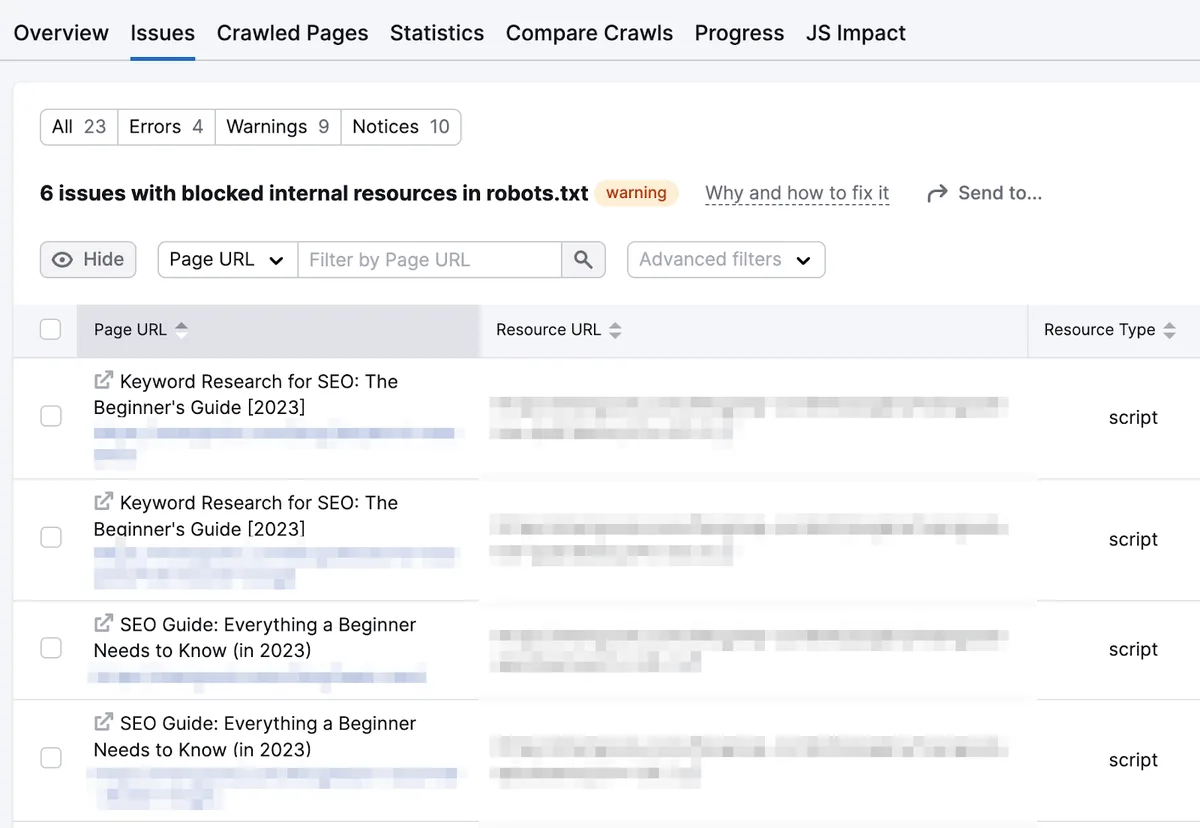
此时咨询你的开发人员。
他们能判断哪些 JavaScript 文件对网站的功能和内容可见度至关重要、不应被屏蔽。
14. 重复内容
重复内容指出现在网站多个页面上的相同或几乎相同的内容。
假设你发布了一篇可通过多个 URL 访问的博客文章:
- example.com/blog/your-post
- example.com/news/your-post
- example.com/articles/your-post
尽管内容相同,不同 URL 会导致搜索引擎把它们全都抓取一遍。
这会浪费掉本可更好地花在其他重要页面上的抓取预算。
使用 Semrush 的网站审计工具找出并消除这些问题。
进入“问题”标签页,搜索“duplicate content”。工具会显示是否检测到错误。
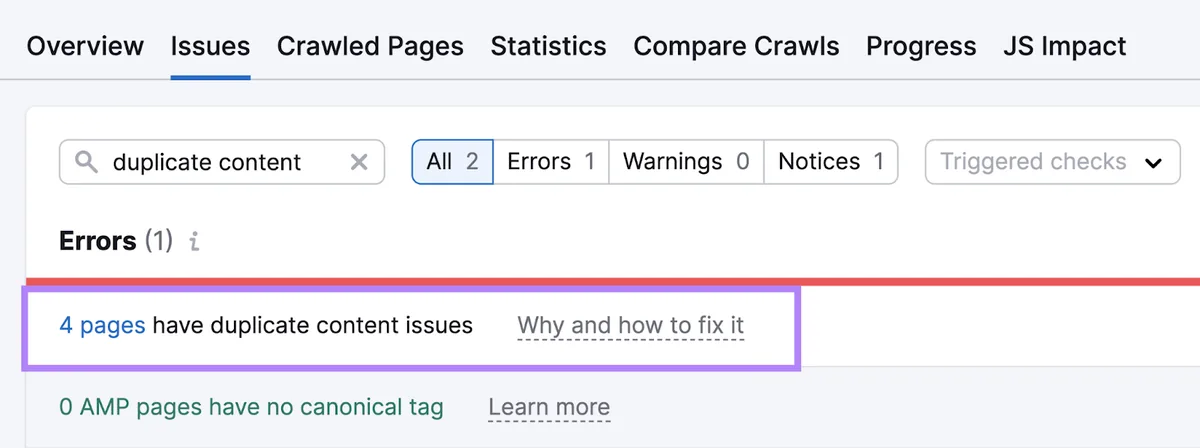
点击“# 个页面存在重复内容问题”链接,查看所有受影响页面的列表。
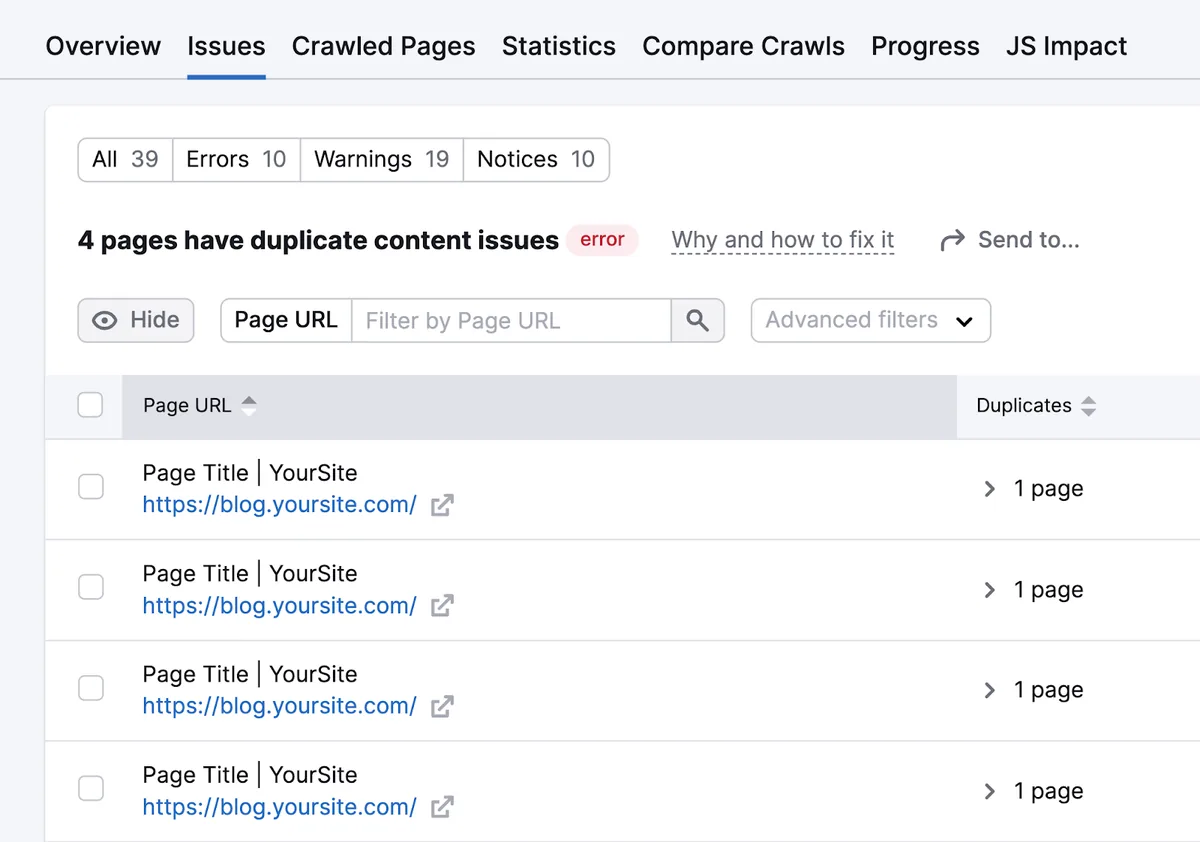
若重复是失误造成的,把这些页面重定向到你想保留的主 URL。
若重复是必要的——例如故意把相同内容放在多个板块以触达不同受众——可以实施规范标签。
规范标签能帮助搜索引擎识别你希望被索引的主页面。
15. 糟糕的移动端体验
Google 使用移动优先索引,也就是说它在抓取和索引时优先看网站的移动版,而非桌面版。
若站点在移动设备上加载时间很长,就会影响可抓取性,Google 可能需要分配更多时间和资源来抓取整个网站。
若站点不具备响应式——无法适应不同的屏幕尺寸,或在移动设备上无法正常运作——Google 可能更难理解你的内容、访问其他页面。
要解决这个问题,检查网站,看它在移动设备上如何运作。
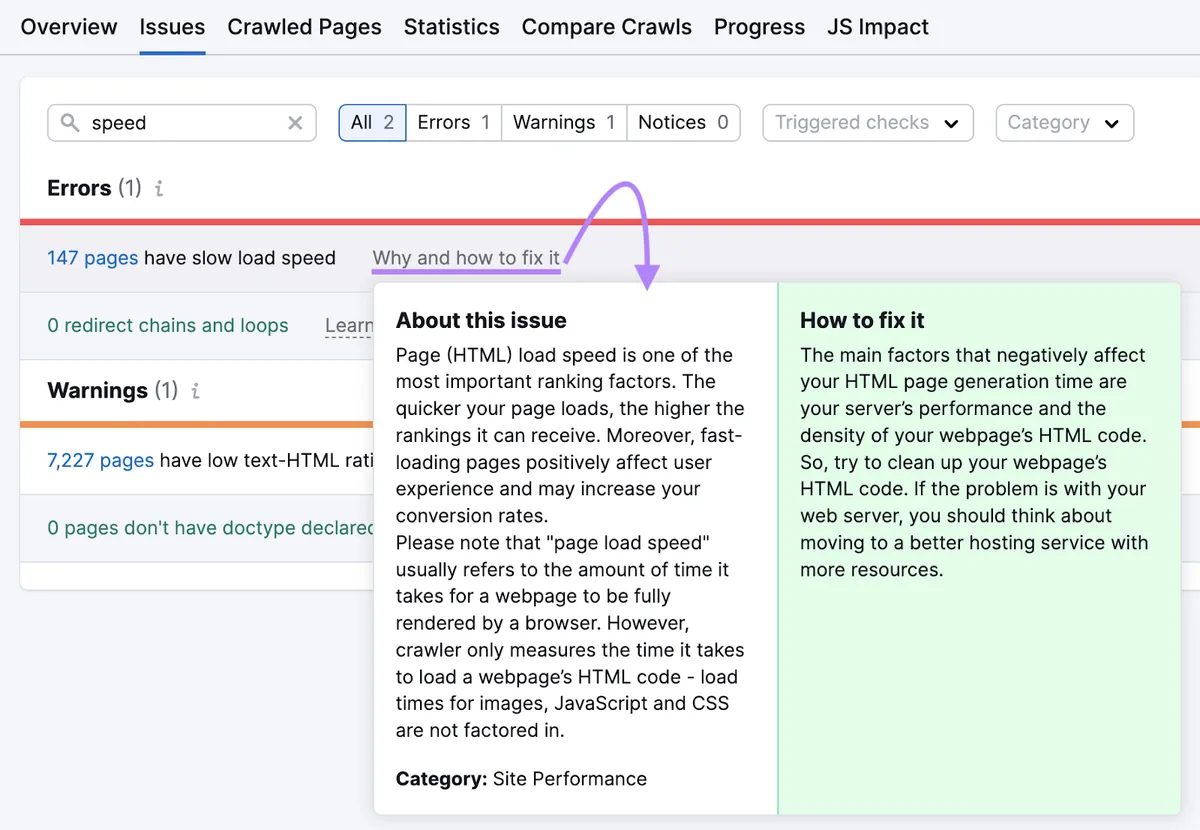
运行一次免费的 SEO 检查,快速了解页面的速度快照。要找出整个网站上加载缓慢的页面,使用 Semrush 网站审计工具。
进入“问题”标签页,搜索“speed”。
若有受影响的页面,工具会显示相关错误,并提供提升速度的建议。
走在可抓取性问题的前面
可抓取性问题并非一次性就能解决。
即使当下解决了它们,将来也可能再次出现,尤其当网站很大且频繁变动时。定期监控网站的可抓取性至关重要。
使用免费的网站审计快速检查首页的可抓取性。或者使用 Semrush 网站审计工具,安排每周对整站自动审计。
进入网站的审计设置,开启每周审计。
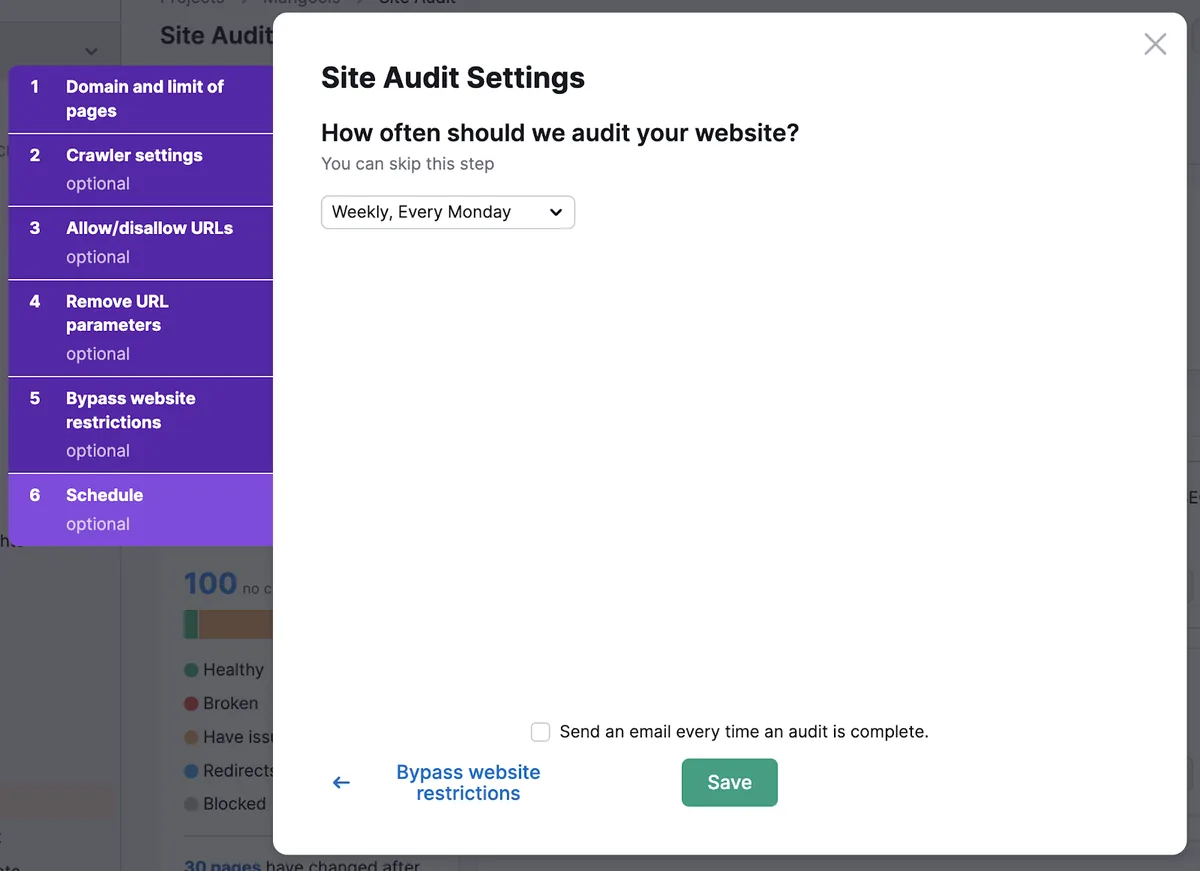
这样就能确保任何可抓取性问题都被及时识别出来。