Google PageRank 的演变
PageRank 由 Google 联合创始人谢尔盖·布林(Sergey Brin)和拉里·佩奇(Larry Page)于 1997 年在斯坦福大学期间创立,名称既指拉里·佩奇,也指“网页”(webpage)一词。它在许多方面类似于期刊的“影响因子”,被引用得越多就越重要。
PageRank(PR)是 Google 的一种算法,通过评估指向某个页面的链接数量和质量,在搜索结果中对网页进行排名。其原理是:获得更多高质量链接的页面被认为更重要,因而排名更高。
PageRank 由 Google 联合创始人谢尔盖·布林(Sergey Brin)和拉里·佩奇(Larry Page)于 1997 年创立,当时他们还在斯坦福大学;这个名字既指拉里·佩奇(Larry Page),也指“网页”(webpage)一词。
在许多方面,它类似于期刊的一种指标——“影响因子”(impact factor):被引用得越多,就越重要。不同之处在于,PageRank 认为某些“投票”比其他投票更重要。
通过把链接与内容结合起来对页面进行排名,Google 的搜索结果优于竞争对手。链接由此成为网络世界的“货币”。
想进一步了解 PageRank?下面深入探讨。
Google 仍在使用 PageRank
就现代 SEO 而言,PageRank 属于支撑经验、专业、权威、可信(Experience Expertise Authoritativeness Trustworthiness,E-E-A-T)的算法。
Google 的算法会识别与网页可信度和权威性相关的信号。其中最为人熟知的信号就是 PageRank,它利用网络上的链接来理解权威性。来源:How Google Fights Disinformation
Google 的代言人如 Gary Illyes 也曾向我们证实,Google 仍在使用 PageRank,并且链接会被用于 E-A-T(现为 E-E-A-T)。
我曾开展一项衡量链接影响的研究,用拒绝链接工具(disavow tool)有效移除链接后,流量下滑明显。链接对排名依然重要。
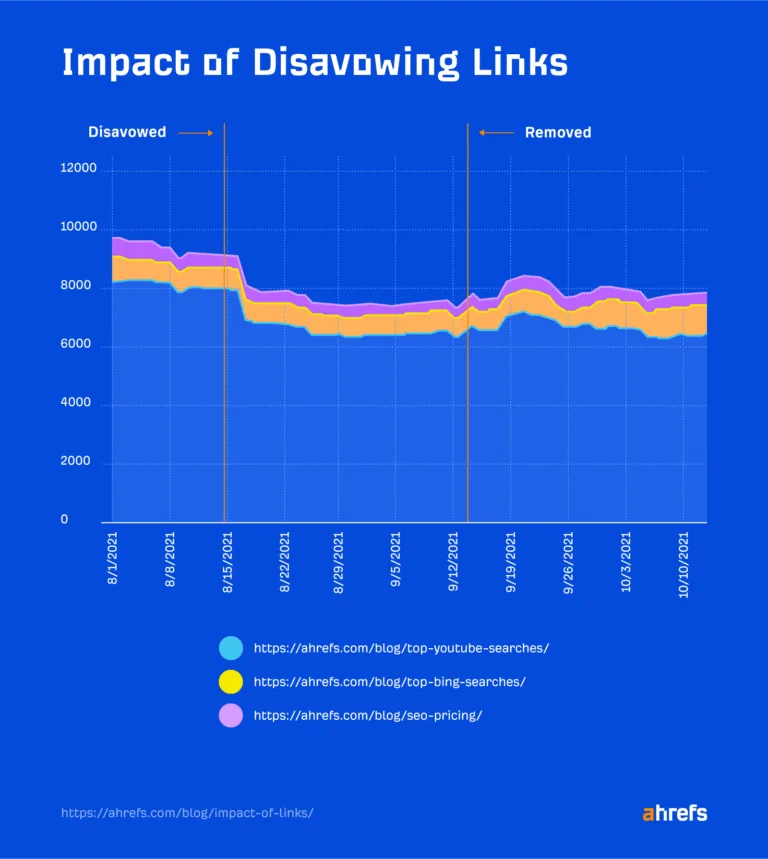
在抓取预算方面,PageRank 也被证实是一个影响因素。Google 希望更频繁地抓取重要页面,这合乎情理。PageRank 同样是一种规范化信号。PageRank 较高的页面更有可能被选为被索引并展示给用户的规范版本。
有趣的数学:为什么 PageRank 公式是错的
一个出人意料的事实:最初那篇 PageRank 论文中公布的公式是错的。原因如下。
在最初的论文中,PageRank 被描述为一种概率分布——也就是你身处网络上任意给定页面的可能性。这意味着,如果你把网络上每个页面的 PageRank 相加,总和应当等于 1。
以下是 1997 年发表的那篇原始论文中完整的 PageRank 公式:
PR(A) = (1-d) + d (PR(T1)/C(T1) + … + PR(Tn)/C(Tn))
稍微简化一下,并假设阻尼系数(d)为 0.85(正如 Google 在论文中提到的——稍后我会解释阻尼系数是什么),公式就是:
某个页面的 PageRank = 0.15 + 0.85(每个链接页面的 PageRank 被其出站链接分摊后的一部分)
论文中他们说,所有页面 PageRank 的总和应当等于 1。但如果使用论文中的公式,这是不可能的。每个页面的 PageRank 最低会是 0.15(1-d)。只要有少数几个页面,总和就会大于 1。概率不可能超过 100%。一定是哪里出了问题!
要让公式如描述般成立,实际上应当把那个 (1-d) 除以互联网上的页面数量。公式应改为:
某个页面的 PageRank = (0.15 / 互联网上的页面数量)+ 0.85(每个链接页面的 PageRank 被其出站链接分摊后的一部分)
这仍然很复杂,所以让我用一些图示来解释。
1. 页面会根据指向它的链接获得一个初始 PageRank 分数。假设我有五个页面,且都没有链接。每个页面的 PageRank 为 (1/5),即 0.2。
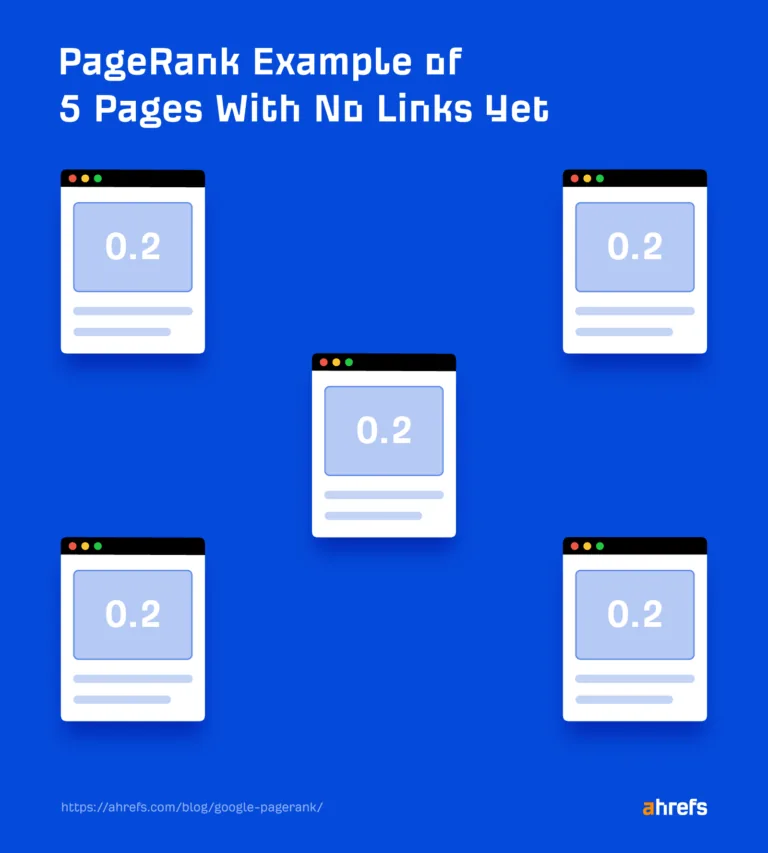
2. 这个分数随后通过页面上的链接分发给其他页面。如果我给上面五个页面添加一些链接,并计算每个页面的新 PageRank,就会得到这样的结果:
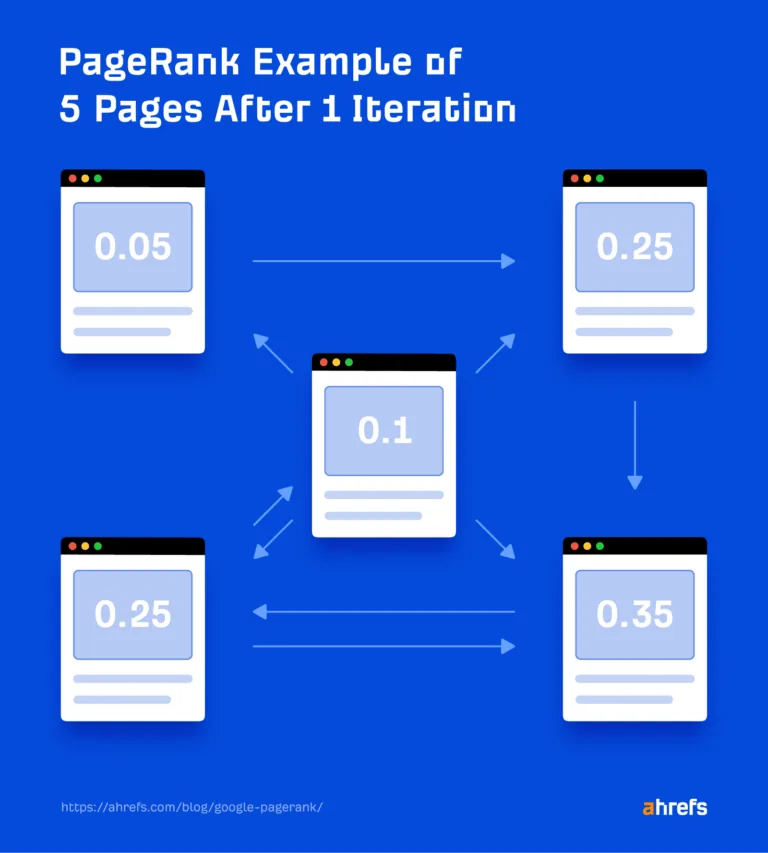
你会注意到,分数更偏向于那些指向它的链接更多的页面。
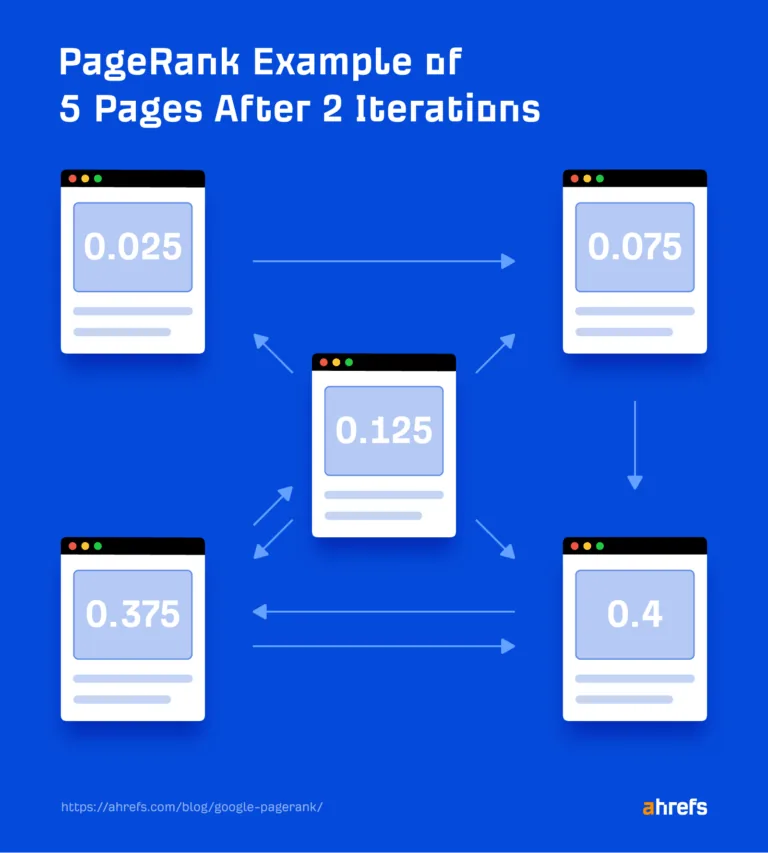
3. 随着 Google 抓取网络,这个计算会不断重复。如果我再次计算 PageRank(称为一次迭代),你会看到分数发生了变化。页面相同、链接相同,但每个页面的基础 PageRank 变了,因此得出的 PageRank 也不同。
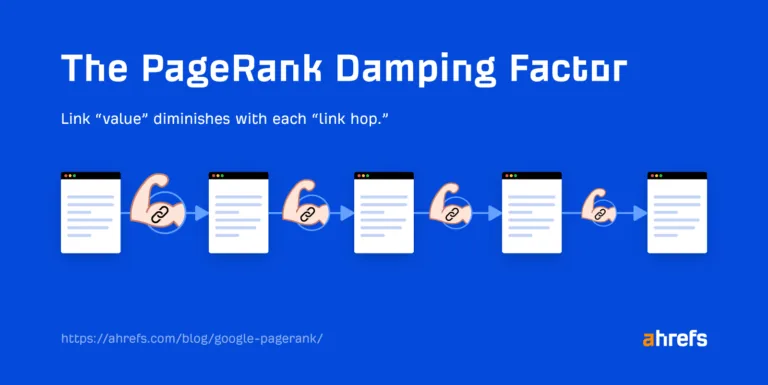
PageRank 公式还有一个所谓的“阻尼系数”,即公式中的“d”,它模拟的是随机用户在浏览网络时继续点击链接的概率。
这样理解:你在访问的第一个页面上点击链接的概率很高。但你在下一个页面上再点击链接的可能性会略低,以此类推。
如果一个高权重页面直接链接到另一个页面,它会传递很多价值。如果这个链接相隔四次点击,由于阻尼系数的作用,从那个高权重页面传递的价值就会少很多。
PageRank 的历史
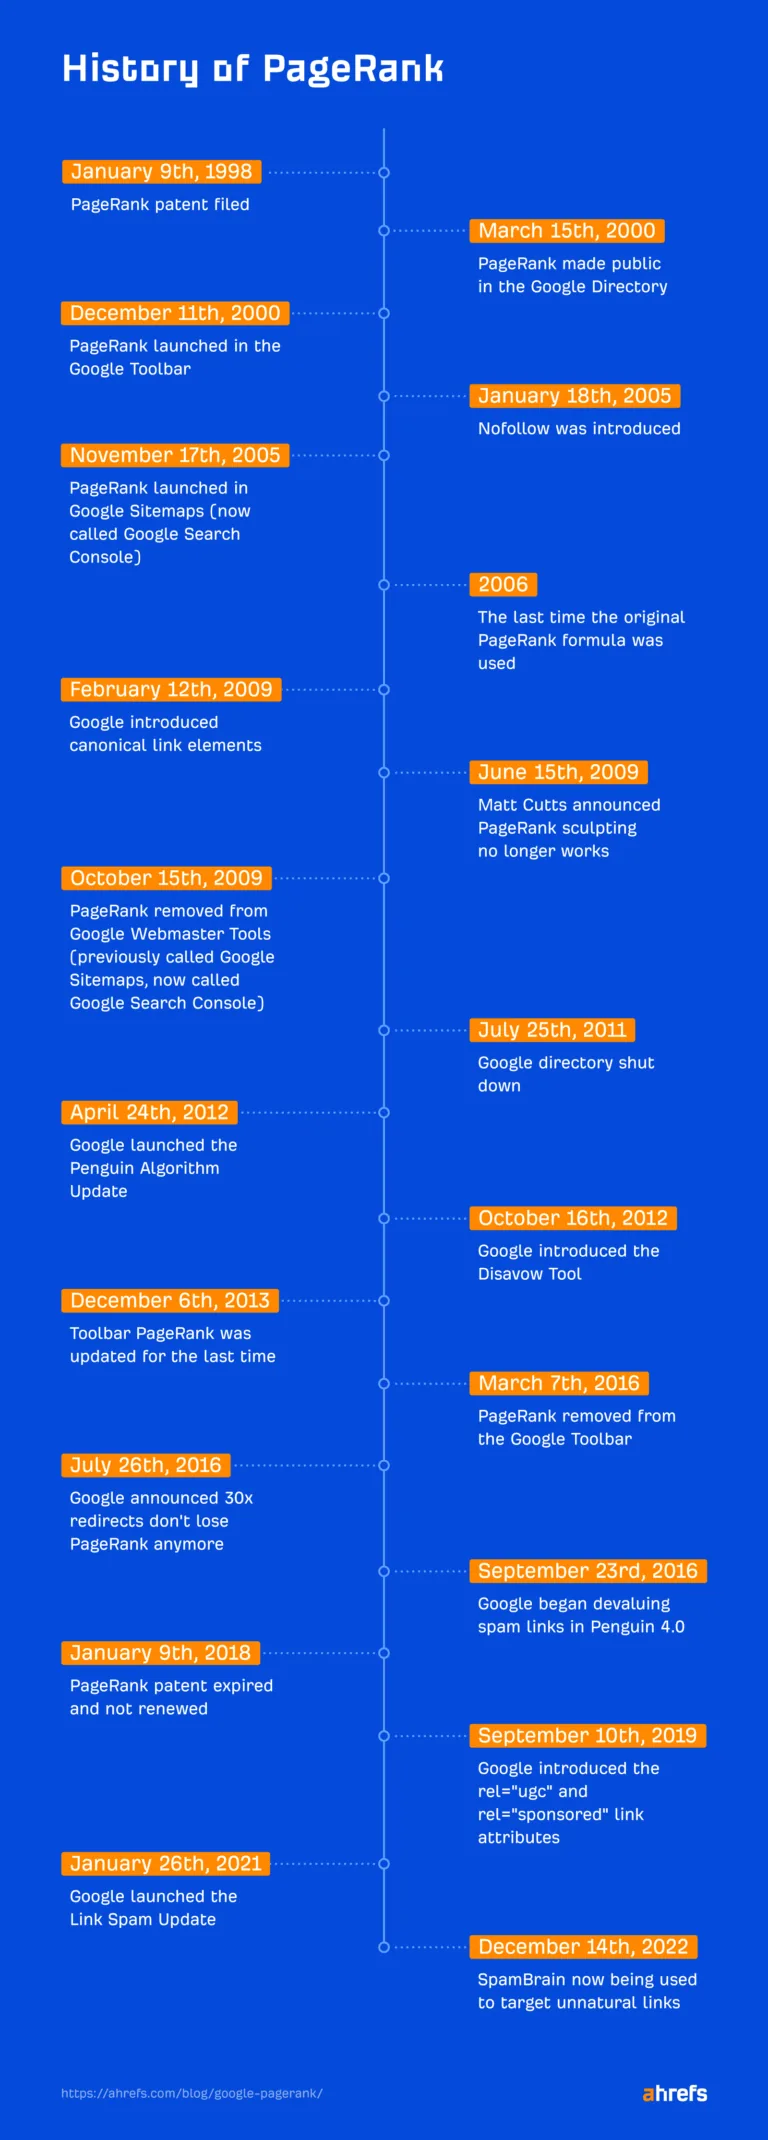
第一项 PageRank 专利于 1998 年 1 月 9 日提交,标题为“链接数据库中节点的排名方法”。该专利于 2018 年 1 月 9 日到期,且未续期。
Google 首次公开 PageRank 是在 2000 年 3 月 15 日 Google 目录(Google Directory)上线时。它相当于开放目录项目(Open Directory Project)的一个版本,但按 PageRank 排序。该目录于 2011 年 7 月 25 日关闭。
2000 年 12 月 11 日,Google 在 Google 工具栏中推出了 PageRank,这也是最让 SEO 们着迷的版本。
这就是 PageRank 被纳入 Google 工具栏时的样子。
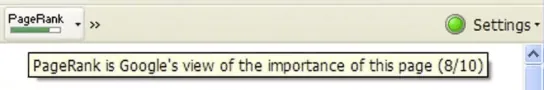
工具栏中的 PageRank 最后更新于 2013 年 12 月 6 日,并最终于 2016 年 3 月 7 日被移除。
工具栏中显示的 PageRank 略有不同。它用简单的 0–10 数字体系来表示 PageRank。但 PageRank 本身是一个对数刻度,每提升一个更高的数值都会变得越来越难。
PageRank 甚至在 2005 年 11 月 17 日进入了 Google Sitemaps(现称 Google Search Console)。它被以高、中、低或 N/A 的类别显示。该功能于 2009 年 10 月 15 日被移除。
链接垃圾(Link spam)
多年来,SEO 们为了追求更多 PageRank 和更好的排名,用了各种不同的手段来滥用系统。Google 有一份完整的链接作弊手法清单,其中包括:
- 买卖链接——用金钱、商品、产品或服务交换链接。
- 过度的链接交换。
- 使用软件自动创建链接。
- 将链接作为服务条款、合同或其他协议的一部分来强制要求。
- 未使用 nofollow 或 sponsored 属性的文字广告。
- 含传递排名权重链接的软文广告或原生广告。
- 带有优化锚文本链接的文章、客座博文或博客。
- 低质量的目录或社交书签链接。
- 嵌入到放置在他人网站上的小部件中的、堆砌关键词的、隐藏的或低质量的链接。
- 在页脚或模板中广泛分发的链接。例如,把指向你网站的链接硬编码进你出售或免费赠送的 WordPress 主题中。
- 在帖子或签名中包含优化链接的论坛评论。
用于打击链接垃圾的系统多年来不断演进。我们来看一些重要的更新。
Nofollow
2005 年 1 月 18 日,Google 宣布已与其他主流搜索引擎合作,引入 rel=“nofollow” 属性。它鼓励用户在博客评论、TrackBack 和来源列表中加上 nofollow 属性,以帮助打击垃圾信息。
以下是 Google 关于引入 nofollow 的官方声明节选:
如果你是博主(或博客读者),你一定对那些试图通过提交带链接的博客评论(如“来逛逛我的折扣药店网站吧”)来提升自己网站搜索引擎排名的人深有体会。这被称为评论垃圾(comment spam),我们同样不喜欢它,并且一直在测试一款可以阻止它的新标签。从现在起,当 Google 在超链接上看到该属性(rel=“nofollow”)时,这些链接在我们对网站进行搜索结果排名时将不再获得任何权重。
几乎所有现代系统都会对博客评论链接使用 nofollow 属性。
SEO 们甚至开始滥用 nofollow——我们当然会这么做。nofollow 曾被用于“PageRank 塑造”(PageRank sculpting),即人们对页面上的部分链接加上 nofollow,以让其他链接更强。Google 最终改变了这套机制,以阻止这种滥用。
2009 年,Google 的 Matt Cutts 证实这种做法不再有效,即使存在 nofollow 属性,PageRank 仍会在链接之间分配(但只通过被跟随(followed)的链接传递)。
2019 年 9 月 10 日,Google 又新增了几个链接属性,它们是 nofollow 属性更具体的版本。其中包括用于标识用户生成内容的 rel="ugc" 和用于标识付费或联盟链接的 rel="sponsored"。
针对链接垃圾的算法
随着 SEO 们找到新的操纵链接方式,Google 也在研发新算法来识别这些垃圾。
2012 年 4 月 24 日最初版本的 Penguin 算法上线时,它伤害了大量网站和站长。那年晚些时候,Google 于 2012 年 10 月 16 日推出拒绝链接工具(disavow tool),让站长有办法恢复。当 Penguin 4.0 于 2016 年 9 月 23 日上线时,它为 Google 处理链接垃圾的方式带来了可喜的变化。它不再惩罚网站,而是开始降低垃圾链接的价值。这也意味着大多数网站不再需要使用拒绝链接工具。
Google 于 2021 年 7 月 26 日推出首个链接垃圾更新(Link Spam Update)。这一机制近期有所演进,2022 年 12 月 14 日的一次链接垃圾更新宣布使用一套名为 SpamBrain 的 AI 检测系统,来消除非自然链接的价值。
PageRank 发生了哪些变化
据一位前 Google 员工称,最初版本的 PageRank 自 2006 年起就不再使用了。他说它被另一种资源占用更少的算法取代了。
他们在 2006 年用一种结果大致相似但计算速度显著更快的算法取代了它。工具栏中报告的数字、以及 Google 声称的 PageRank,正是这个替代算法(它甚至有个类似的名字,所以 Google 的说法在技术上并不算错)。两种算法都是 O(N log N),但替代算法在 log N 因子上的常数要小得多,因为它不需要迭代到算法收敛。这一点很重要,因为网络从约 100 万到 1000 万页面增长到了 1500 亿以上。
还记得那些迭代、以及 PageRank 是如何随每次迭代不断变化的吗?看来 Google 简化了那套系统。
还有哪些变化?
有些链接比另一些更有价值
页面上的 PageRank 并非在所有链接之间平均分配,而是有些链接比另一些更有价值。专利中有人推测,Google 从“随机冲浪者模型”(用户可能前往任意链接)转向了“理性冲浪者模型”(有些链接比其他链接更可能被点击,因此权重更高)。
有些链接会被忽略
Google 建立了好几套机制来忽略某些链接的价值。我们已经提到过其中一些,包括:
- nofollow、UGC 和 sponsored 属性。
- Google 的 Penguin 算法。
- 拒绝链接工具(disavow tool)。
- 链接垃圾更新。
Google 也不会计算被 robots.txt 屏蔽的页面上的任何链接。它无法抓取这些页面,也就看不到其中的链接。这套机制很可能从一开始就存在。
有些链接会被合并
Google 有一套规范化(canonicalization)系统,帮助它确定页面的哪个版本应被索引,并把重复页面的信号合并到那个主版本上。
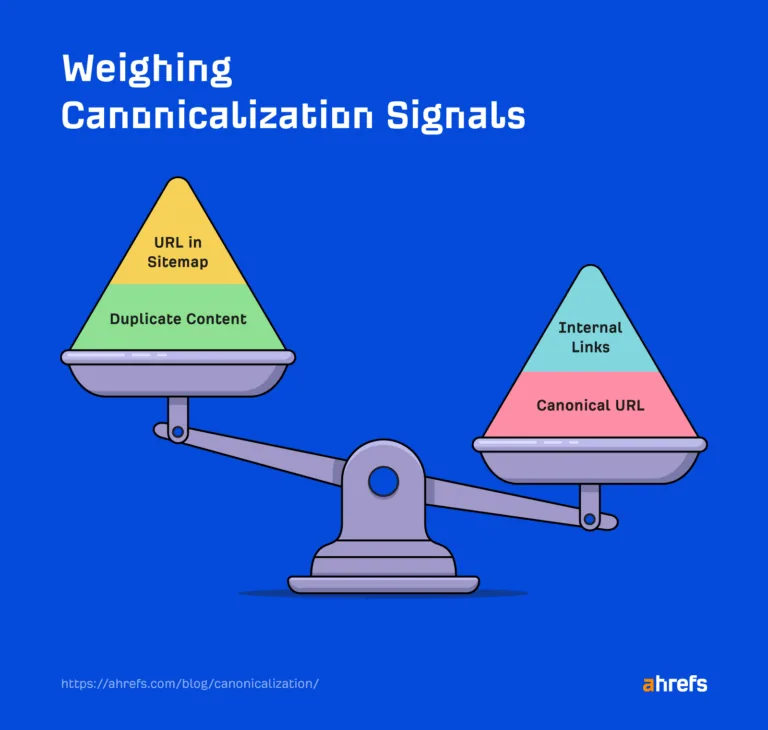
规范链接元素(canonical link elements)于 2009 年 2 月 12 日推出,允许用户指定他们偏好的版本。
重定向最初被说成会传递与链接相同的 PageRank 量。但不知何时,这套机制变了,目前不会损失任何 PageRank。
仍有一些未知
当页面被标记为 noindex 时,我们并不确切知道 Google 如何处理其中的链接。就连 Google 的员工也有相互矛盾的说法。
根据 John Mueller 的说法,被标记为 noindex 的页面最终会被当作 noindex, nofollow 处理。这意味着这些链接最终会不再传递任何价值。
根据 Gary 的说法,Googlebot 只要某个页面仍有链接指向它,就会发现并跟随其中的链接。
这两种说法未必矛盾。但如果按 Gary 的说法,Google 可能要过很久才会停止抓取和计算链接——也许永远不会。
你还能查看自己的 PageRank 吗?
目前没有办法查看 Google 的 PageRank。
URL 评分(UR)是 PageRank 的一个很好的替代指标,因为它与 PageRank 公式有很多共同点。它以 100 分制展示页面链接档案的强度。数字越大,链接档案越强。
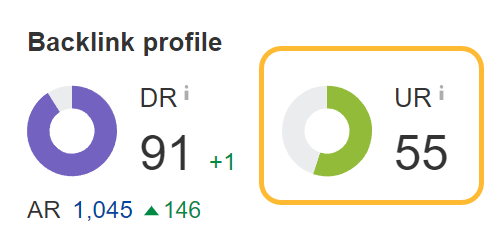
在计算时,PageRank 和 UR 都会把内链和外链考虑在内。业内使用的许多其他强度指标则完全忽略内链。我认为链接建设者应当更多关注 UR,而不是 DR 之类的指标——DR 只计算来自其他网站的链接。
不过,两者并不完全相同。UR 确实会忽略某些链接的价值,也不计算 nofollow 链接。我们并不确切知道 Google 忽略了哪些链接,也不知道用户可能拒绝了哪些链接,而这些都会影响 Google 的 PageRank 计算。我们也可能在如何处理某些规范化信号(如规范链接元素和重定向)上做出不同的判断。
所以我们的建议是:可以使用它,但要明白它可能并不完全等同于 Google 的系统。
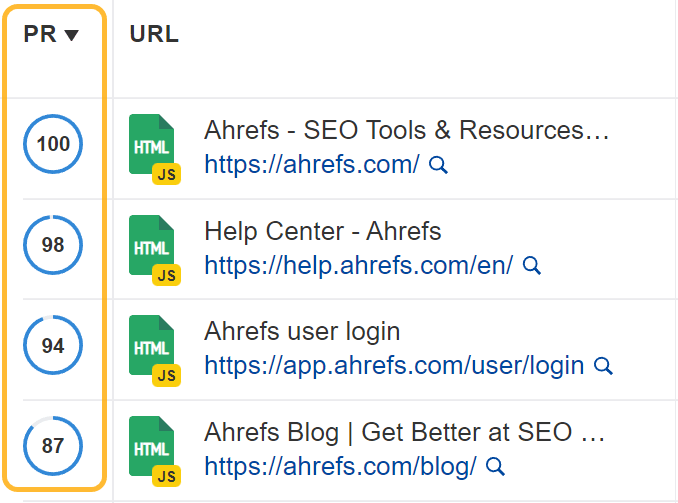
我们在 Site Audit 的页面浏览器(Page Explorer)中还有页面评分(Page Rating,PR)。它类似于一种站内 PageRank 计算,可以帮你根据内链结构看出网站中最强的页面。
如何提升你的 PageRank
由于 PageRank 基于链接,要提升 PageRank,你就需要更好的链接。我们来看看有哪些选择。
重定向失效页面
把网站上的旧页面重定向到相关的新页面,有助于重新夺回并合并 PageRank 等信号。网站会随时间变化,而人们似乎不太愿意做正确的重定向。这可能是最容易见效的一招,因为这些链接已经指向你,但当前却不给你计数。
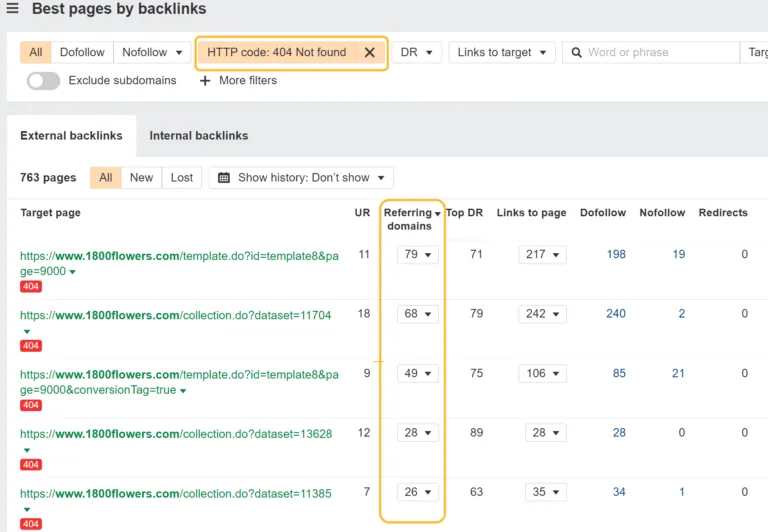
以下是发现这些机会的方法:
- 把你的域名粘贴到 Site Explorer 中(也可在 Ahrefs Webmaster Tools 中免费使用)
- 进入 按链接排序最佳页面(Best by links) 报告
- 添加一个“404 not found”HTTP 响应过滤器
我通常按“引用域(Referring domains)”对结果排序。
把那些页面重定向到你网站上现有的相关页面。如果你不确定它们该指向哪里,或没有时间,我有一个自动重定向脚本或许能帮忙。它会查看来自 archive.org 的旧内容,并与你网站上最接近的现有内容进行匹配。那通常就是你想要重定向到的页面。
内链
外链并不总是在你的掌控之中。人们可以随意链接到你网站上的任何页面,并可使用他们喜欢的任何锚文本。
内链则不同。你对它们拥有完全的掌控权。
在合理的地方建立内链。例如,你可能希望更多链接到对你更重要的页面。
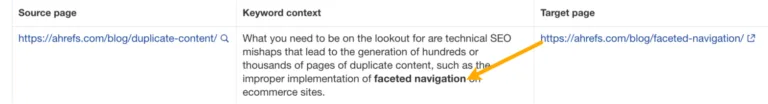
我们在 Site Audit 中有一款名为 内链机会(Internal Link Opportunities) 的工具,可以帮助你快速定位这些机会。
这款工具会查找你网站上已经获得排名的关键词的出现位置,然后把这些位置建议为可添加语境内链的机会。
例如,该工具在我们关于重复内容的指南中发现了一处“分面导航(faceted navigation)”的提及。由于 Site Audit 知道我们有一篇关于分面导航的页面,它建议我们添加一条指向该页面的内链。
外链
你也可以从其他网站获取更多指向自己网站的链接,以提升 PageRank。我们已经有很多关于链接建设的指南。我最喜欢的几篇是:
- SEO 链接建设:新手指南
- 如何进行竞争对手链接分析
- 9 个简单的链接建设策略
结语
尽管 PageRank 已经改变,但我们知道 Google 仍在用它。我们可能不了解所有细节或涉及的一切,但链接的影响依然显而易见。
而且,Google 似乎就是离不开链接和 PageRank。它曾尝试在算法中不使用链接,最终还是决定放弃这一想法。
所以我们并没有一个那样的公开版本,但我们在内部做过类似的实验,结果质量看起来要差得多。事实证明,反向链接尽管存在一些噪音、也确实有很多垃圾,但总体而言,在搜索结果质量方面仍然是一个很大、很大的优势。我们曾尝试关闭反向链接相关性,但至少目前来看,反向链接相关性在帮助我们确保呈现最好、最相关、主题最契合的一组搜索结果方面仍然非常有帮助。来源:YouTube(Google Search Central)
如果你有任何问题,在 Twitter 上给我留言。