Noindex 有什么用?概览与最佳实践
noindex 指令会告知搜索引擎不要索引某个网页。本文说明它的实施方法与注意事项。
什么是 Noindex?
Noindex 是一条规则,用于告知 Google 等搜索引擎不要索引某个网页——防止它被存入用于展示搜索结果的数据库中。
这意味着,当你对某个页面设置 noindex 后,搜索引擎不会保存该页面。当人们在网上查找信息时,它也不会出现在搜索结果中。
你可能会对那些不希望公众看到的页面设置 noindex。比如你网站上的私密内容或 PDF 页面。
本文介绍有效使用 noindex 规则所需了解的一切。
但先来聊聊为什么要关注 noindex 指令。
为什么 noindex 在 SEO 中很重要?
noindex 规则能帮你控制哪些页面被搜索引擎索引,进而影响网站的搜索引擎优化(SEO)表现。
例如,假设你有一些单薄页面(即那些价值很低的页面),由于种种原因你无法将其删除。
对这些低质量页面使用 noindex 规则,可以防止它们对网站 SEO 表现产生负面影响,并让搜索引擎的注意力转向其他更重要的页面。
话虽如此,你也不希望误将网站上的重要页面设为 noindex。如果发生了,它们将不会在搜索结果中排名,进而损害你的可见性和流量。
因此,请务必反复检查你的 noindex 实施情况。
何时使用 noindex 指令
有多种类型的内容很适合使用 noindex 规则。包括:
- 单薄页面:这些页面为用户提供的价值不大,因此可能损害你的 SEO 表现
- 处于预发布(staging)环境的页面:这些页面本就不供公众查看或使用,而是供你的团队更新和检查。
- 内部管理页面:这些页面是供你和团队使用的,所以你不希望它们出现在搜索结果中。
- 感谢页面:这些页面在用户完成操作(如下载内容或完成购买)后展示给他们。你不希望人们直接从搜索结果找到这些页面,因为那可能会让他们困惑。
- 可下载内容:这些页面是用户需要通过填写表单才能访问的资源。因此,你不希望潜在客户在无需提供联系方式的情况下就找到它们。
如何对页面设置 noindex
既然你已经知道哪些页面需要设置 noindex,接下来就该着手实施了。
实施 noindex 规则有两种方式:
- 作为 HTTP 响应头中的 X-Robots-Tag,适用于 PDF、图片和视频等非 HTML 文件
- 作为 HTML 中的 meta 标签,适用于大多数网页
通过 HTTP 头方式实施 noindex 规则技术性较强,需要服务器层面的改动。
基本上,你需要向某个服务器配置文件中添加一行代码(通常是 .htaccess)。
对 Apache 服务器(使用最广泛的 Web 服务器中的一个),如果你想对整个网站的所有 PDF 文件设置 noindex,代码大致如下。
鉴于其复杂性和潜在风险,我们建议寻求开发者的帮助,因为即便一个小小的语法错误也可能导致网站崩溃。
至于 meta 标签 noindex 方法,它相对简单,可以直接在页面的 HTML 中实施。
该标签放在 <head> 部分,形式如下:
如果你使用 WordPress 之类的内容管理系统(CMS),通常可以用 SEO 插件来实施 noindex meta 标签,而无需直接编辑代码。
使用 Yoast SEO 插件时,在编辑器中打开你想设置 noindex 的页面,向下滚动到 Yoast SEO 区域,点击“Advanced(高级)”标签页。
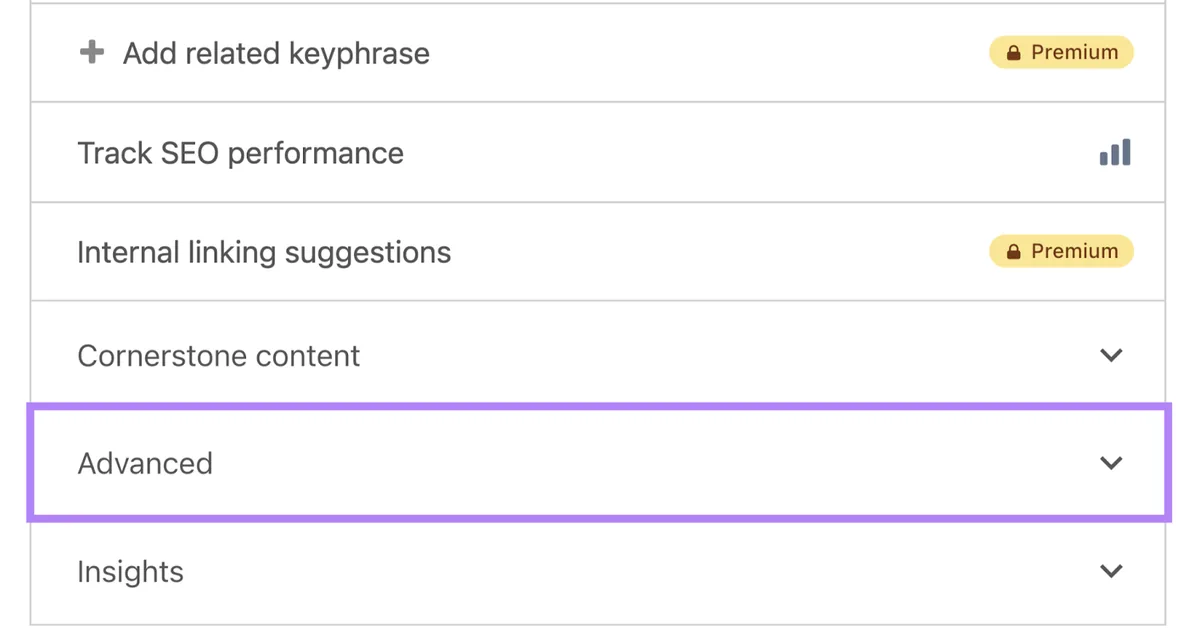
在“Allow search engines to show this content in search results?”(允许搜索引擎在搜索结果中显示此内容?)下,从下拉菜单中选择“No(否)”。
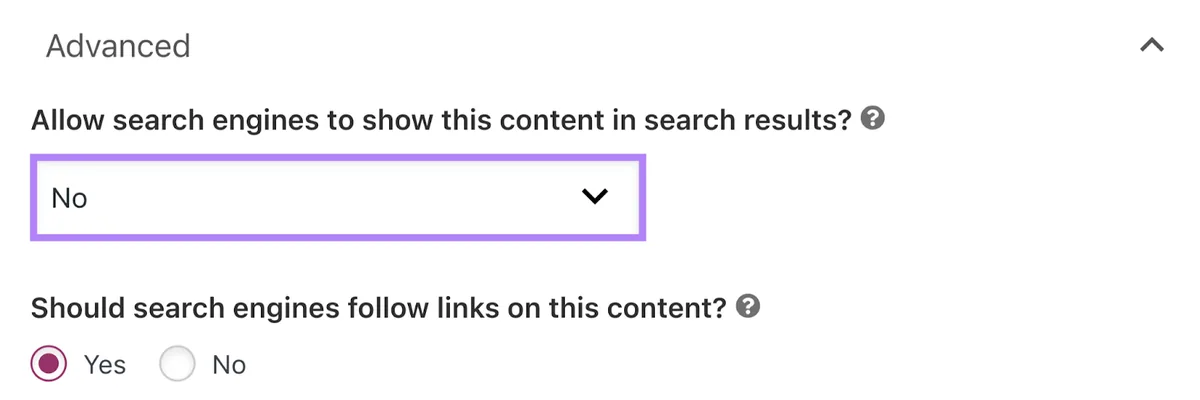
然后保存文章。
使用 Rank Math SEO 插件时,在编辑器中打开你想修改的页面,进入 Rank Math SEO 区域,点击“Advanced(高级)”标签页。
在“Robots Meta”下,取消勾选“Index”旁边的复选框,改为勾选“No Index”旁边的复选框。
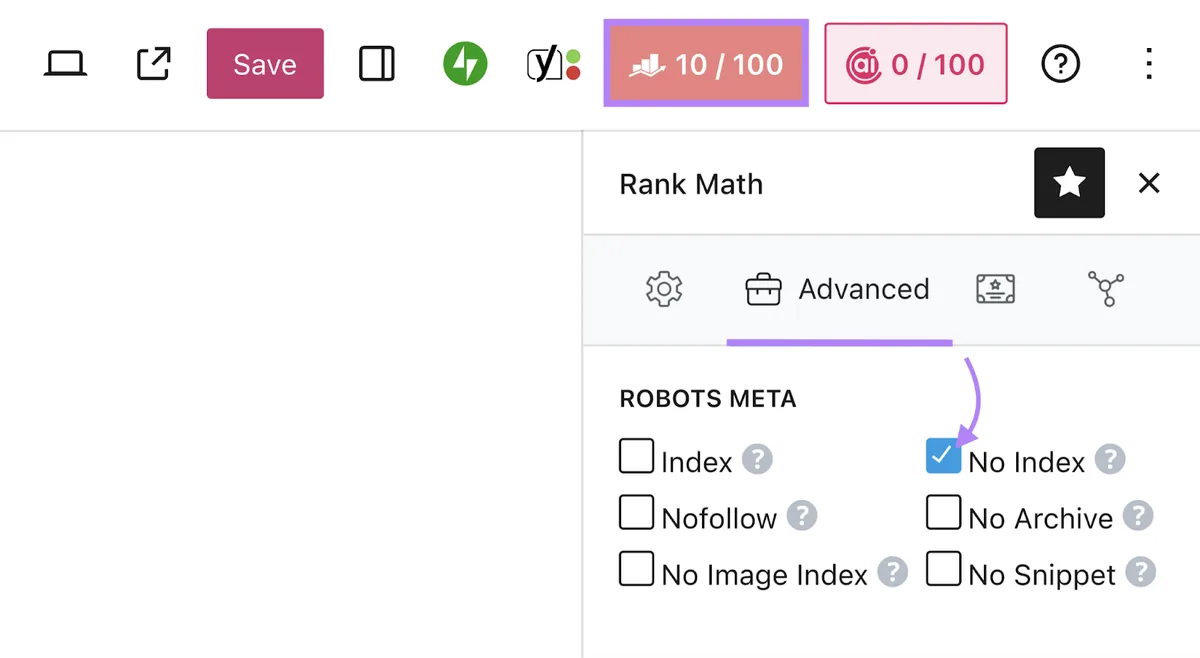
保存文章以更新你的设置。
使用 noindex 规则的最佳实践
下面是在处理 noindex 指令时需要牢记的一些最佳实践。
1. 不要对你希望出现在搜索结果中的页面设置 noindex
noindex 规则会阻止页面被索引和显示在搜索结果中。所以,如果你希望某个页面能通过搜索被找到,就不要对它设置 noindex。
运行我们免费的网站审计即可快速检查 noindex 状态。为确保你没有在整个网站中误将重要页面设为 noindex,请使用 Semrush Site Audit。
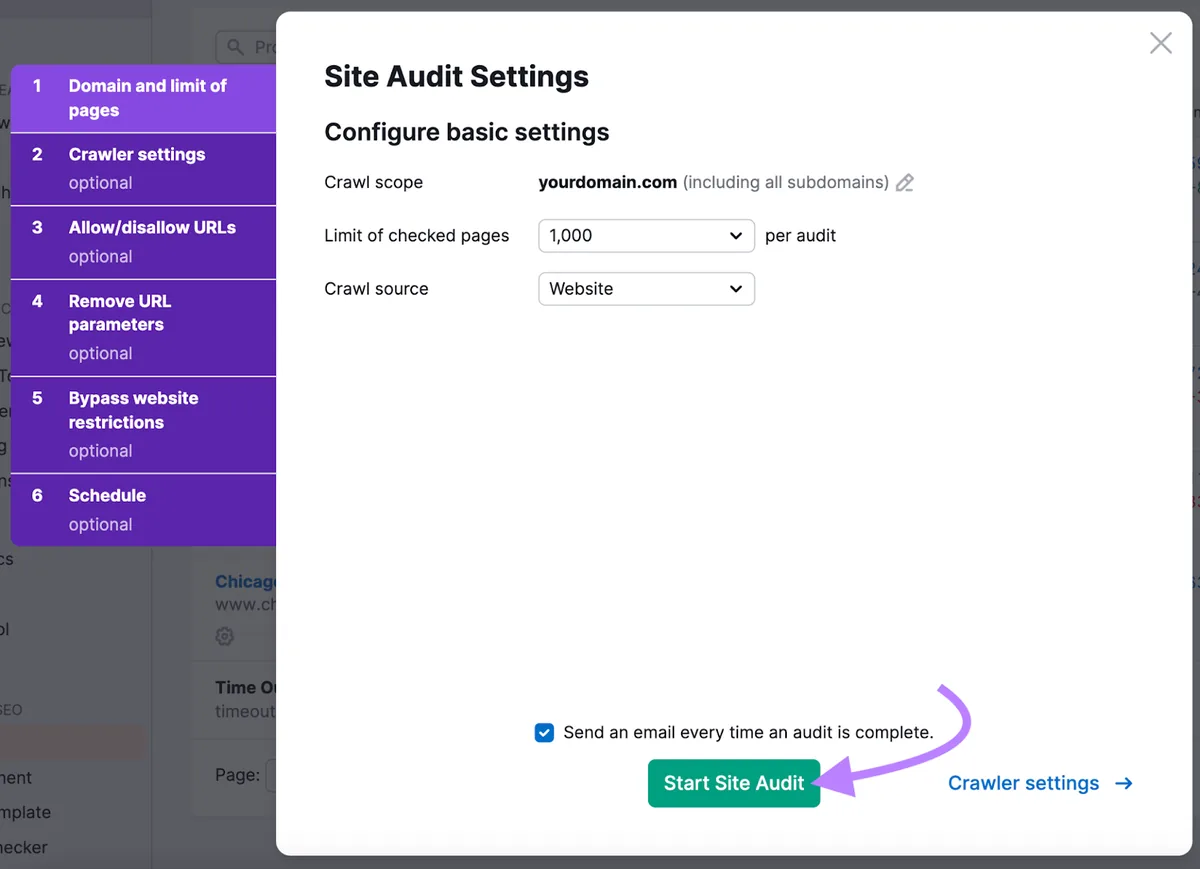
打开该工具,输入你的域名,点击“Start Audit(开始审计)”。
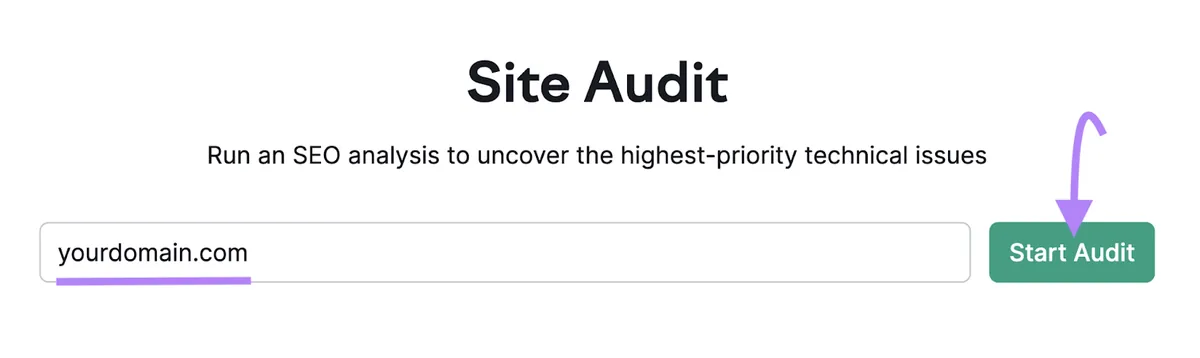
按照提示配置你的设置。
完成后,点击“Start Site Audit(开始网站审计)”。
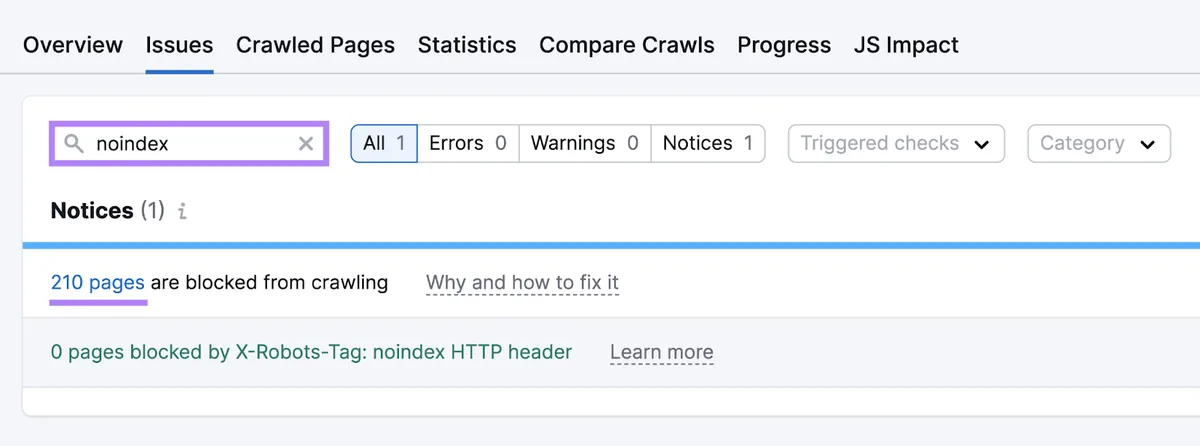
审计完成后,前往“Issues(问题)”标签页,并用搜索栏输入“noindex”。
你会看到被 noindex 标签或 robots.txt(该文件告知搜索引擎哪些页面应被或不应被抓取)屏蔽的页面数量。你还会看到是否有页面通过 X-Robots-Tag 方法被设置为 noindex。
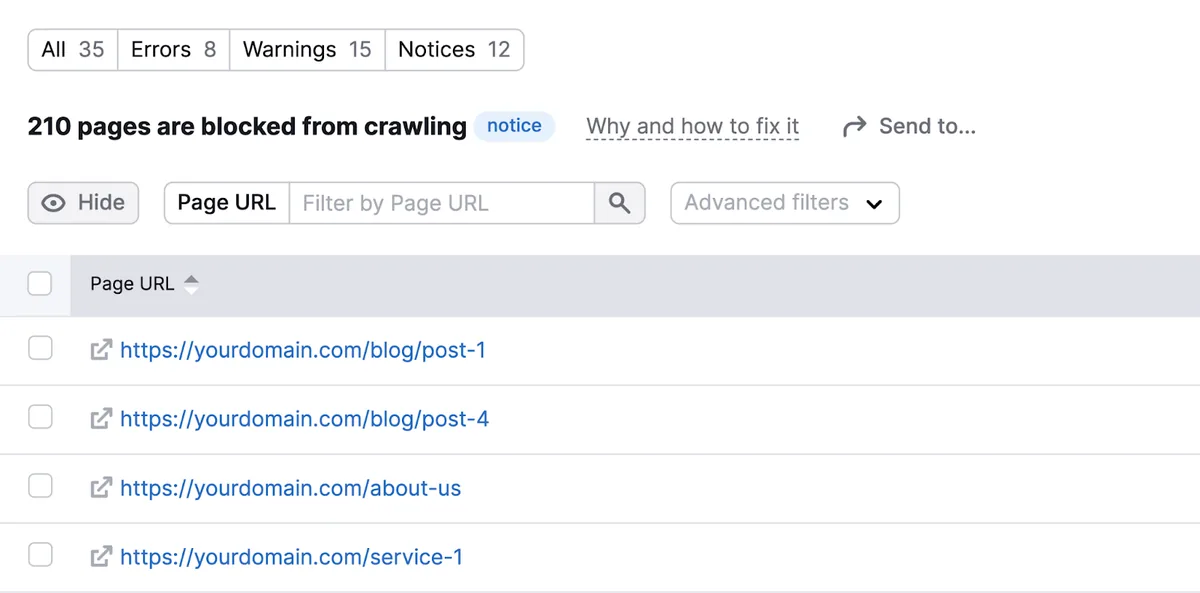
点击任一问题中的蓝色数字即可查看受影响的页面列表,并核实其中没有任何页面被误设为 noindex。
2. 不要试图用 robots.txt 文件来阻止索引
robots.txt 文件告知搜索引擎抓取哪些页面——而不是索引哪些页面。
即便你在 robots.txt 中屏蔽了某个页面,如果搜索引擎从其他页面发现了指向它的链接,它们仍可能对其建立索引。
此外,你实际上需要让搜索引擎能够抓取你的页面,它们才能看到 noindex 标签。
检查你的 robots.txt 文件,确保它没有屏蔽你希望设置 noindex 的页面。
你可以通过访问“[你的域名]/robots.txt”来做到这一点。
在你的 robots.txt 文件中查找“Disallow”指令。
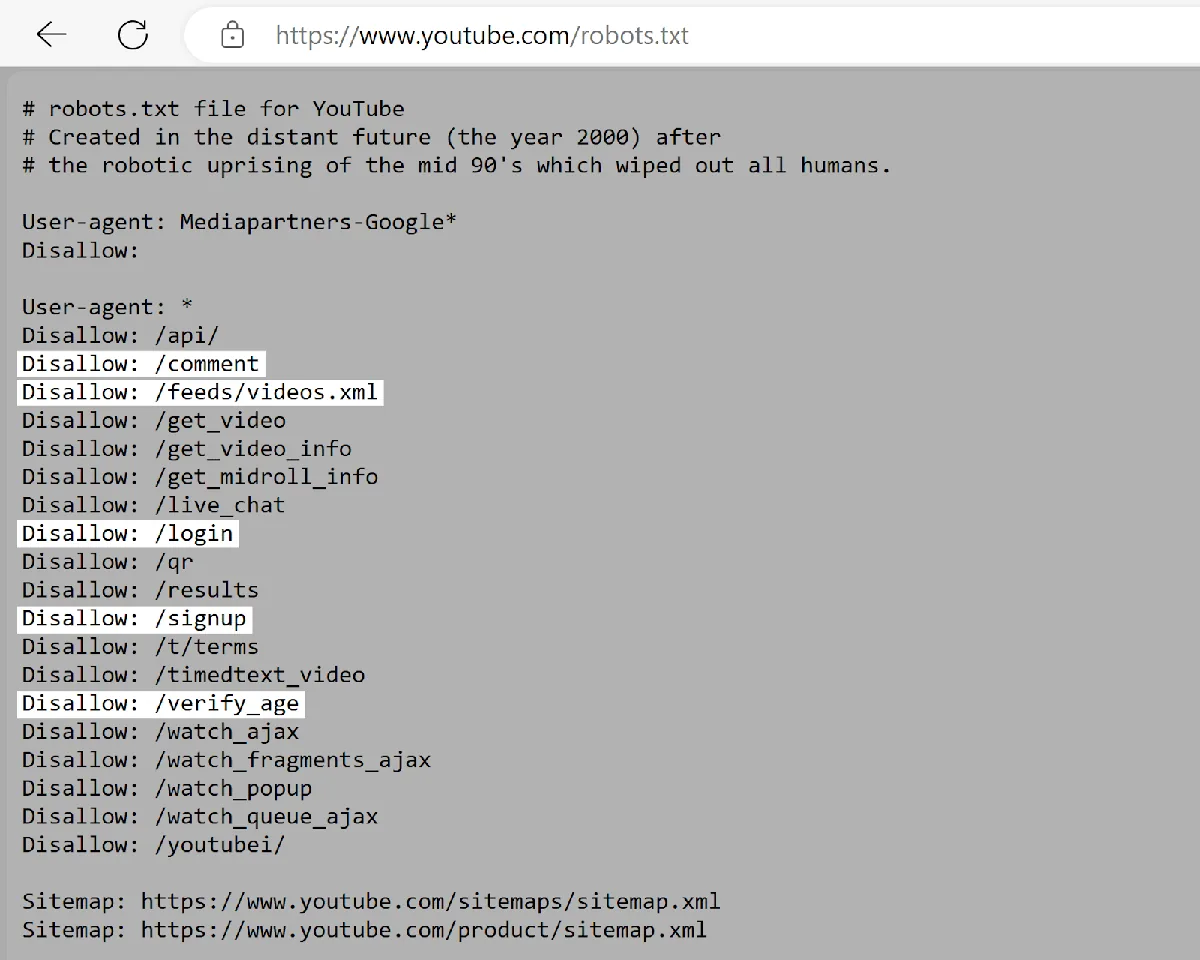
这些指令告知搜索引擎哪些页面或目录不应访问。所以,请确保你希望设置 noindex 的页面没有被列在这里。
3. 采取措施处理可能出现的 nofollow 问题
如果你屏蔽出搜索结果的网页,是指向其他某些页面的唯一链接中的一个,那么设置 noindex 可能会损害你的 SEO。
怎么回事?
搜索引擎只会在一段时间内跟踪 noindex 页面上的链接。最终它们会将这些链接视为 nofollow(即不应被抓取或传递排名权重)。
如果你网站上的其他页面内链很少,而其中一些链接又来自被设置 noindex 的内容,那么搜索引擎会发现这些其他页面变得更加困难。
因此,它们可能不会出现在搜索结果中——即使你希望它们出现。
使用 Site Audit 查找“# 个页面只有一个入站内链”的提示,并点击蓝色数字。
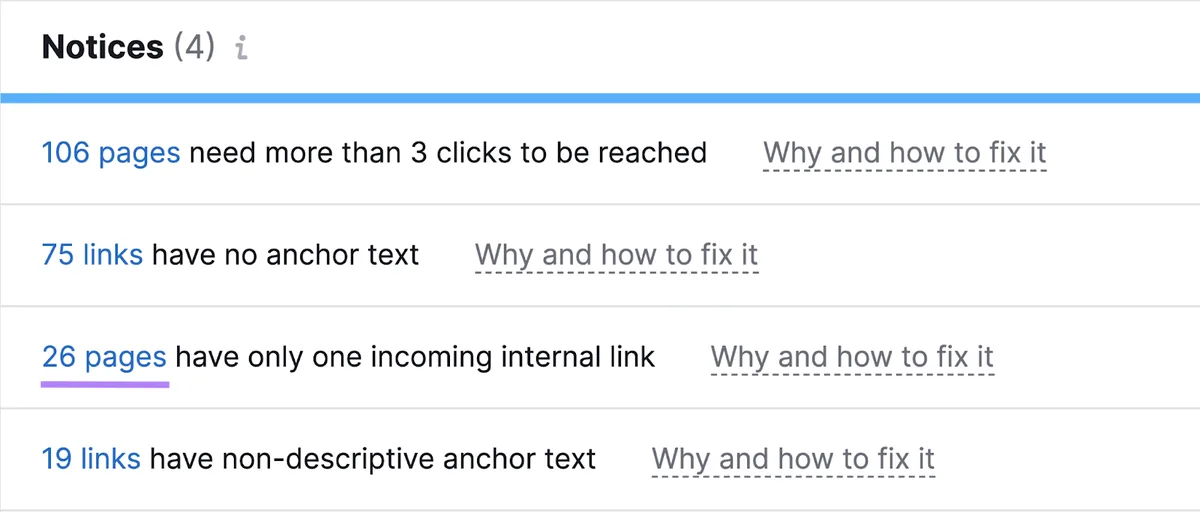
随后你会看到受影响的页面。
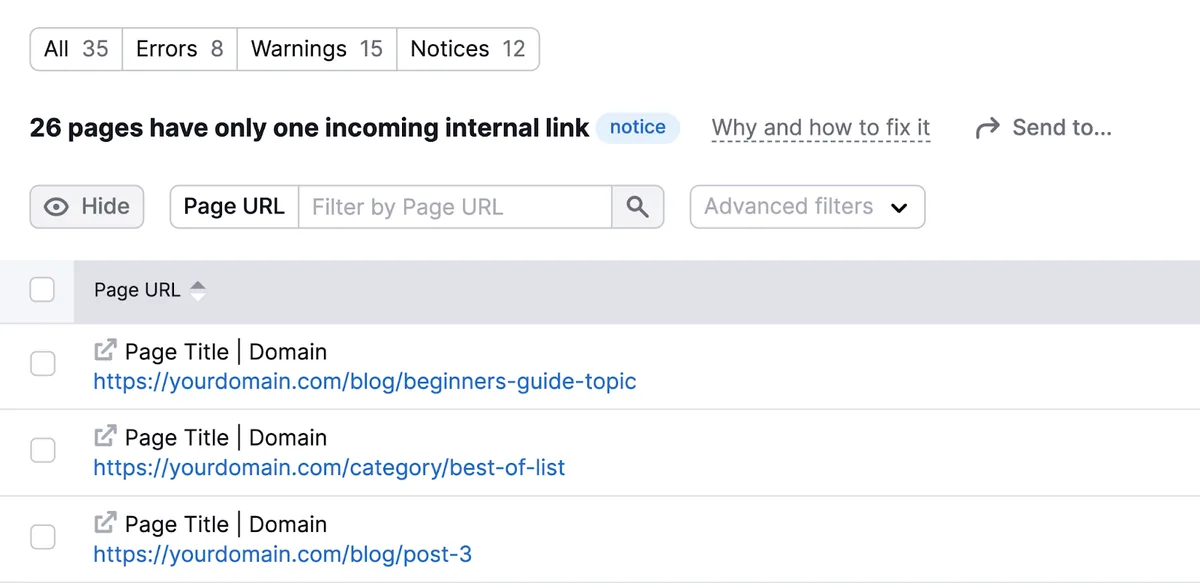
请努力在网站各处为这些页面加入更多链接。
即便这唯一的入站内链并非来自 noindex 页面,这样做也是个好主意。
4. 不要用 noindex 指令来处理重复内容
重复内容是指你有两个或多个内容完全相同或高度相似的页面。这会让搜索引擎难以决定在搜索结果中索引和排名哪个版本。
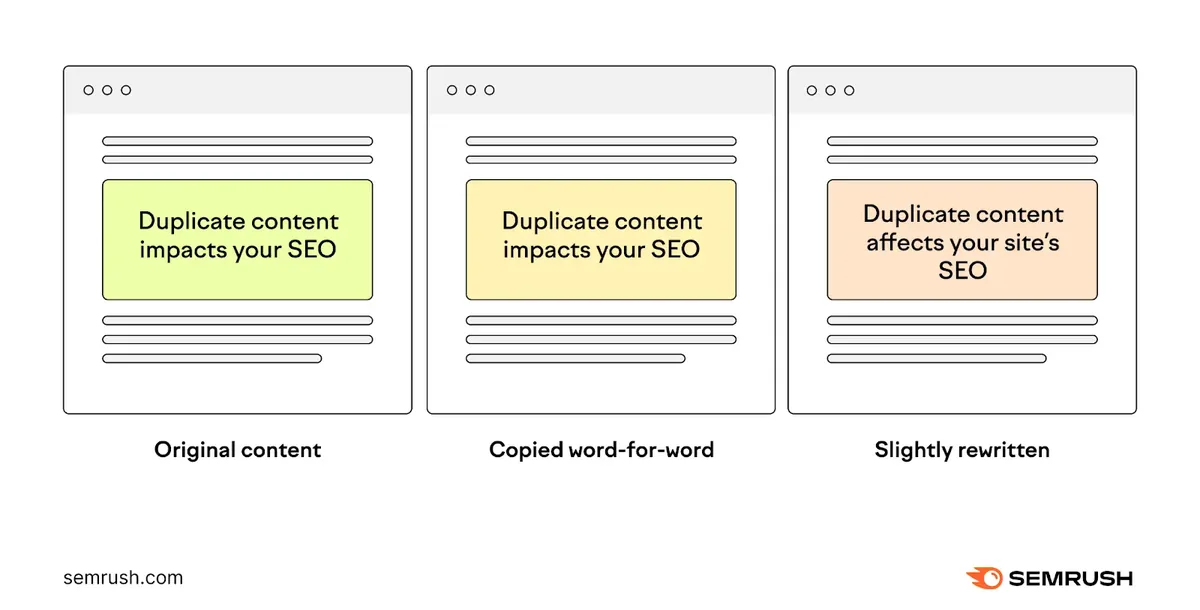
在重复页面上使用 noindex 标签看似是个不错的选择,但这并不是最佳方案。
取而代之,请考虑使用 规范标签。
它们告知搜索引擎哪个版本是页面的主版本、应当被索引。它们还能把所有版本的排名权重集中到主页面。
5. 如果 noindex 页面仍出现在搜索结果中,请请求重新抓取
如果你添加 noindex 标签后 Google 尚未重新抓取该页面,noindex 页面可能仍会出现在搜索结果中。但你可以通过手动请求重新抓取来加快这一过程。
为此,请使用 Google Search Console(GSC)。
登录 GSC,点击左侧菜单中的“URL inspection(网址检查)”。
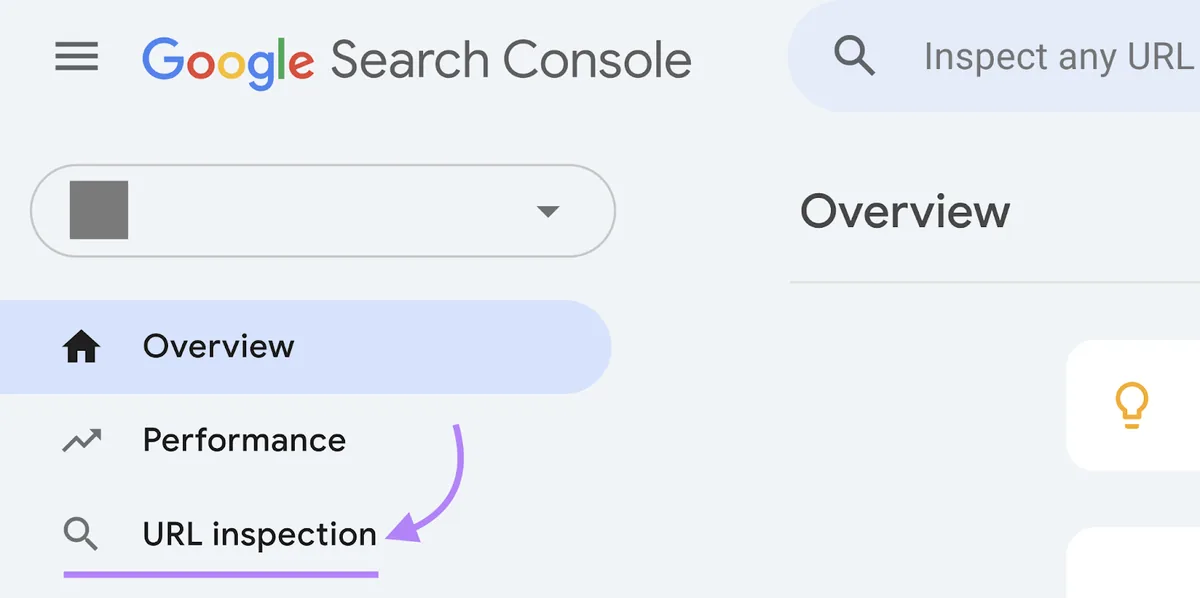
现在,粘贴你希望 Google 重新抓取的页面 URL,然后按回车。

然后点击“Request Indexing(请求编入索引)”。
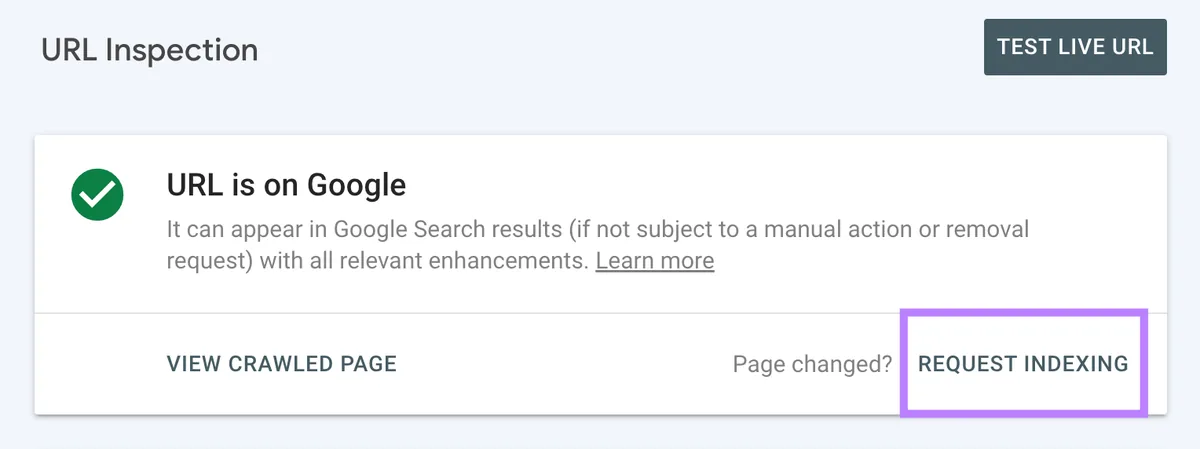
随后 Google 会重新抓取该页面。
6. 定期检查你的 noindex 页面
时不时检查你的 noindex 页面很重要。因为错误可能在你毫无察觉时发生,比如你团队中的某人误将某个页面设为了 noindex。
通过定期监控你的 noindex 页面,你能快速发现并修复这些错误,进而避免出现表现下滑。
使用 Site Audit 工具来跟踪你的 noindex 页面。
为了让事情更轻松,可以安排定期扫描。
在设置时前往“Schedule(计划)”标签页,选择按周监控网站,然后点击“Start Site Audit(开始网站审计)”。
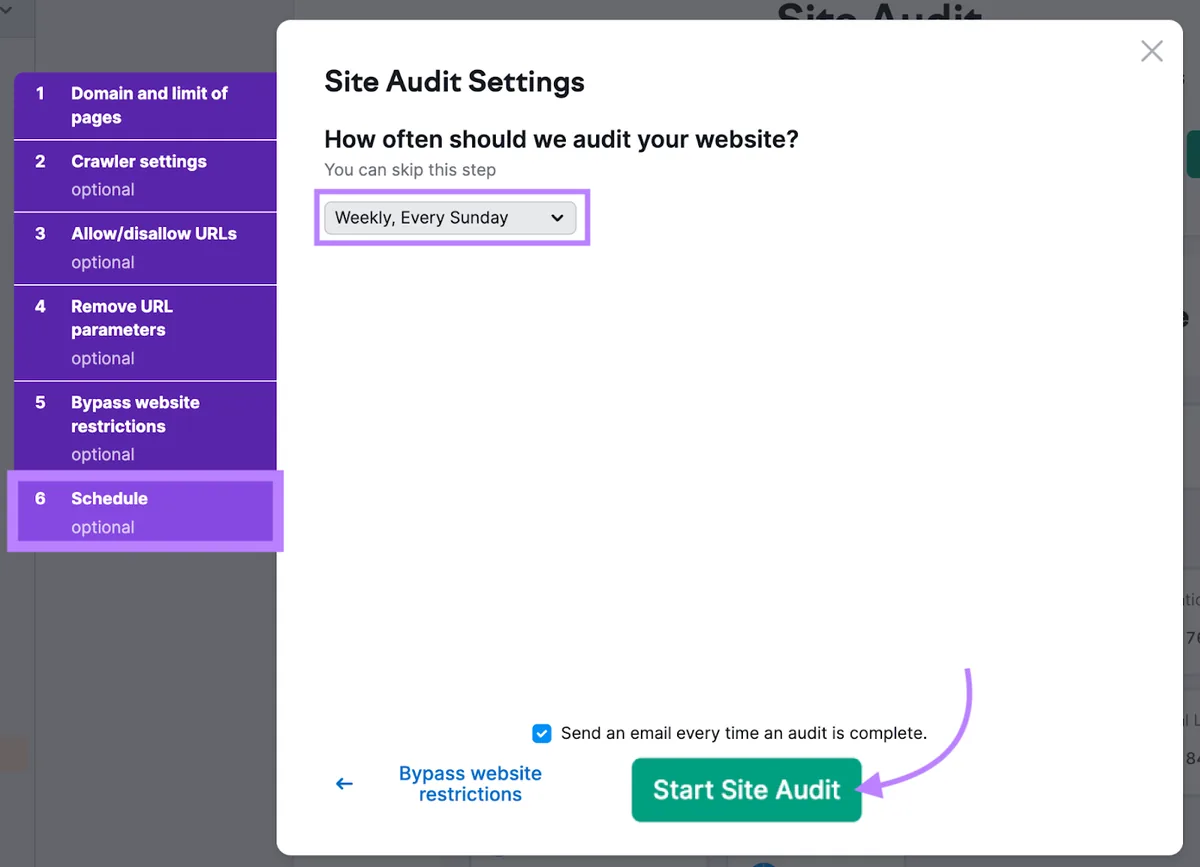
该审计将按周运行,让你能随时掌握未来可能出现的任何问题。