抓取我吧?网站爬虫是如何工作的
搜索引擎对允许进入搜索结果的网站质量越来越严苛。若不了解面向网络爬虫(和最终用户)做优化的基础知识,你的自然流量很可能要付出代价。
你或许听说过“网站抓取”这个词——甚至对它大概是干什么的有个模糊印象——但你知道它为什么重要,或者它与“网络爬取”有何区别吗?(没错,二者是有区别的!)
搜索引擎对允许进入搜索结果的网站质量越来越严苛。
若不了解面向网络爬虫(和最终用户)做优化的基础知识,你的自然流量很可能要付出代价。
一款好的网络爬虫工具能教你如何保护甚至提升网站的可见度。
以下是关于网络爬虫(web crawler)和站点爬虫(site crawler)你需要了解的内容。
什么是网络爬虫?
网络爬虫是一种软件程序或脚本,它会自动扫描互联网,分析并索引网页。
网络爬虫也被称为网络蜘蛛(web spider)或蜘蛛机器人(spiderbot),它评估页面内容,以决定在其索引中如何对其排定优先级。
Googlebot 是 Google 的网络爬虫,它一丝不苟地浏览网络,沿着链接从一页爬到另一页,收集数据并处理内容,以便纳入 Google 搜索引擎。
网络爬虫如何影响 SEO?
网络爬虫会分析你的页面并判断它的可索引性或可排名性,而这最终决定了你获取自然流量的能力。
如果想在搜索结果中被发现,那么让内容为抓取和索引做好准备就十分重要。
网络爬虫有哪些不同类型?
爬虫形态各异、大小不一。有像 Googlebot 和 Bingbot 这样的网络爬虫——它们为各大搜索引擎提供动力,全天候抓取数十亿页面,以保持搜索结果新鲜。
还有专注于特定领域的专用爬虫——比如审计单个网站以发现技术问题的站点爬虫、抓取研究论文的学术爬虫,以及——对于怕写代码的人(比如我!)——提供点击式界面来抓取所需数据的可视化网页抓取工具。
下面列出了网络爬虫的主要类型及其示例和实际应用。在本文中,我只聚焦于网络爬虫和站点爬虫。
网络爬虫实际上是如何工作的?
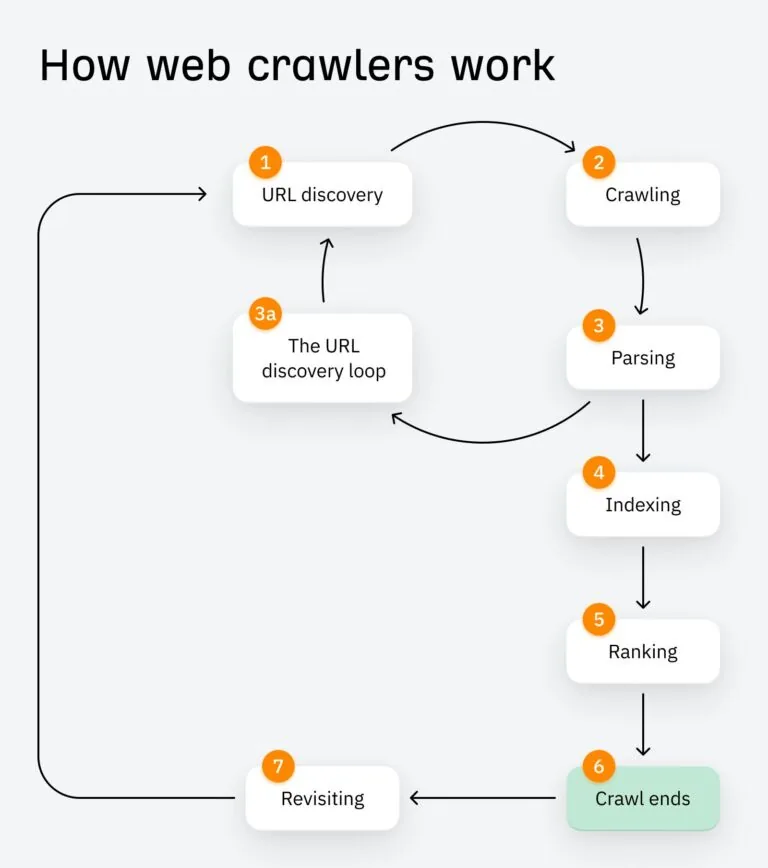
网络抓取大致有七个阶段:
1. URL 发现
当你发布页面时(例如发布到站点地图),网络爬虫会发现它,并将其用作“种子”URL。就像种子在发芽循环中的作用一样,这些起始 URL 让抓取及后续的抓取循环得以开始。
2. 抓取
URL 被发现之后,你的页面会被安排抓取,随后被抓取。元标签、图片、链接和结构化数据等内容会被下载到搜索引擎的服务器,等待解析和索引。
3. 解析
解析本质上就是分析。爬虫机器人提取它刚刚抓取到的数据,以确定如何索引和排名该页面。
3a. URL 发现循环
同样发生在解析阶段、但值得单独成节的是 URL 发现循环。此时新发现的链接(包括通过重定向发现的链接)会被加入一个供爬虫访问的 URL 队列。这些实际上就是新的“种子”URL,步骤 1 至 3 会作为“URL 发现循环”的一部分被重复执行。
4. 索引
在新 URL 被发现的同时,原始 URL 会被索引。索引是指搜索引擎存储从网页收集到的数据,以便按用户查询快速检索出相关结果。
5. 排名
已索引的页面会依据质量、与搜索查询的相关性以及满足某些其他排名因素的能力,在搜索引擎中获得排名。当用户执行搜索时,这些页面便会被呈现给他们。
6. 抓取结束
最终,整个抓取过程(包括 URL 重新发现循环)会基于已分配的时间、已抓取的页面数量、已跟随的链接深度等因素而结束。
7. 重新访问
爬虫会定期重新访问页面,以检查更新、新内容或结构变化。
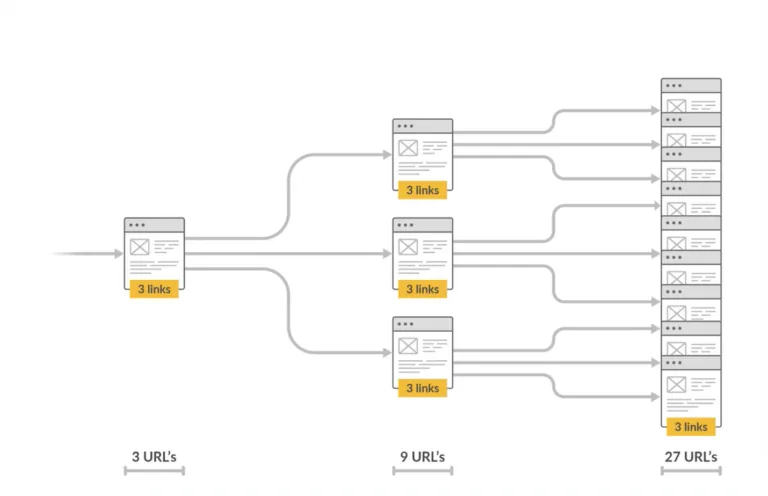
你大概能猜到,在这一过程中被发现和抓取的 URL 数量,仅仅经过几跳就会呈指数级增长。
一开始如何让搜索引擎抓取你的网站?
搜索引擎的网络爬虫是自主运行的,这意味着你无法随意触发它们抓取,也无法随意开关它们。
不过,你可以通过以下方式帮助爬虫:
XML 站点地图
XML 站点地图是一个列出网站所有重要页面的文件,可帮助搜索引擎准确地发现并索引你的内容。
Google 的 URL 检查工具
你可以通过 Google Search Console 中的URL 检查工具请 Google 考虑重新抓取你的站点内容。如果 Google 知道你的 URL 但尚未抓取或索引它,你可能会在 GSC 中收到一条提示。若有,请了解如何修复“已发现——目前未编入索引”。
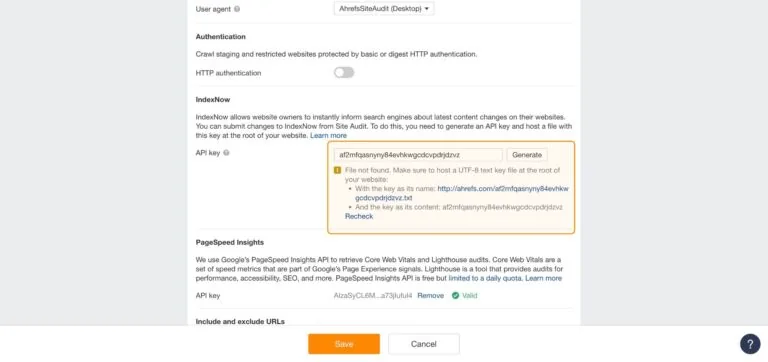
IndexNow
与其等待机器人重新抓取并索引你的内容,你可以使用 IndexNow,在你做以下操作时自动向 Bing、Yandex、Naver、Seznam.cz 和 Yep 等搜索引擎发送通知:
- 新增页面
- 更新现有内容
- 移除过时页面
- 实施重定向
你可以通过 Ahrefs Site Audit 设置自动的 IndexNow 提交。
如何让 Google 更频繁地抓取你更多的页面
搜索引擎的抓取决策是动态变化的,并且略带神秘色彩。
虽然我们不知道 Google 用于判断何时抓取内容或抓取频率的确切标准,但我们推断出了三个最重要的方面。
这基于 Google 在支持文档和代表访谈中留下的线索。
1. 优先考虑质量
Google PageRank 会评估指向某个页面的链接数量与质量,将它们视为重要性的“投票”。
获得高质量链接的页面被视为更重要,并在搜索结果中获得更高排名。
PageRank 是 Google 算法的基础组成部分。因此,你的链接和内容质量在很大程度上决定了网站被抓取和索引的方式,也就不足为奇了。
为了评判你网站的质量,Google 会考察以下因素:
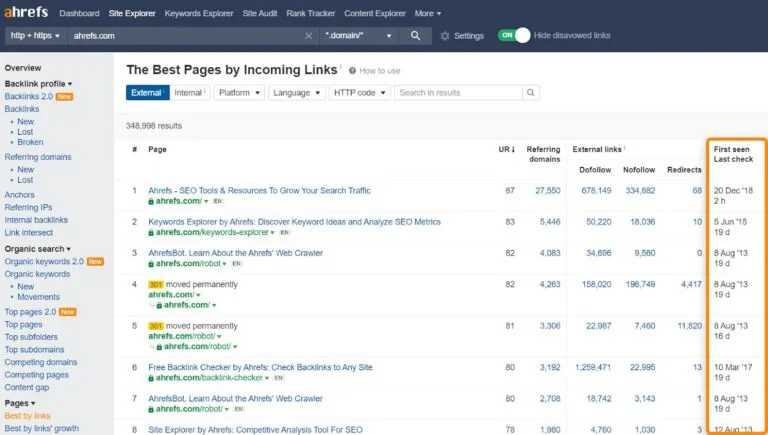
要评估网站上链接最多的页面,可以查看 Ahrefs 中的“按链接数排序”(Best by Links)报告。
留意“首次发现”(First seen)和“最近检查”(Last check)这两列,它们揭示了哪些页面被抓取得最频繁,以及是在何时被抓取的。
2. 保持内容新鲜
据 Google 高级搜索分析师 John Mueller 所说……
但如果你定期更新内容,就会看到爬虫更频繁地造访。
像 Google 这样的搜索引擎希望提供准确、最新的信息,以保持竞争力和相关性,因此更新内容就像用胡萝卜吊在棍子上引诱爬虫。
你可以通过查看Google Search Console 中的抓取统计信息,来了解 Google 处理你更新的速度有多快。
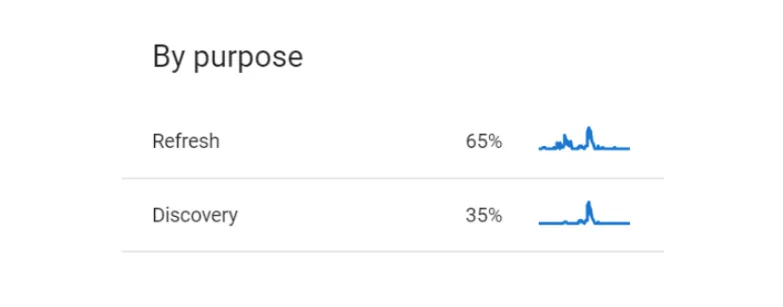
在那里,顺便看看按“用途”(By purpose)划分的抓取明细(即页面刷新与新发现页面的百分比构成)。这也有助于你弄清自己到底在多大程度上促使网络爬虫重新访问你的网站。
要找出网站上需要更新的具体页面,请前往 Ahrefs Site Explorer 中的“热门页面”(Top Pages)报告,然后:
- 将流量筛选条件设为“下降”(Declined)
- 将对比日期设为过去一到两年
- 查看“内容变化”(Content Changes)状态,并更新那些仅有轻微变化的页面
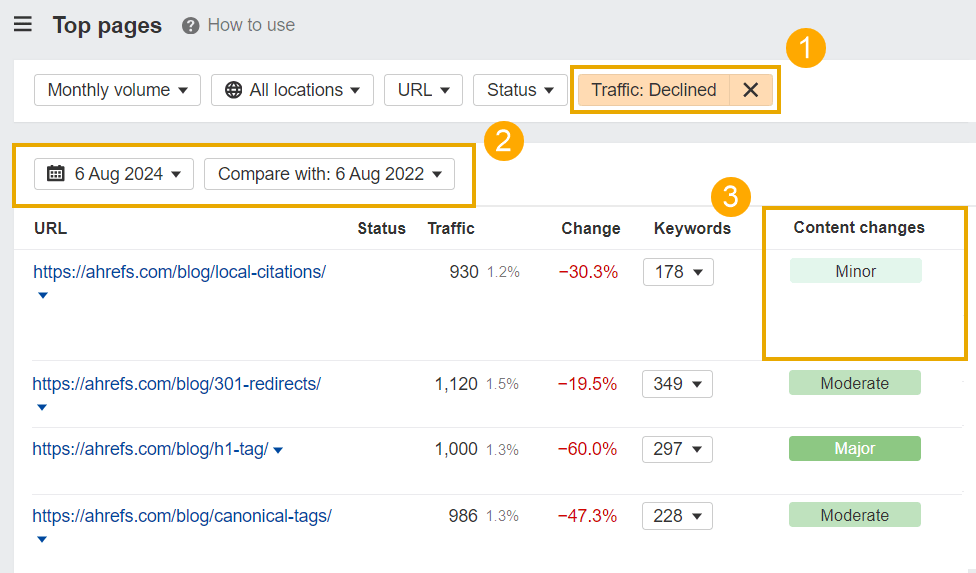
“热门页面”会展示你网站上带来最多自然流量的内容。向这些页面推送更新,会促使爬虫更频繁地访问你最优质的内容,并(有望)提振任何正在下滑的流量。
3. 优化网站结构
通过逻辑清晰的站点地图提供明确的网站结构,并用相关的内链加以支撑,将帮助爬虫:
- 更好地浏览你的网站
- 理解其层级结构
- 索引并排名你最有价值的内容
这些因素综合起来也会让用户满意,因为它们有助于便捷导航、降低跳出率并提升参与度。
以下还有更多可能影响网站被发现与否以及在抓取中被排定优先级的要素:
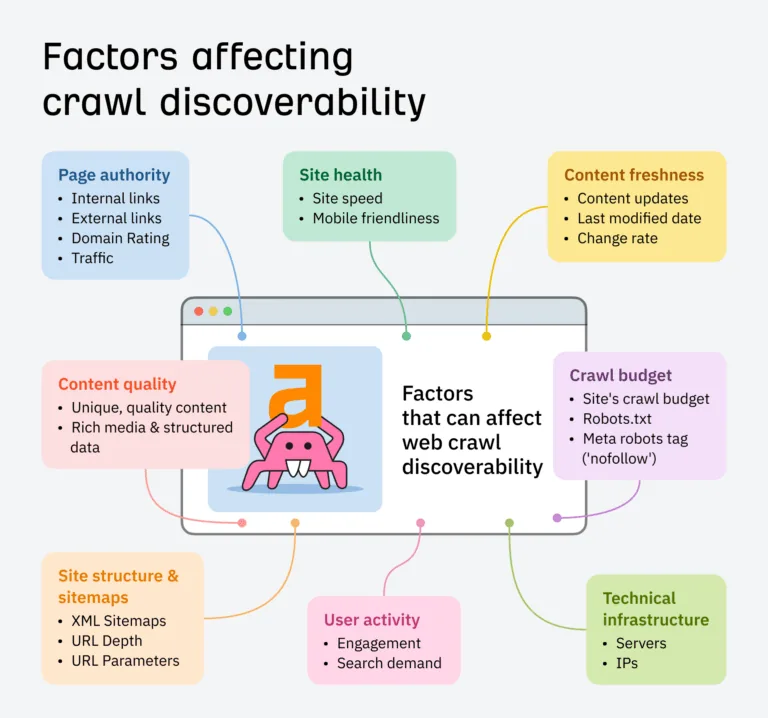
像 Google 这样的网络爬虫会抓取整个互联网,你无法控制它们访问哪些网站,也无法控制访问频率。
但你可以做的是使用网站爬虫,它们就像你自己的私人机器人。
让它们抓取你的网站,以发现并修复重要的 SEO 问题;或者研究竞争对手的网站,把他们最大的弱点变成你的下一个机会。
站点爬虫本质上是在模拟搜索表现。它们帮助你理解搜索引擎的网络爬虫可能如何解读你的页面,依据的是页面的:
- 结构
- 内容
- 元数据
- 页面加载速度
- 错误
- 等等
示例:Ahrefs Site Audit
Ahrefs Site Audit 爬虫为以下工具提供支持:RankTracker、Projects,以及 Ahrefs 主要的网站抓取工具:Site Audit。
Site Audit 帮助 SEO 人员:
- 分析 170 多种技术 SEO 问题
- 按需抓取,并附带实时站点表现数据
- 每分钟评估多达 17 万个 URL
- 排查、维护并提升其在搜索引擎中的可见度
从 URL 发现到重新访问,网站爬虫的运作方式与网络爬虫非常相似——只不过它们不会在 SERP 中索引和排名你的页面,而是将其存储在自己的数据库中进行分析。
你既可以在本地抓取网站,也可以远程抓取。像 ScreamingFrog 这样的桌面端爬虫让你能下载并自定义站点抓取,而像 Ahrefs Site Audit 这样的云端工具则在不占用你计算机资源的情况下完成抓取——帮助你协作处理修复和站点优化。
如何抓取你自己的网站
如果你想实时扫描整个网站以检测技术 SEO 问题,可以在 Site Audit 中配置一次抓取。
它会为你提供可视化的数据明细、站点健康评分以及详细的修复建议,帮助你理解搜索引擎是如何解读你的网站的。
1. 设置你的抓取
前往 Site Audit 标签页,选择一个已有项目,或者新建一个。
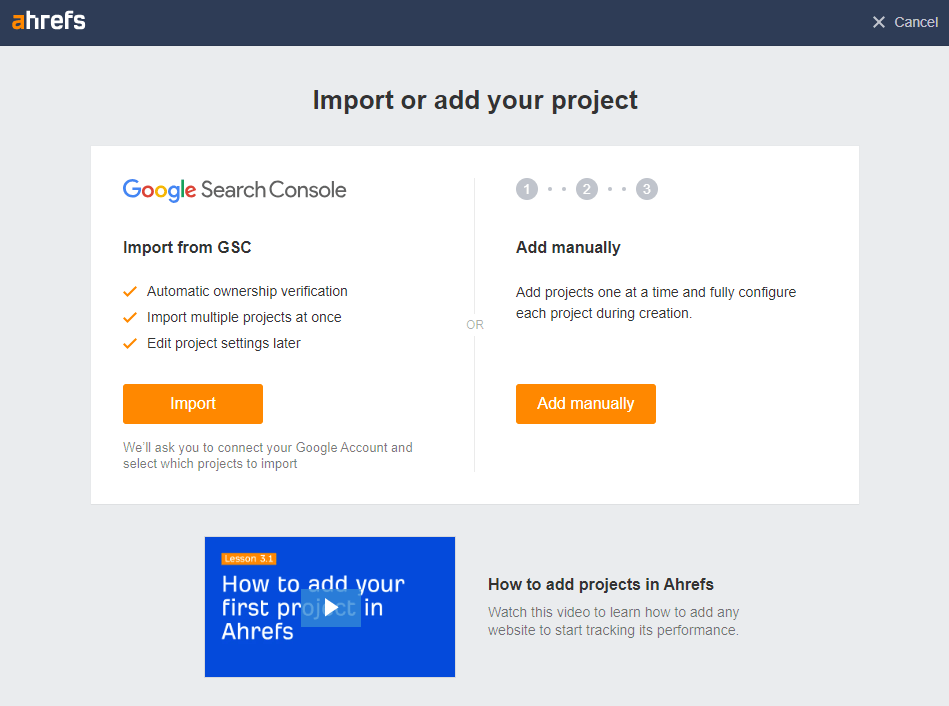
一个项目就是你想要长期跟踪的任何域名、子域名或 URL。
一旦你配置好抓取设置——包括抓取计划和 URL 来源——你就可以启动审计,完成时你会立即收到通知。
以下是一些你可以立即着手做的事。
2. 诊断主要错误
Site Audit 中的“主要问题”(Top Issues)概览会根据受影响的 URL 数量,向你展示最紧迫的错误、警告和提示。
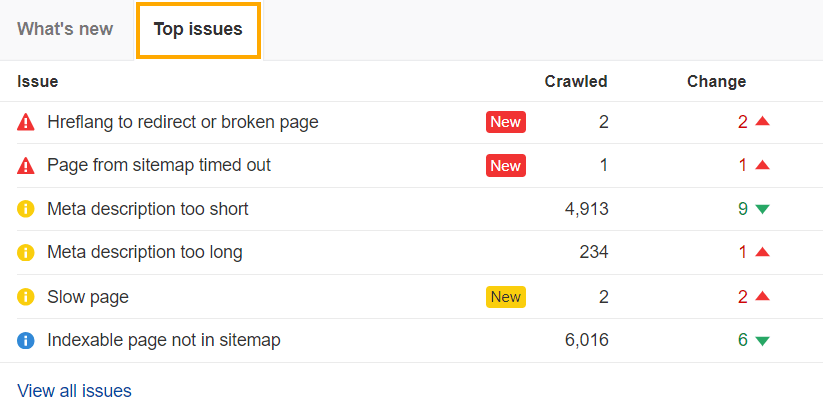
把它们作为 SEO 路线图的一部分逐一处理,将帮助你:
1. 发现影响抓取的错误(红色图标)——例如
- HTTP 状态码/客户端错误
- 失效链接
- 规范标签(canonical)问题
2. 依据警告(黄色)优化你的内容和排名——例如
- 缺少 alt 文本
- 指向重定向的链接
- 过长的元描述
3. 借助提示(蓝色图标)维持稳定的可见度——例如
- 自然流量下滑
- 多个 H1 标签
- 可索引页面未包含在站点地图中
筛选问题
你还可以使用筛选器来排定修复的优先级。
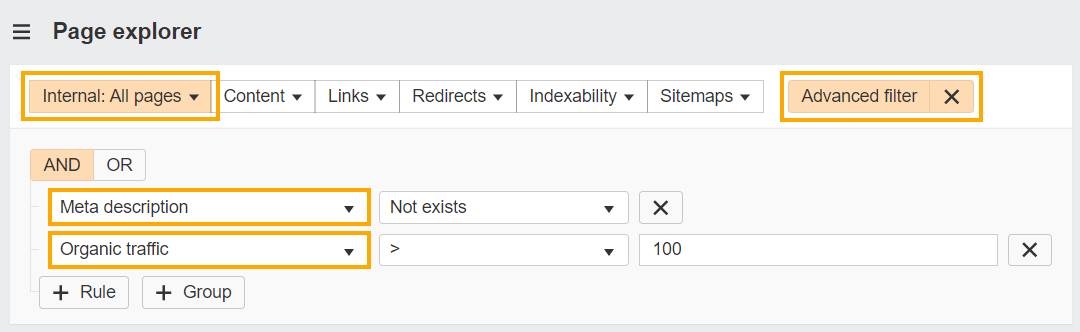
假设你有成千上万个缺少元描述的页面。通过优先处理高流量页面,可以让任务更易管理、也更有成效。
- 前往 Site Audit 中的 Page Explorer 报告
- 选择高级筛选器下拉菜单
- 设置一个内页筛选条件
- 选择一个“And”操作符
- 选择“Meta description”和“Not exists”
- 选择“Organic traffic > 100”
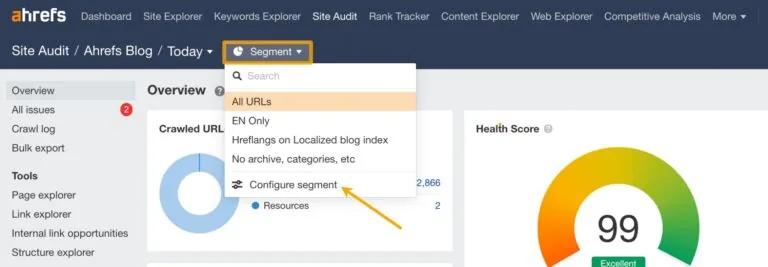
抓取网站中最重要的部分
利用 Site Audit 的 200 多个筛选器,把网站上最重要的页面(例如子文件夹或子域名)细分并聚焦——无论它是你的博客、电商商店,还是流量超过某一阈值的页面。
3. 加快修复
如果你没有编程经验,那么抓取网站并实施修复这件事可能令人生畏。
如果你确实有开发支持,问题就更容易解决,但接下来就变成了要去争取别人的时间。
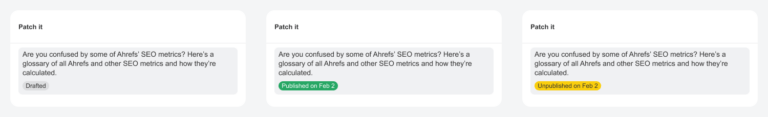
我们推出了一个新功能,帮你解决这类头疼问题。Patches 让你能在 Site Audit 中自主完成修复。
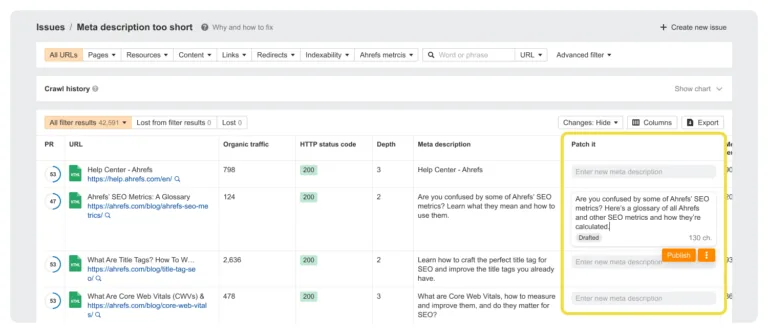
标题变更、缺少元描述、全站失效链接——当你面对这类错误时,可以点击“Patch it”直接把修复发布到你的网站,无需再去麻烦开发人员。
如果你对任何地方拿不准,也可以随时回滚你的补丁。
4. 发现优化机会
用网站爬虫审计网站,既是修复缺陷,同样也是发现机会。
改善内链
Site Audit 中的“内链机会”(Internal Link Opportunities)报告会向你展示相关的内链建议:它先取出每个已抓取页面流量最高的 10 个关键词,然后在你其他已抓取的页面中寻找这些关键词的提及。
“来源”(Source)页面是你应该从其建立链接的页面,“目标”(Target)页面是你应该链向的页面。
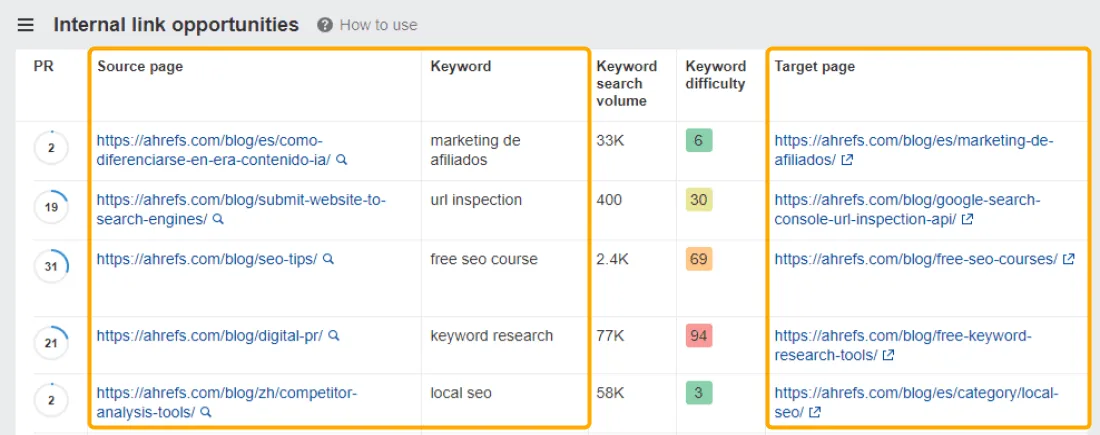
你在内容之间建立的高质量连接越多,Googlebot 抓取你网站就越容易。
最后总结
理解网站抓取不仅仅是一个 SEO 小技巧——它是直接影响你流量和投资回报率的基础知识。
了解爬虫如何工作,就意味着了解搜索引擎如何“看待”你的网站,而这就是排名之战的一半。