ChatGPT 不同推理模式之间仅有 25% 的被引用来源重合[研究]
ChatGPT 的 Thinking 模式会如何影响 AI 可见度?新研究揭示了引用与来源方面的重大差异。
大多数 AI 可见度策略都把 ChatGPT 当作一个单一系统来对待。数据表明,这么做可能并不明智。
当 ChatGPT 以高推理模式运行时,它引用的品牌组合、呈现的来源类型都与最小推理模式不同,行为方式也有差异。
Kevin Indig 将这种同一模型与另一模型之间展示结果的差距称为"推理增益(reasoning lift)"。为了研究它,我们与 Kevin 合作,分析了来自 Semrush AI Visibility Toolkit 的数据。
以下是我们发现的结果:
核心结论
- 更高推理能力的 ChatGPT 本质上是一个不同的搜索引擎。对于相同的提示词,最小推理与高推理之间仅有 25.6% 的被引用域名重合。近四分之三的被引用来源是不同的。
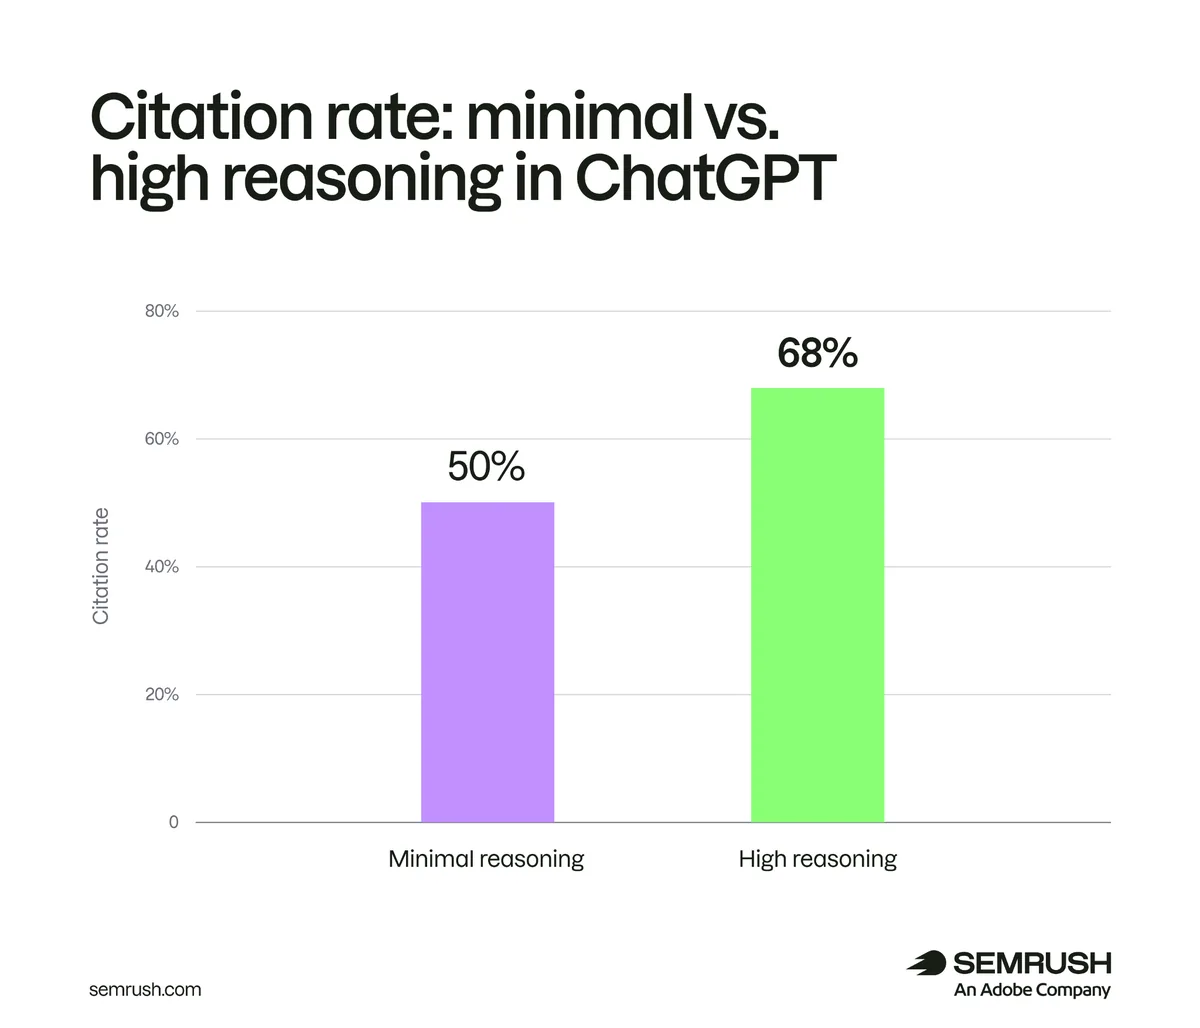
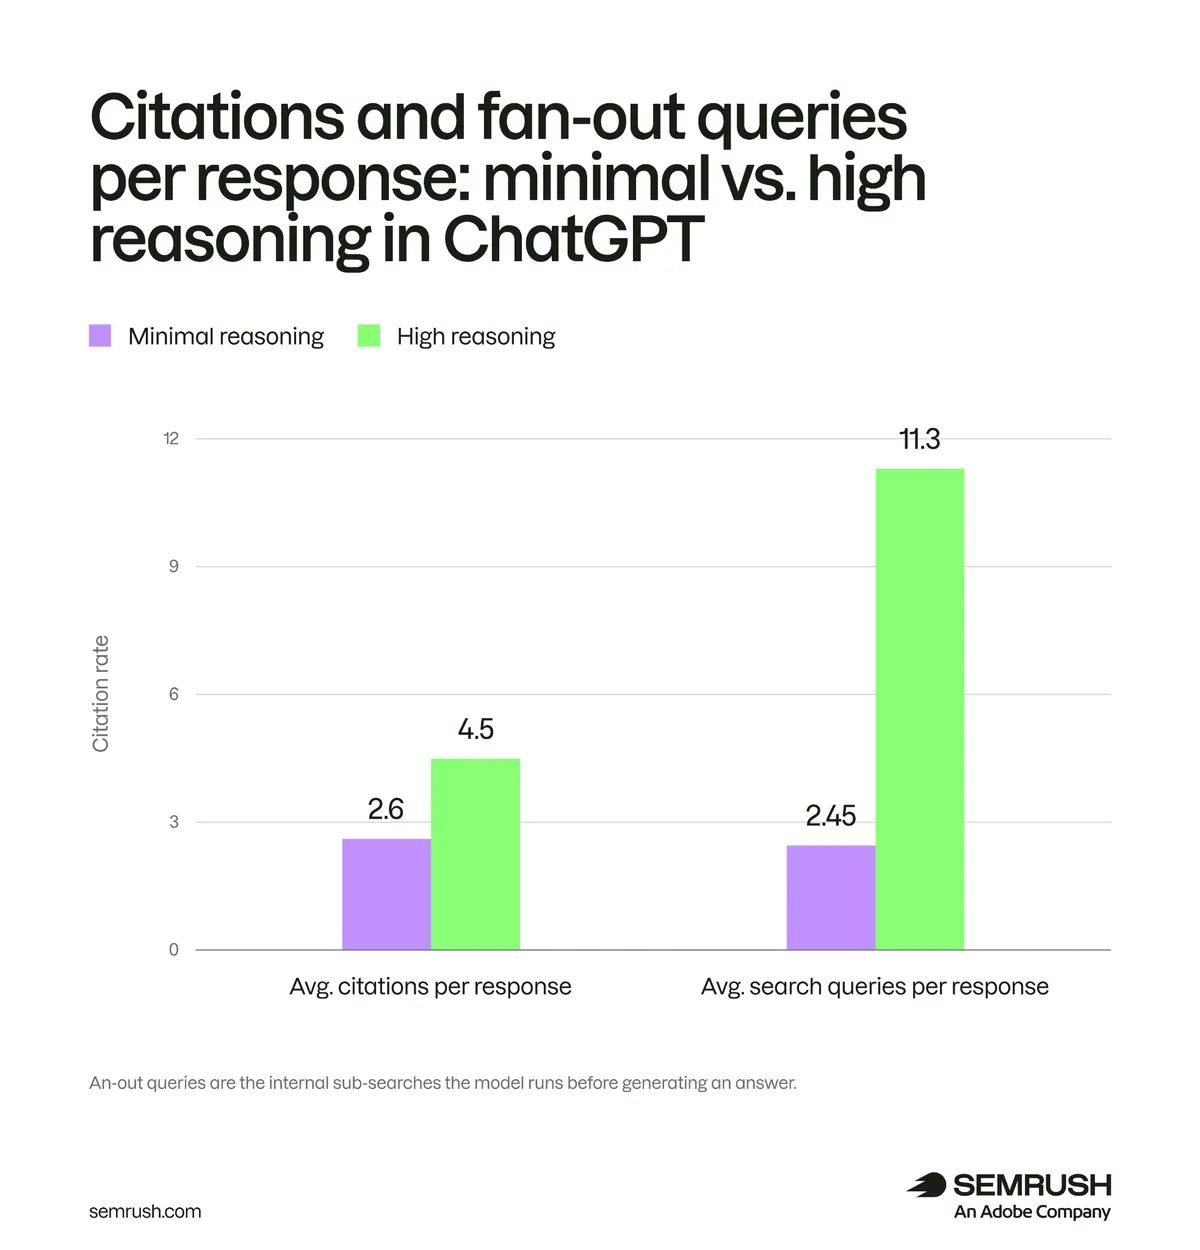
- 开启更高推理后,引用行为会发生巨大变化。对比低推理与高推理,引用率从 50% 跃升至 68%,每次回答的来源数几乎翻倍(2.6 → 4.5),而高推理模型触发的内部子查询数量多出 4.6 倍。
- 开启推理后,来源类型会发生转变。与 Instant 模式相比,在 Thinking 模式下 Reddit 及其他用户生成内容(UGC)网站丢失了大约一半的引用份额,而政府、学术和官方文档网站则占比上升。
- 在高推理下,同一品牌往往能从买家最初的问题一直保留到最后一个问题。在我们测试的 20 条旅程中,有 4 条出现了这种情况。而在最小推理下,全漏斗持续出现非常罕见。
- 从最小推理切换到高推理对某些行业的影响远大于其他行业。金融类内容的引用率跃升 28 个百分点,而消费科技类几乎没变化。
- 在高推理下,漏斗顶部的内容有真实价值。在用户早期研究问题中被引用的品牌,往往会继续出现在同一对话中之后更具体的查询里——但这只在开启高推理模式时成立。
- 从最小推理切换到高推理对某些行业的影响远大于其他行业。金融类内容的引用率跃升 28 个百分点,而消费科技类几乎没变化。
研究方法
我们与来自 Growth Memo 的 Kevin Indig 合作,分析了来自 Semrush AI Visibility Toolkit 的数据。
我们把 100 条提示词分别通过 GPT-5.2 运行了两次:一次使用最小推理,一次使用高推理。因此,我们共获得了 200 条回答。
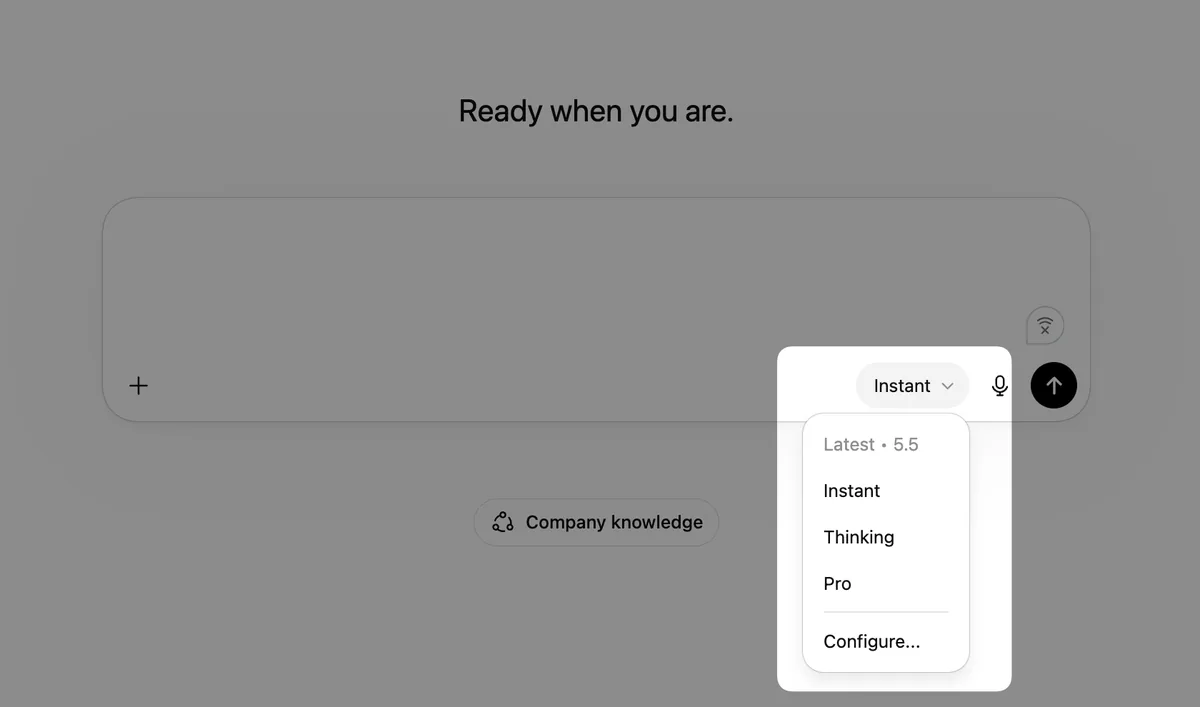
在 ChatGPT 的界面中,最小推理对应 Instant 模式(默认的快速响应体验),高推理对应 Thinking 模式(更深入、多步骤的研究模式)。
Instant 是默认体验,而 Thinking 模式则是为更复杂、多步骤的任务而设计的。
我们分析的这 100 条提示词涵盖了四大类别的 20 条买家旅程:
- B2B SaaS
- 金融
- 消费科技
- 健康与生活方式
每段购买旅程分为五个阶段:
- 问题:意识到某种需求或痛点
- 探索:研究存在哪些选项
- 比较:并排评估各种备选方案
- 验证:确认领先的选择
- 选定:确定某个具体品牌或产品
对于每条回答,我们追踪了:
- 引用率:引用了至少一个外部来源的回答所占比例
- 平均引用数:每条有引用的回答所包含的来源数量
- 扇出查询(fan-out queries):模型在回答某个提示词之前为研究它而运行的子查询数量
下面逐一说明这些发现。
1. 高推理引用来源、使用网络搜索的频率高得多
当你开启高推理时,ChatGPT 会更依赖主动研究:
- 引用率:从 Instant 模式的 50% 攀升至 Thinking 模式的 68%(+18 个百分点)
- 平均引用数:从 Instant 模式到 Thinking 模式,每条回答的引用数量几乎翻倍(2.6 到 4.5)
- 扇出查询:Thinking 模式下运行的子查询数量是 Instant 模式的 4.6 倍
高推理在整套测试中还从 173 个独立域名中提取了内容,而最小推理只有 127 个。而在高推理模式下出现的那些域名中,有 99 个在最小推理下完全不曾出现。
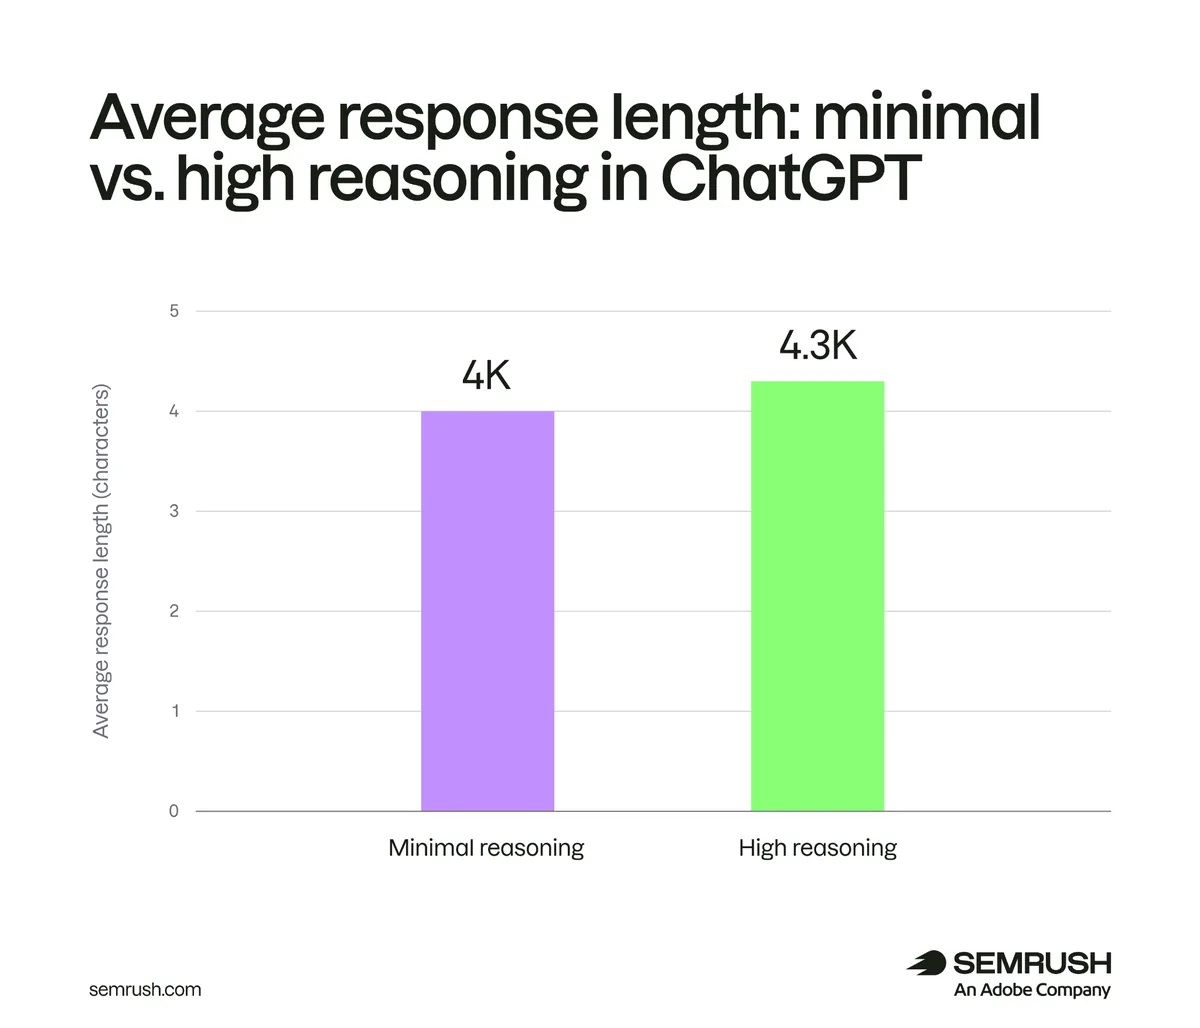
与此同时,高推理模式给出的回答长度只略微更长。这意味着引用量的增加并不只是生成了更多文本的副产品。相反,模型在幕后做了大量更多的研究,并在大致相同的输出长度中塞入了更多证据。
这对免费套餐用户也很重要,因为 ChatGPT 会把复杂的提示词(比较、评估、监管类问题以及其他多步骤决策)自动路由到高推理模式。
对品牌而言,其含义很直接:当你的受众提出这些复杂问题之一时,你并不是在一次回答中争夺一个展示位置。你是在模型为得到那个答案而运行的每一次子搜索中争夺可见度。
2. 每种推理模式引用的域名各不相同
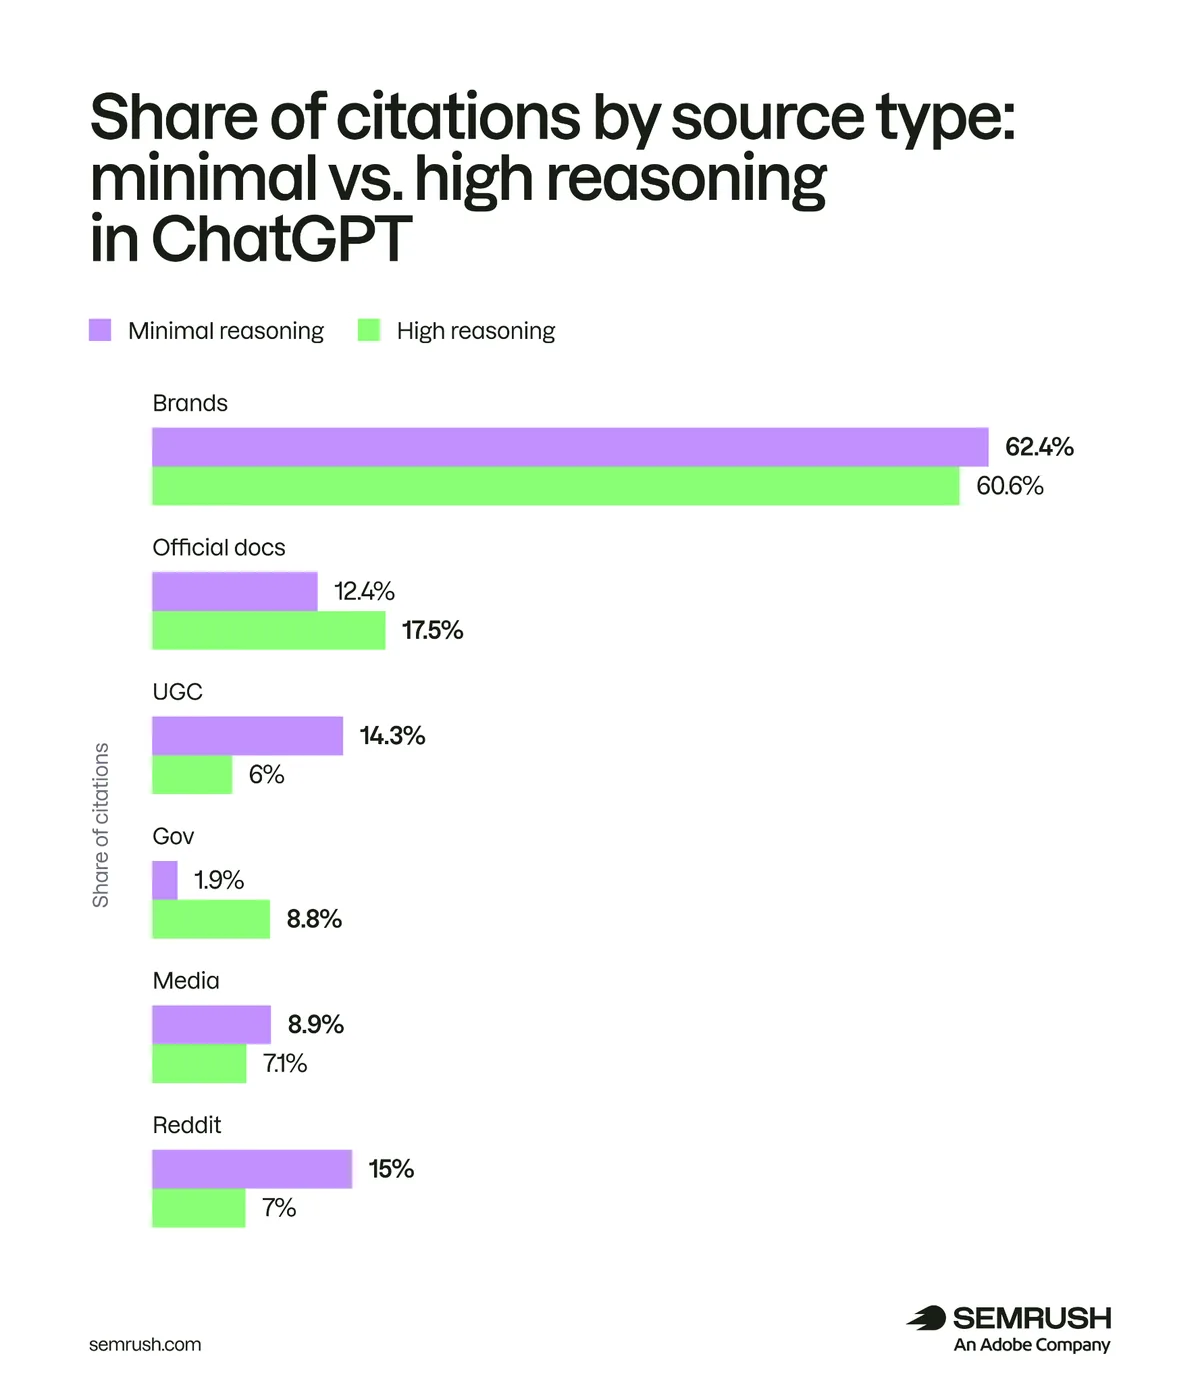
对于相同的提示词,最小推理与高推理模式之间仅有 25.6% 的被引用域名是共有的。近四分之三的被引用来源是不同的。
整体来源构成也发生了变化:
- Reddit 的出现率从低推理的 15% 降至高推理的 7%
- UGC 和评测网站从低推理的 14.3% 缩减到高推理的 6%
- 政府和学术来源从低推理的 1.9% 增长到高推理的 8.8%,翻了两番
- 官方文档和支持页面从低推理的 12.4% 增长到高推理的 17.5%
- 品牌的出现率几乎持平(低推理 62.4%,高推理 60.6%)
"在最小推理下胜出的品牌,并不是在高推理下胜出的品牌。来源类型的构成不同。引用出现的阶段不同。这是两个不同的系统。"
—— Kevin Indig,增长顾问
实际含义如下:如果你目前大部分 AI 引用都来自 Reddit 帖子、Quora 或 UGC 评测网站,那么你是通过 Instant 模式在胜出,但可能会在 Thinking 模式下落败。
要在两种模式下都保持良好表现,请把内容投入聚焦在高推理实际会提取的那些来源类型上。
这意味着在你自己的网站上拥有更多官方文档和参考页面,发布原创研究,让写作者和学者有内容可引用,并通过合作、专家投稿和数据分享,让你的品牌出现在 .gov、.edu 和行业协会类资源中。
3. 最大的模式差距出现在买家旅程的前期
最小推理与高推理之间的引用率差距并非恒定不变。它取决于用户处于买家旅程的哪个位置,以及他们当时在问哪类问题。
为便于说明,一位评估 CRM 软件的买家可能会用以下问题走完这五个阶段:
- 问题:"我怎么知道我的销售团队是否需要 CRM?"
- 探索:"B2B SaaS 有哪些类型的 CRM 软件?"
- 比较:"面向 50 人销售团队,HubSpot、Salesforce、Pipedrive 怎么选"
- 验证:"对中端市场 B2B 公司来说,HubSpot 的价格值不值?"
- 选定:"我该如何开始使用 HubSpot Sales Hub?"
在全部 20 条旅程中,有三种模式格外突出:
- 在旅程早期,两种模式几乎不重合。在"问题"阶段,高推理模式的引用率比最小推理高出 35 个百分点。到了"验证"阶段,差距缩小到 5 个百分点。最小推理模式往往在回答漏斗顶部的问题时不引用外部来源,而高推理模式更有可能去研究并引用它们。
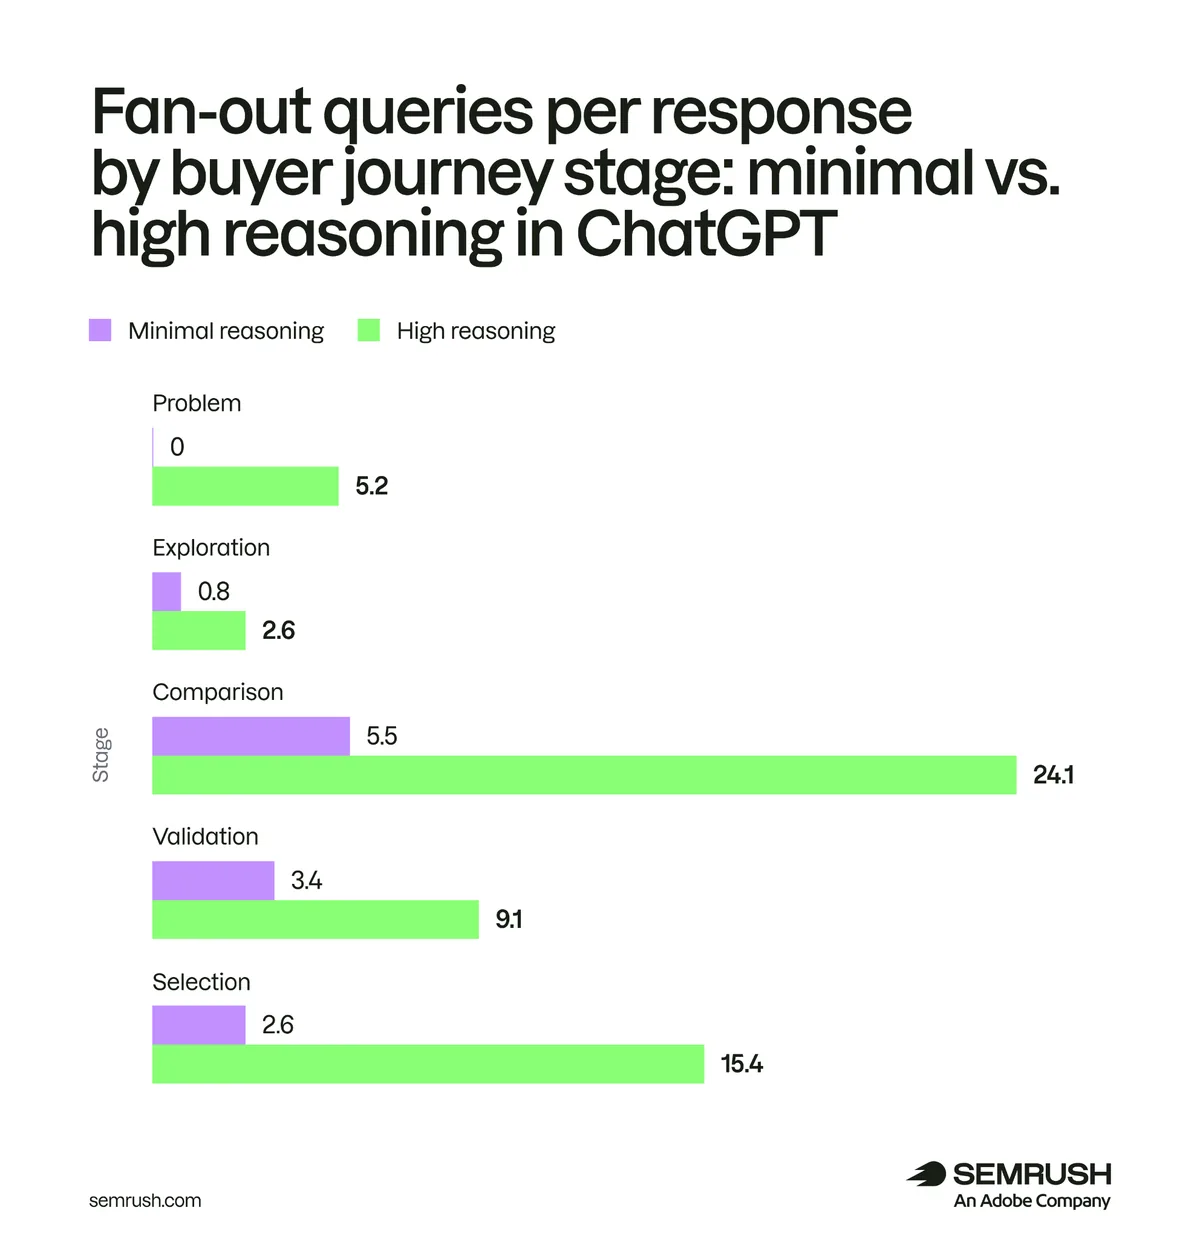
- "比较"阶段是高推理模式研究最深入的地方。它为每个"比较"类提示词触发 24 个子查询,而最小推理只有 5.5 个。每条回答的平均引用数也在此处达到峰值:高推理为 9.8,最小推理为 5.8。
- 在"选定"阶段,高推理仍然比最小推理提取更多来源。每条高推理回答平均引用 4.7 个来源,而最小推理为 2.6 个。两种模式在这里都大量引用网络内容;高推理只是挖得更深。
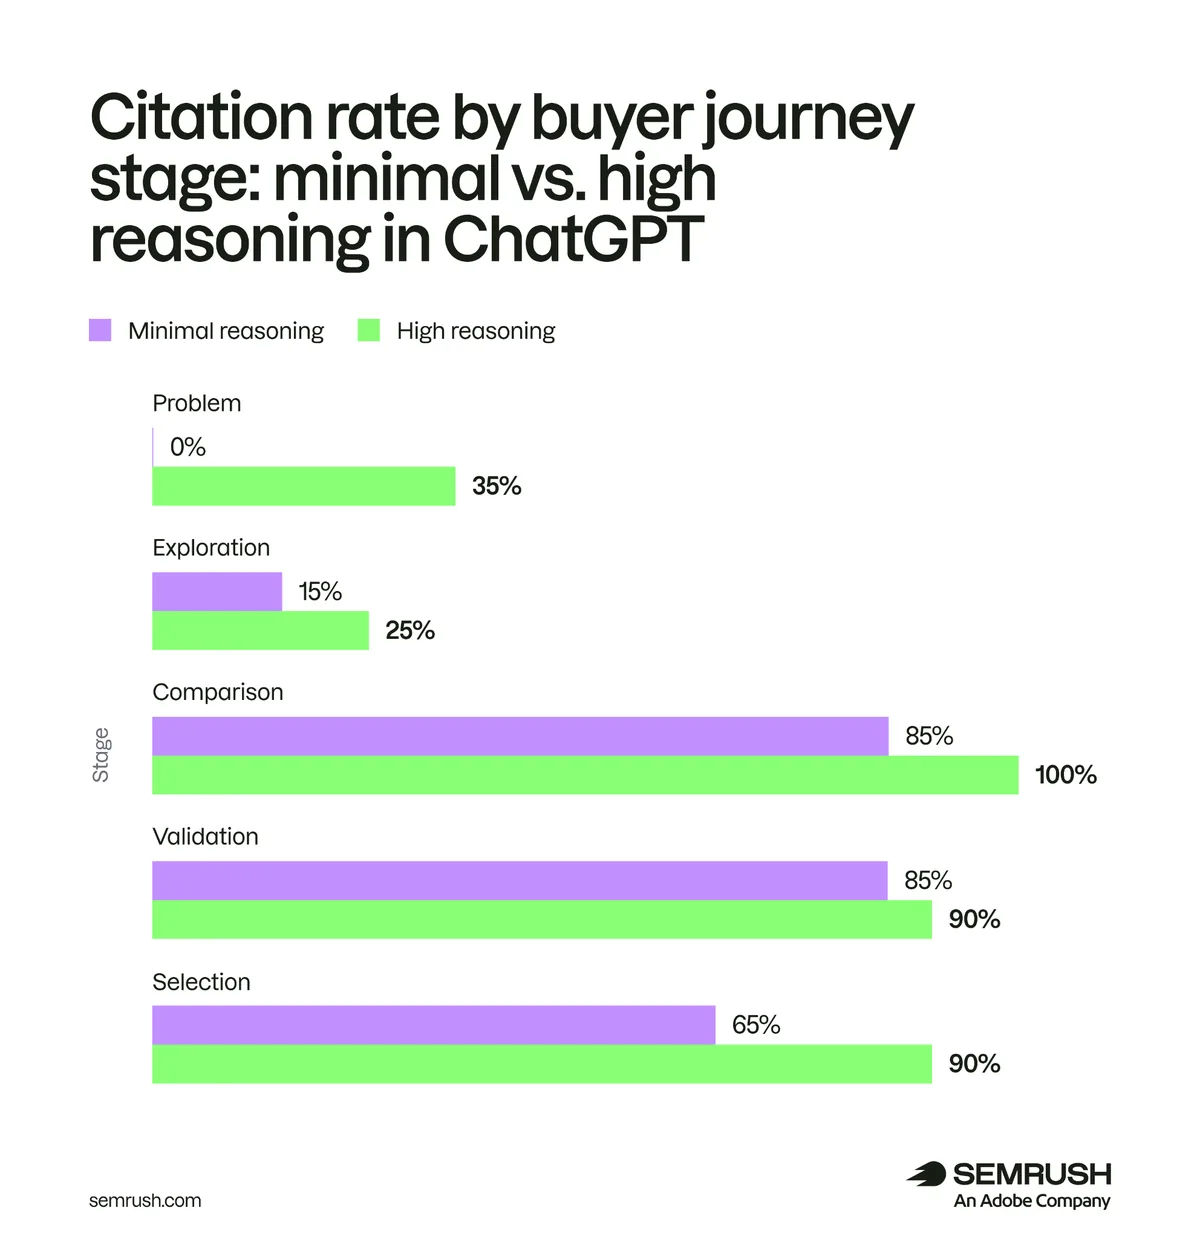
在我们测试的 100 条提示词中,最小推理总共运行了 245 次网络搜索。高推理运行了 1,130 次网络搜索,几乎是前者的 5 倍。这些额外的研究大多发生在"比较"和"选定"阶段,也就是用户在具体产品之间做选择的时候。
扇出查询也呈现相同的形态,并且在高推理下每个阶段都显著更高。它们在"比较"阶段激增(每条回答 24 个子查询,而最小推理为 5.5 个),在"选定"阶段再次激增(15.4 对 2.6)——而这两个阶段正是模型积极研究具体产品选项的时候。
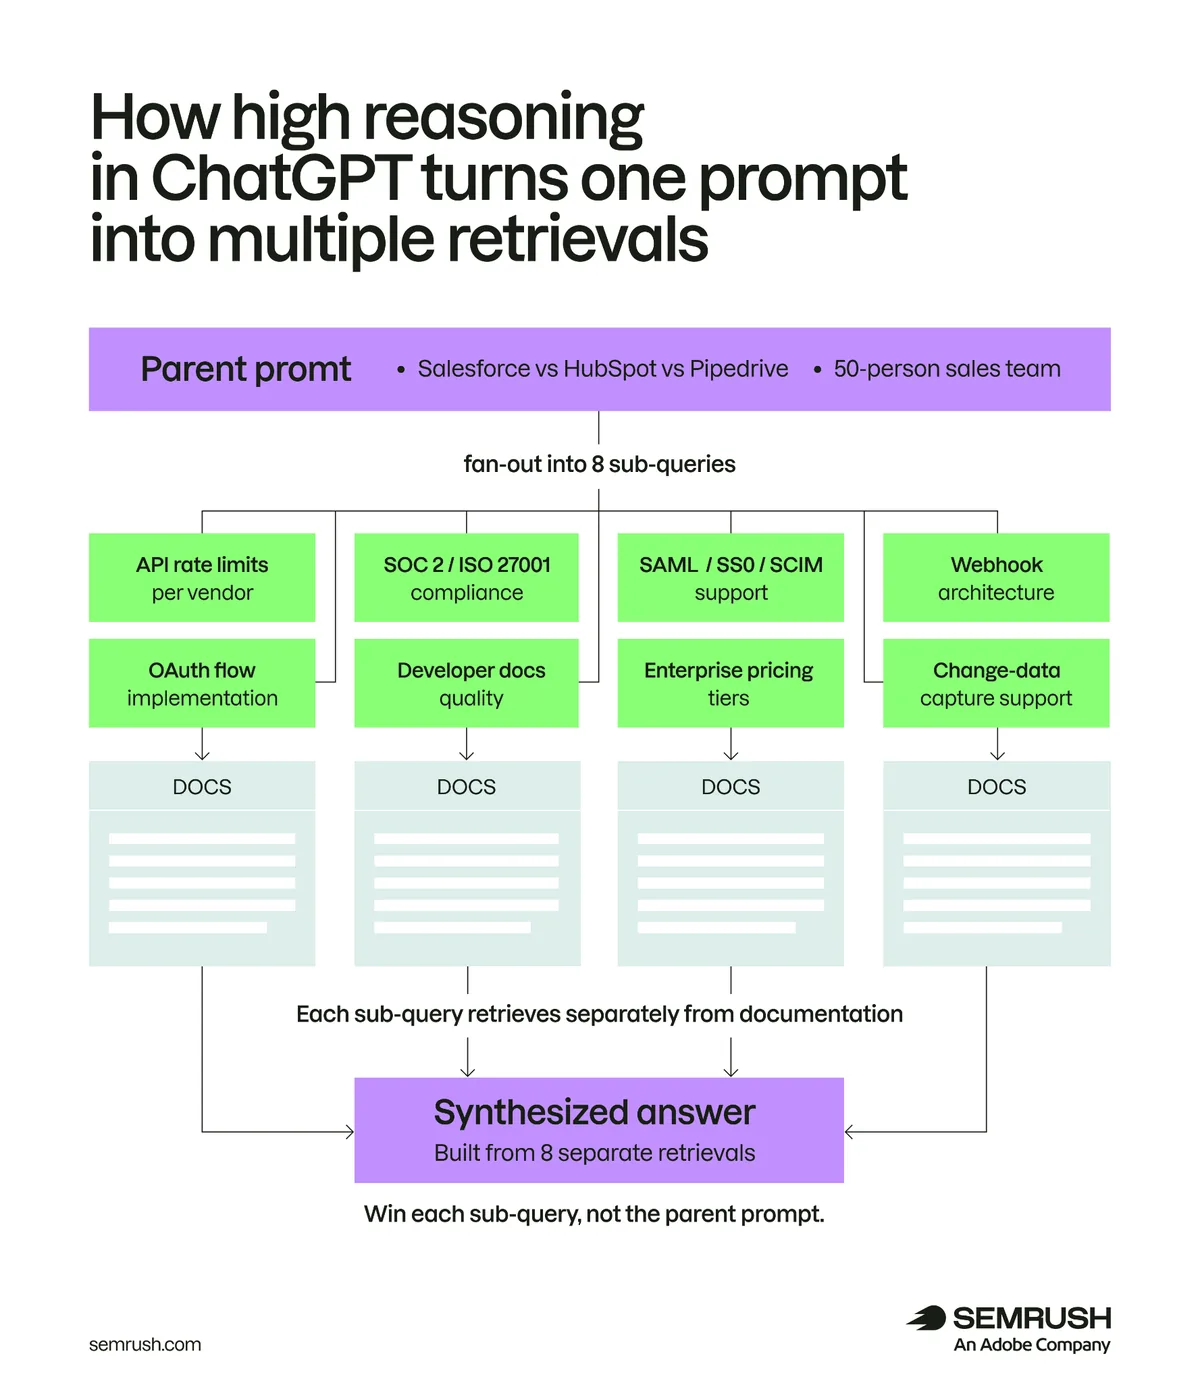
当高推理模式收到"面向 50 人销售团队,Salesforce、HubSpot、Pipedrive 怎么选"这样的提示词时,它并不只是搜索这一条具体的提示词。它把问题拆解成大约 8 个子查询(与定价档位、API 集成、安全合规和开发者文档相关的内容),并为每一个单独运行一次搜索。
赢得这次回答的品牌,未必是在原始提示词上排名的那个。而是那个在许多这些子搜索中都有页面清晰出现的品牌。
这意味着你不应把漏斗顶部的内容仅仅当作品牌知名度来看待。大多数用户会混合提出随意和复杂的提示词,而复杂的那些会自动触发高推理模式。
把你早期漏斗的内容当作引用来源来对待。明确点出你的产品、方法论或框架的名称,这样当 AI 展示这些页面时,就有东西可以归属。
4. 在高推理模式下,品牌能贯穿整段旅程
大语言模型(LLM)会话是对话而非单次查询。因此一个关键问题是:在旅程开始时被引用的品牌,能否贯穿到最后?
在高推理下,可以。在最小推理下,不行。
我们通过检查在"问题"阶段被引用的品牌能否存续到同一段旅程的"选定"阶段,来衡量品牌的持续性:
- 最小推理:没有任何旅程出现这种全漏斗持续性
- 高推理:20 条旅程中有 4 条保持了品牌连续性
高推理还会在单条回答中不止一次地回到同一来源。在 100 条高推理回答中,有 51 条在同一回答中多次出现同一域名(而最小推理是 100 条中有 26 条)。
这与旅程持续性是不同的效应:锚定关乎深度(模型在单条回答中多大程度依赖某一个来源),而持续性关乎连续性(同一品牌是否在多步骤对话中不断出现)。
"漏斗顶部的内容对 AI 可见度而言不只是品牌知名度。在高推理模式下,它是模型在决策之时最终落到何处的先行指标。"
—— Kevin Indig,增长顾问
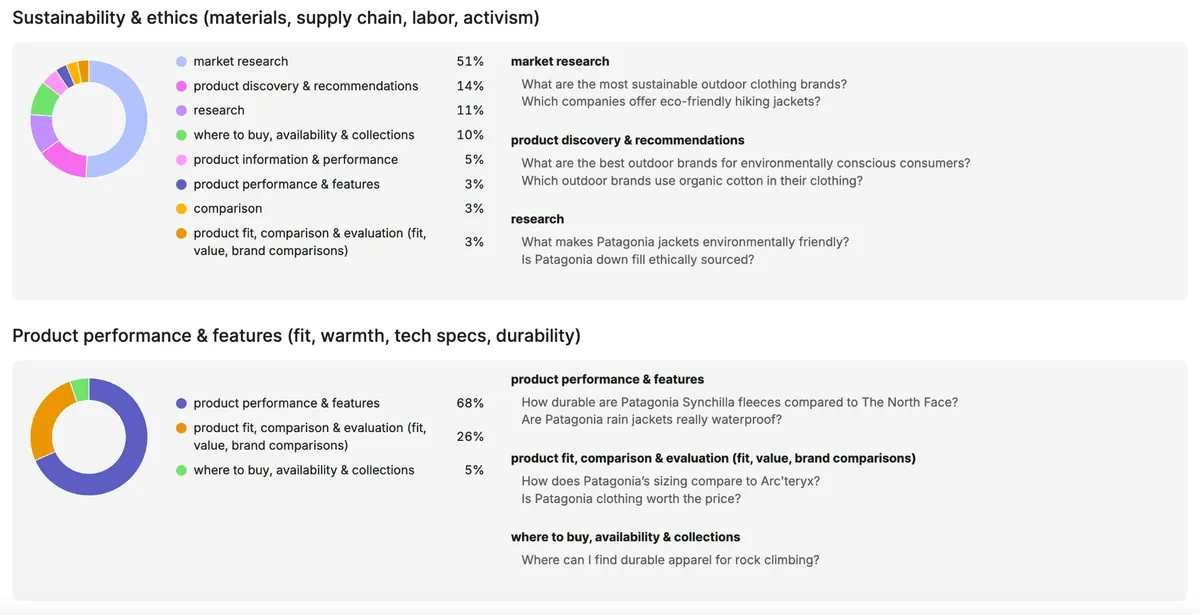
为确保品牌连续性,请跨完整买家旅程和意图类别审计你的 AI 可见度。在 AI Visibility Toolkit 中,打开 Questions 报告,探索你的客户向 AI 工具提出的关键话题,并按意图和漏斗阶段分类。
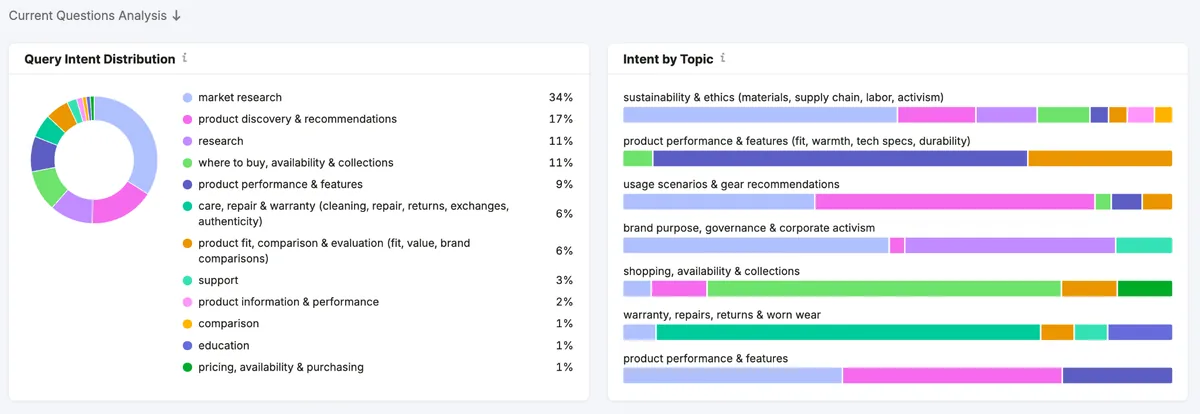
然后,分析人们每个阶段和话题中提出的具体问题。
接下来,前往 Narrative Drivers 报告,看看你的品牌在漏斗各阶段的关键对话中与竞争对手相比是如何呈现的。
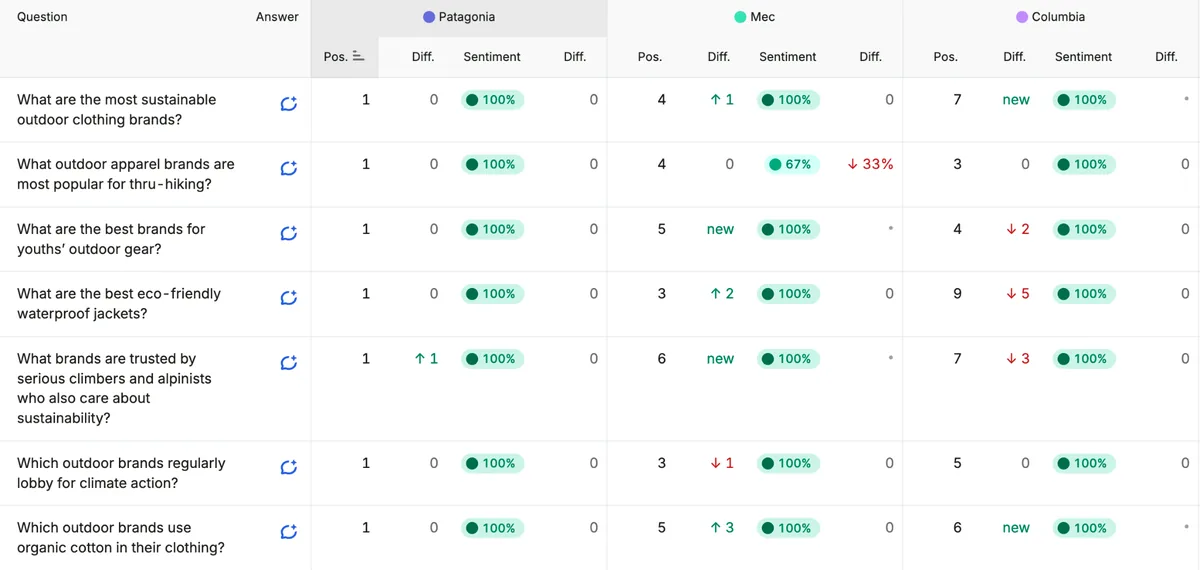
如果你在决策阶段(比较、验证、选定)的提示词中出现,但在早期阶段(问题、探索)却没有,那就是一个值得弥合的差距。
在高推理模式下,旅程早期被引用的品牌往往会在之后继续被引用,因此投入"问题"阶段的内容可以让现有的"选定"阶段可见度产生复合效应。
5. 推理增益因类别而差异显著
并非我们分析的所有类别在开启高推理模式时,引用率的提升程度都相同。它因行业而异:
- 金融:引用率从低推理到高推理提升 28 个百分点
- 健康与生活方式:引用率从低推理到高推理提升 24 个百分点
- B2B SaaS:从低推理到高推理提升 16 个百分点
- 消费科技:从低推理到高推理提升 4 个百分点
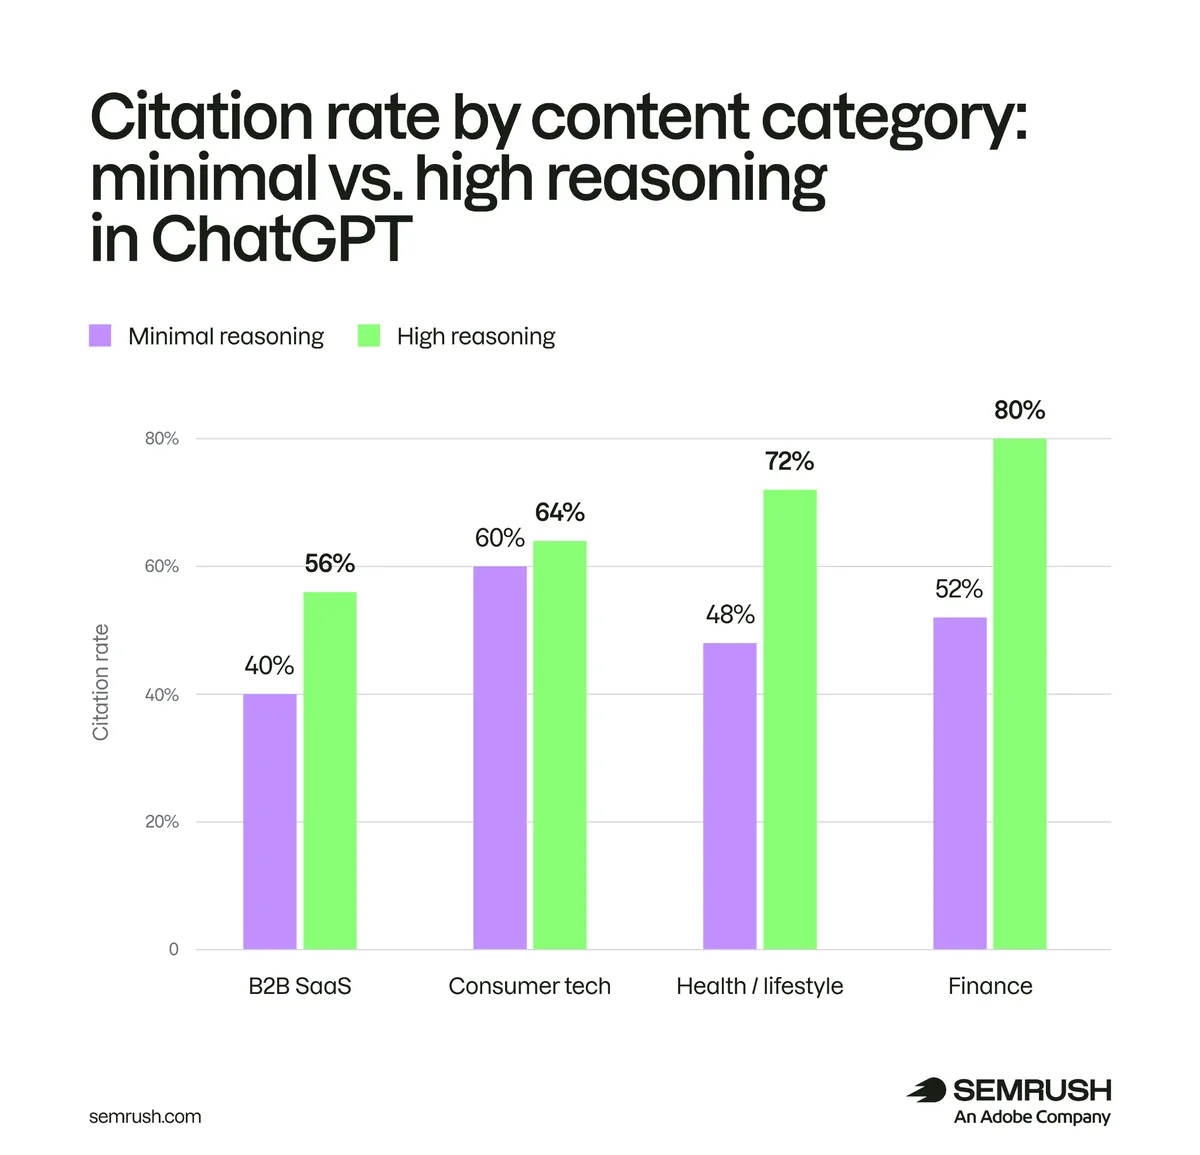
消费科技格外突出。
尽管高推理在每个消费科技类提示词上运行的子查询(13.4 个)比我们测试的任何其他类别都多,但它最终引用的品牌和来源却与最小推理有很多相同。
换句话说,额外的研究几乎没有改变消费科技类的答案,这表明 ChatGPT 从其训练数据中已经对常见的消费科技话题拥有很强的内部知识,无需新鲜的研究就能落到相同的品牌上。
对金融和健康类品牌而言,为高推理优化就意味着创作模型会主动提取进其子搜索的内容。
在实践中,这意味着发布官方产品文档、以自有数据为支撑的白皮书,以及结构化内容(每个板块有清晰论断、命名实体、明确的统计数据),让模型能干净地提取进单条子查询的回答中。
如何针对每种推理模式调整你的 AI 可见度策略
这些发现表明,最小推理和高推理行为不应被视为同一个可见度表面。它们从不同来源提取内容、偏好不同的内容类型,并且对同一品牌可能产生非常不同的赢家。
目标不是挑选一种模式并只针对它优化,而是确保你在两种模式下都可见。
方法如下:
- 按推理模式拆分你的追踪。使用像 Prompt Tracking 这样的工具,把你已经监测的提示词分成两类:复杂查询(多标准评估、并排比较、监管或合规类问题)和简单查询(定义、单一因素查询、基础的"什么是 X"问题)。分别追踪每一类的引用率、提及率以及被引用最多的域名。两类差异最大的地方,正是推理增益在重塑谁胜出的地方。
- 构建双轨内容策略。针对最小推理的可见度,投入比较阶段的内容、Reddit 和评测网站的存在感,以及你网站上清晰的产品导向页面。针对高推理的可见度,投入早期漏斗的教育内容、官方产品文档、白皮书,以及放在可引用 URL 上的权威参考资料。
- 按阶段梳理并审计你的重点买家旅程。对每一段重点旅程,写下买家在五个阶段(问题、探索、比较、验证、选定)各自会问的问题。然后在开启 Thinking 模式下把这些通过 ChatGPT 运行一遍,记录你的品牌出现在哪里、又在哪里消失。你缺席的阶段就是你杠杆率最高的内容缺口。
理解这些差异,要从在提示词和旅程层面衡量 AI 可见度开始。
Semrush AI Visibility Toolkit 会向你展示哪些提示词和意图类别驱动着你的品牌在 AI 回答中的可见度、哪些来源影响着那些回答,以及你的存在感如何随买家旅程而变化。
即使没有内置的推理模式筛选器,这些数据也能告诉你推理增益最可能在哪里起作用,以及该在哪里投入以弥合差距。