日志文件分析:为 SEO 下载并审计日志
日志文件分析指下载并审计网站的日志文件,以发现并修复技术 SEO 问题。
什么是日志文件?
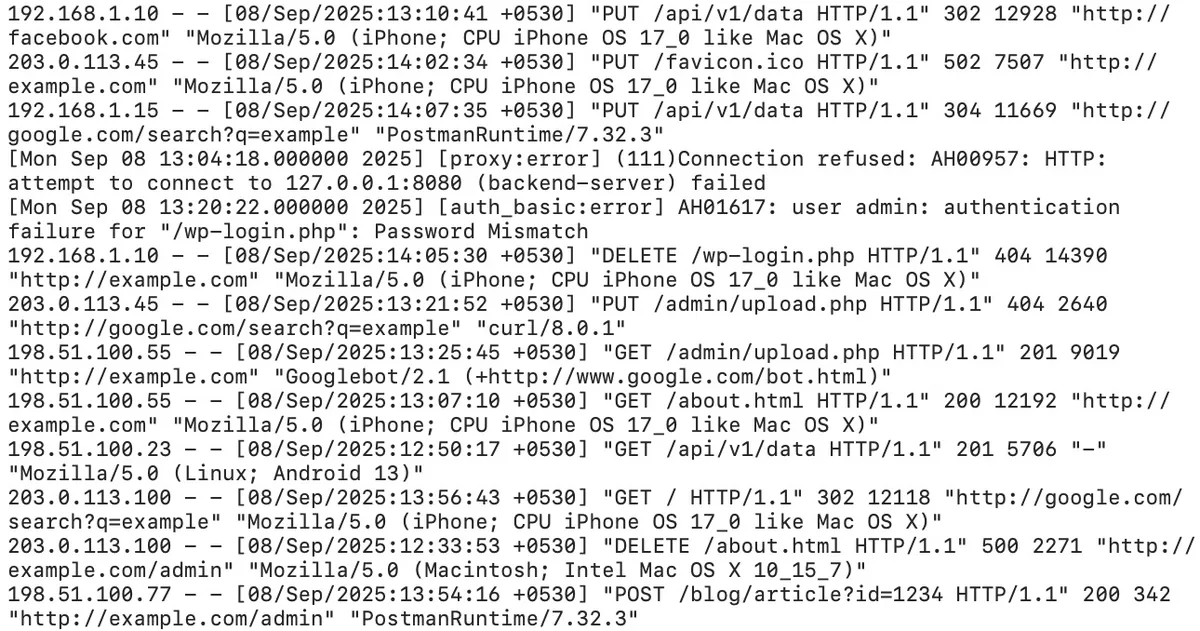
日志文件是记录发往服务器每一次请求的文档,这些请求既可能来自与网站互动的人,也可能来自抓取网站的搜索引擎机器人(即发现页面)。
日志文件可以显示以下重要细节:
- 请求的时间
- 发起请求的 IP 地址
- 哪个机器人抓取了网站(如 Googlebot 或 ChatGPT 机器人)
- 所访问资源的类型(如页面或图片)
日志文件可能看起来像这样:
 什么是日志文件分析?
日志文件分析是指下载并审计网站的日志文件,以主动发现漏洞、抓取问题和其他技术 SEO问题的过程。
分析日志文件可以显示 Google 及其他搜索引擎与网站的互动方式,并揭示可能影响搜索可见度的抓取错误。
例如,日志文件分析可以揭示页面不再存在时发生的 404 错误,这会导致用户和机器人都无法访问该内容。
找出日志文件中存在的任何问题,有助于着手修复。
日志文件分析在 SEO 中有什么用?
日志文件分析能揭示机器人抓取网站的方式,可据此改善网站的可抓取性——并最终提升 SEO 表现。
例如,日志文件分析有助于:
- 发现搜索引擎机器人抓取最多和最少的页面
- 查明搜索爬虫能否访问最重要的页面
- 看看是否存在浪费抓取预算的低价值页面(即搜索引擎在转向别处之前会花在抓取上的时间和资源)
- 检测诸如HTTP 状态码错误(如“error 404 page not found”)和失效重定向等技术问题,它们会阻止搜索引擎(和用户)访问内容
- 发现页面速度缓慢的 URL,这会拖累搜索排名
- 识别搜索引擎可能遗漏的孤立页面(即没有内链指向的页面)
- 追踪抓取频率的骤升或骤降,它们可能预示其他技术问题
- 通过分析 AI 机器人如何与网站互动,为AI SEO 策略提供参考
如果迫切想了解用户在与品牌相关的话题上在 ChatGPT 和 Perplexity 等工具中谈了什么,那么看到 AI 机器人如何与网站互动就尤为重要。
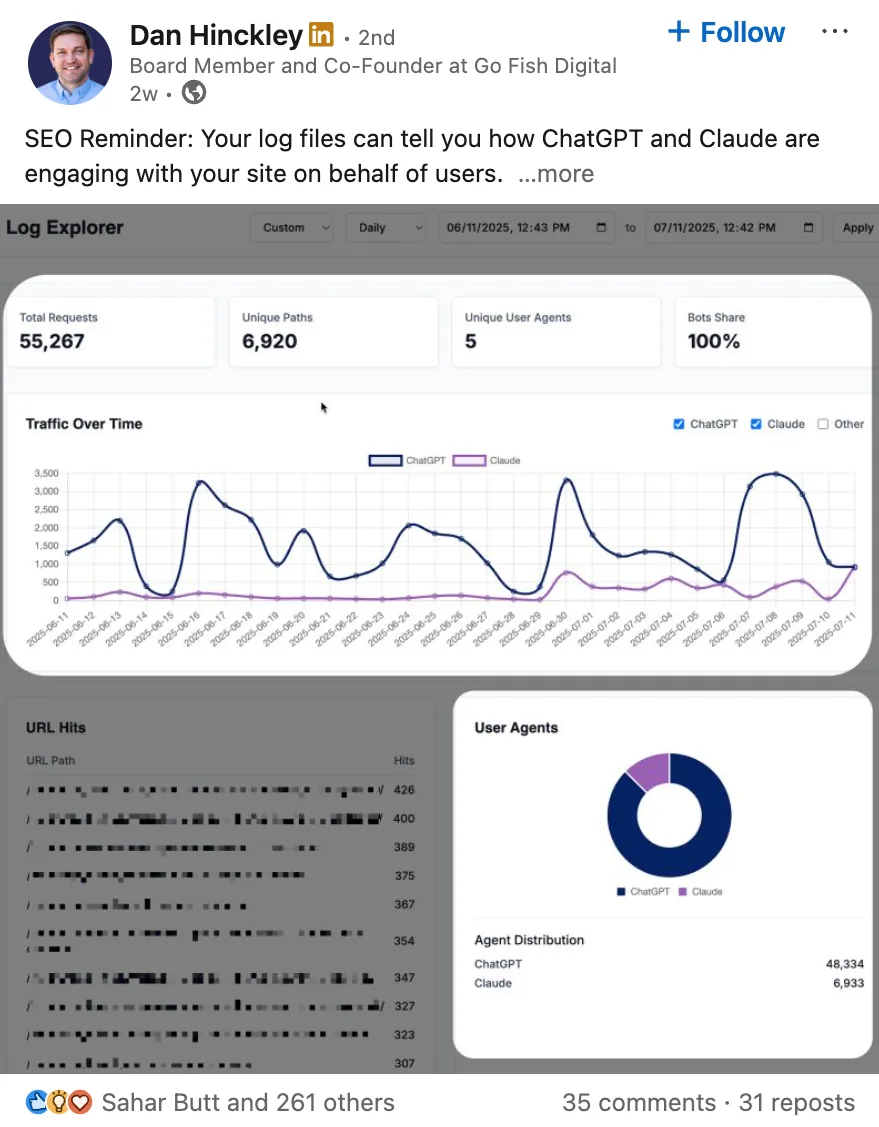
Dan Hinckley,Go Fish Digital 的董事会成员兼联合创始人,在一条 LinkedIn 帖子中很好地解释了这一点:
“日志文件能揭示 ChatGPT 和 Claude 如何代表用户与网站互动。下面的截图显示,在 30 天窗口内,ChatGPT-User 代理访问该网站超过 48,000 次,涉及近 7,000 个唯一 URL。”
此外,做一次日志文件分析还能标记出原本可能被忽略的问题。例如,Comrade Digital Marketing Agency 的 CEO 兼联合创始人 Ivan Vislavskiy 曾为一家中型电商网站做过一次日志文件分析。
该网站的流量在逐渐下滑,尽管没有重大的网站改动,也没有任何明显的错误。于是,Ivan 转向日志文件,看看能否找出流量下滑的原因。
“日志显示,Googlebot 一直在点击与缺货产品变体相关的重定向链和死胡同 URL,而客户的内容管理系统(CMS)并未清晰暴露这一点。这些问题正在消耗抓取预算,并释放出不稳定的信号。”
Ivan 和他的团队实施了正确的规范标签,并清理了遗留的重定向。
他们还使用robots.txt 文件(一个告诉机器人网站哪些部分该抓取、哪些该避免的文件)屏蔽了末尾带有类似“?ref=123”参数的 URL。
“两个月内,抓取效率提高,Googlebot 把重点转向了常青的分类页面。自然流量趋于稳定,随后增长了 15%。”
如何分析日志文件
了解了日志文件分析对 SEO 的价值后,接下来看具体做法。
你需要:
- 网站的服务器日志文件
- 一个日志文件分析工具的访问权限(下文会展示如何用 Semrush 的日志文件分析器(Log File Analyzer)分析 Googlebot)
1. 获取日志文件
从服务器下载日志文件,即可获取网站的日志数据。
一些托管平台(如 Hostinger)内置文件管理器,可从中找到并下载日志文件。
具体操作如下。
在仪表盘或控制面板中,寻找名为“file management”“files”“file manager”或类似名称的文件夹。
该文件夹在 Hostinger 上如下所示:
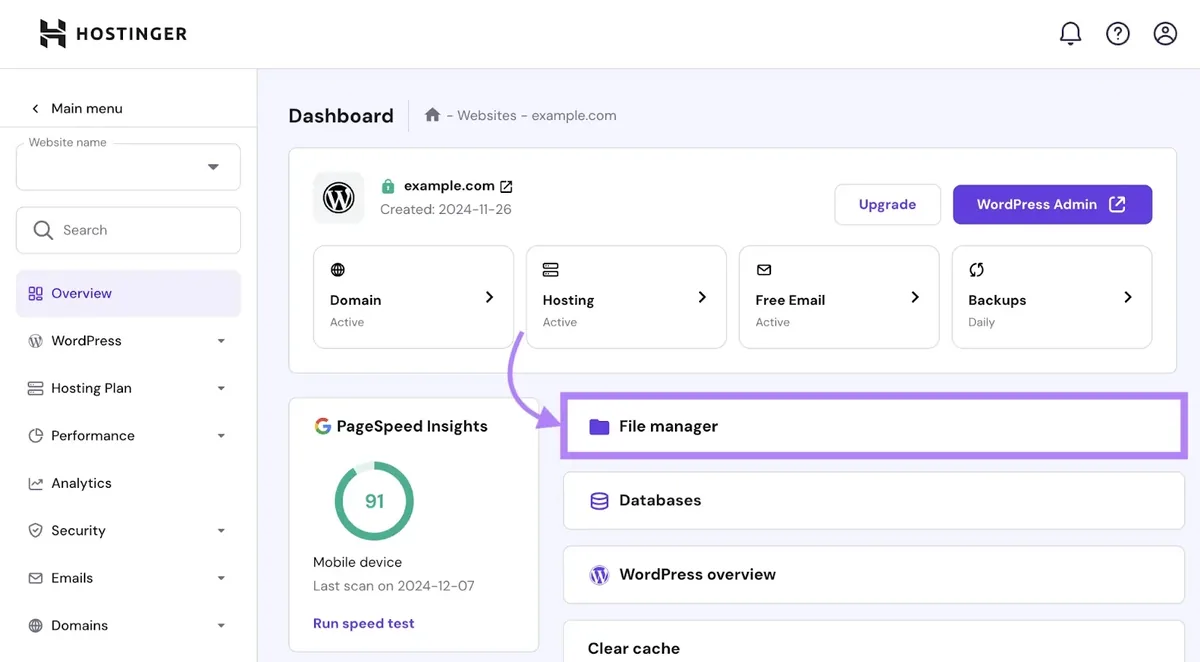
打开该文件夹,找到日志文件(通常在“.logs”文件夹中),下载所需文件即可。从过去 30 天开始的日志文件是不错的起点。
也可以让开发者或 IT 专员访问服务器,通过 FileZilla 之类的文件传输协议(FTP)客户端下载这些文件。
下载好日志文件后,就该分析它们了。
2. 分析日志文件中的爬虫活动
了解 Googlebot 如何抓取网站,有助于看清搜索引擎优先抓取哪些页面,以及潜在问题可能在哪里影响网站在搜索结果(包括AI 概览)中的表现。
要分析日志文件,请确保文件已解压(从文件夹中提取出来),且属于以下格式之一:
- 组合日志格式(Combined Log Format)
- W3C 扩展格式(W3C Extended)
- Amazon Classic 负载均衡器(Amazon Classic Load Balancer)
- Kinsta
然后,把文件拖放到日志文件分析器中,点击“Start Log File Analyzer”。
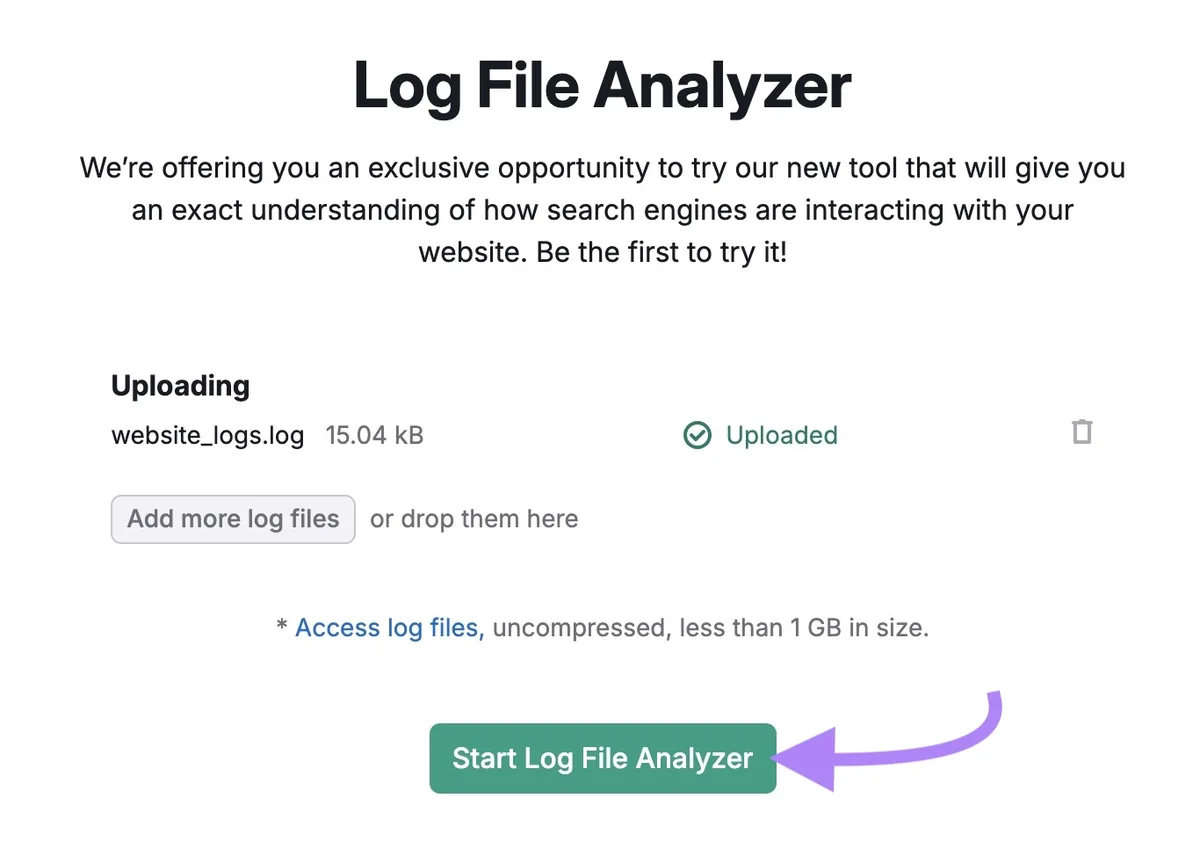
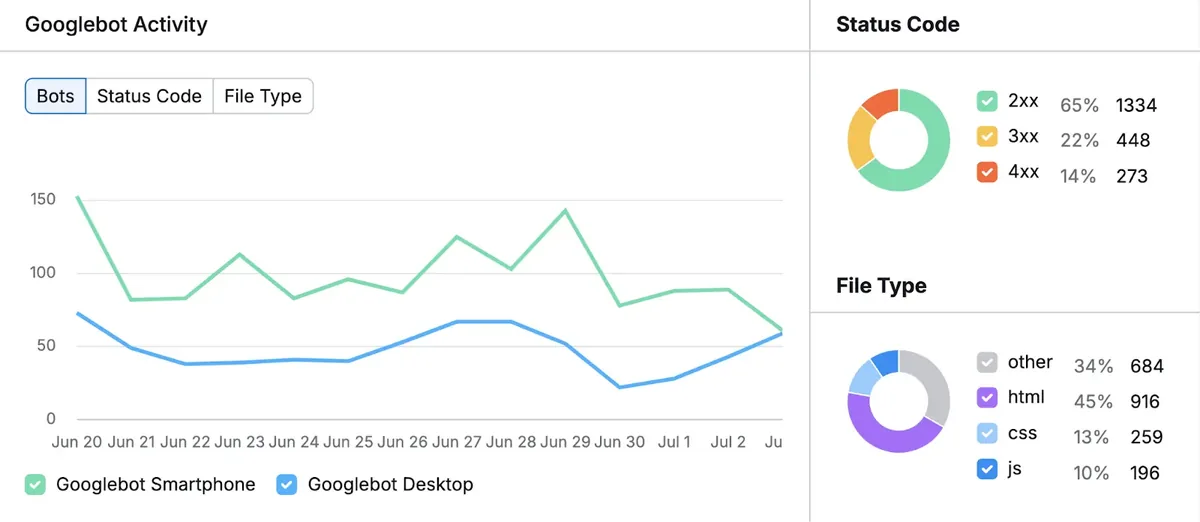
结果准备好后,会看到一张展示 Googlebot 过去 30 天活动的图表。
监控这张图表,找出活动中任何异常的骤升或骤降。它们可能表明搜索引擎抓取网站的方式发生了变化,或凸显出需要修复的问题。
在图表右侧,还会看到以下内容的细分:
- HTTP 状态码:这些代码显示搜索引擎和用户能否成功访问网站页面。例如,过多的 4xx 错误可能表明存在失效链接或缺失页面,应当修复。
- 抓取的文件类型:了解搜索引擎机器人抓取不同文件类型所花的时间,能显示搜索引擎与内容的互动方式。这有助于判断它们是否在不必要的资源(如 JavaScript)上花了太多时间,而没有优先处理重要内容(如 HTML)。
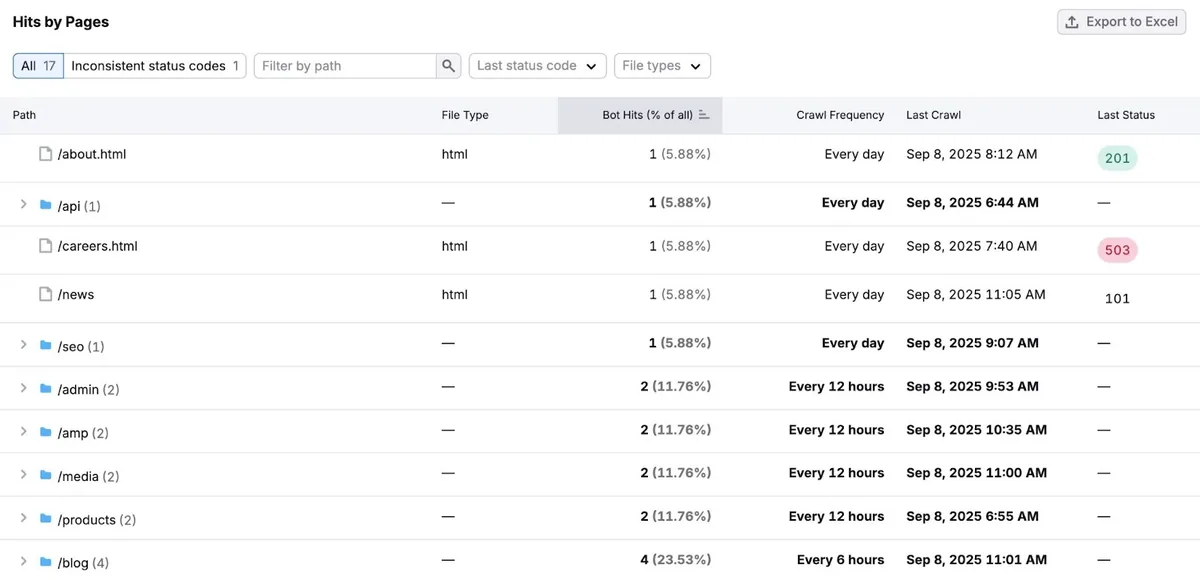
向下滚动到“按页面统计的抓取次数(Hits by Pages)”,可获取更具体的洞察。这份报告会显示:
- 搜索引擎机器人最常抓取哪些页面和文件夹
- 搜索引擎机器人抓取这些页面的频率
- 404 之类的 HTTP 错误
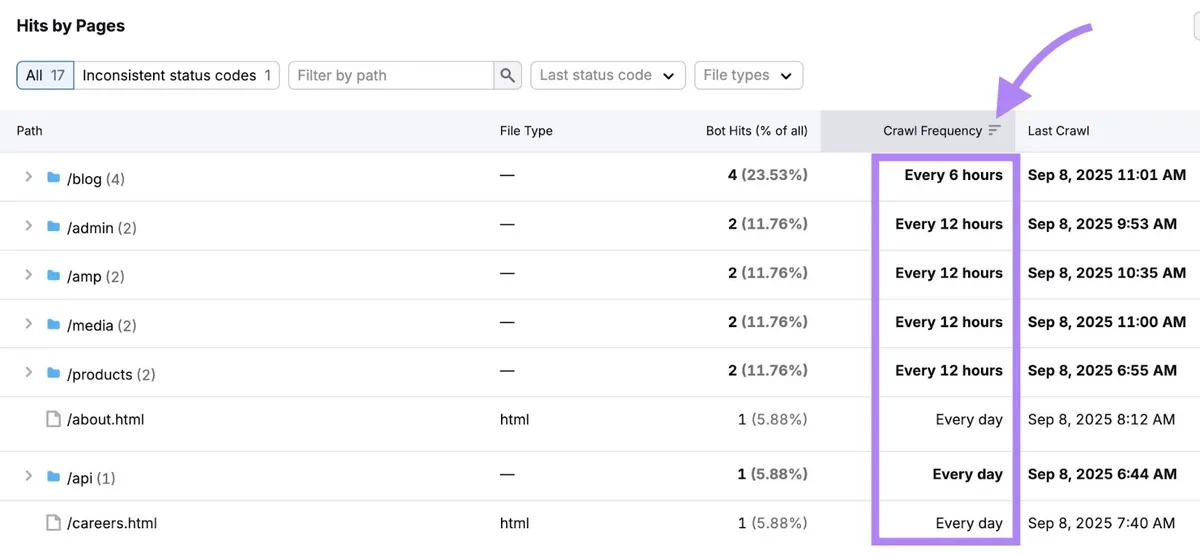
按“抓取频率(Crawl Frequency)”对表格排序,看看 Google 如何分配抓取预算。
也可以点击“状态码不一致(Inconsistent status codes)”按钮,查看状态码不一致的 URL 路径。
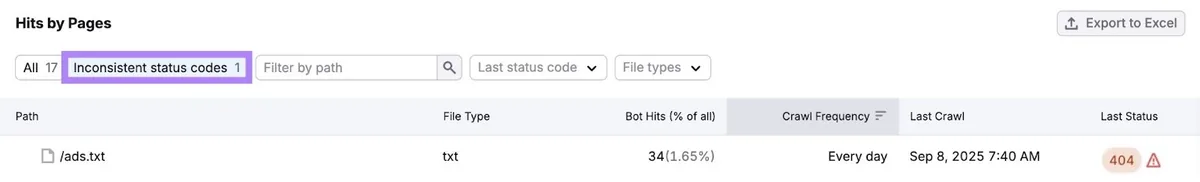
例如,某个路径在 404 状态码(表示页面无法找到)和 301 状态码(永久重定向)之间来回切换,可能表明重定向配置有误。
要特别关注最重要的页面,并利用获得的洞察做出调整,从而改善搜索结果中的表现。
如何阻止 Googlebot 抓取无关资源
优化 Googlebot 抓取哪些资源,有助于最大限度利用抓取预算,确保关键内容得到更多关注。你无法完全控制 Googlebot 把时间花在哪里——但可以影响它。
例如,与其让 Googlebot 把时间花在空白的分类页面上,可以屏蔽这类页面,让它专注于最有价值、最相关的内容。
可尝试通过以下方式阻止 Googlebot 抓取无关页面:
- 在 robots.txt 中添加一条规则,阻止抓取不必要的页面
- 使用规范标签(一行代码,用于指明网页的主要版本)告诉 Google 哪个页面版本是主版本,防止 Googlebot 抓取重复页面
- 删除或更新低价值内容,确保 Googlebot 专注于最重要的页面
优先保证网站的可抓取性
主动采取措施确保网站为可抓取性做好优化,能帮助网站出现在用户查询的答案中,无论是在传统搜索结果、AI 概览还是聊天机器人回答里。
先从我们的免费网站审计入手,快速标记可抓取性信号。要对每个页面做完整的技术 SEO 审计,请使用 Semrush 网站审计。
打开该工具,按我们的配置指南完成设置。(或沿用默认设置。)
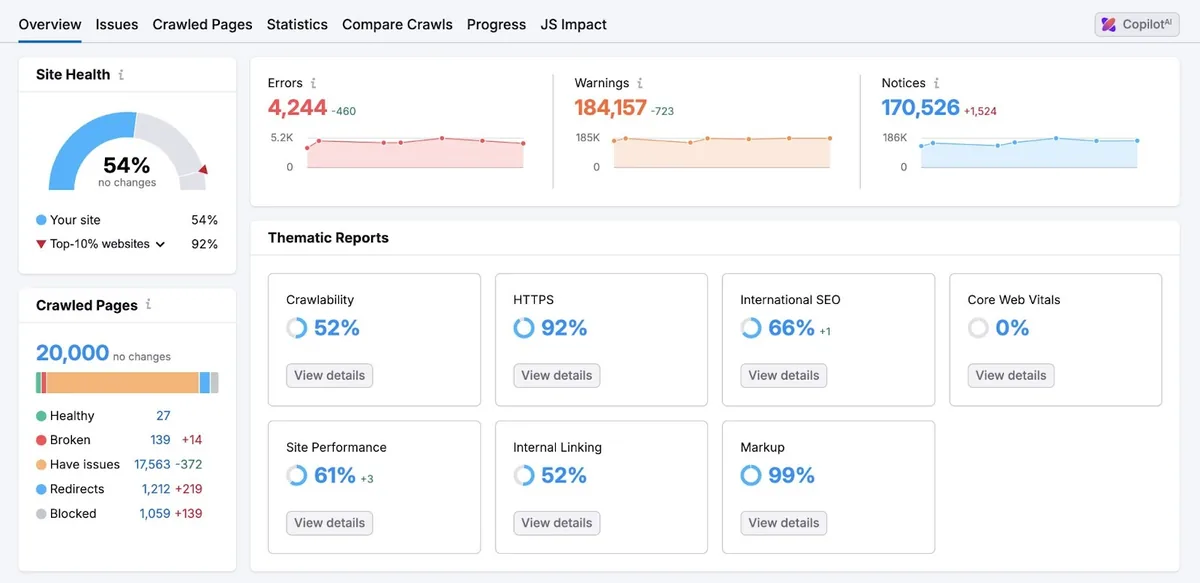
报告准备好后,会看到一个概览页面,突出显示网站最重要的技术 SEO 问题和改进方向。
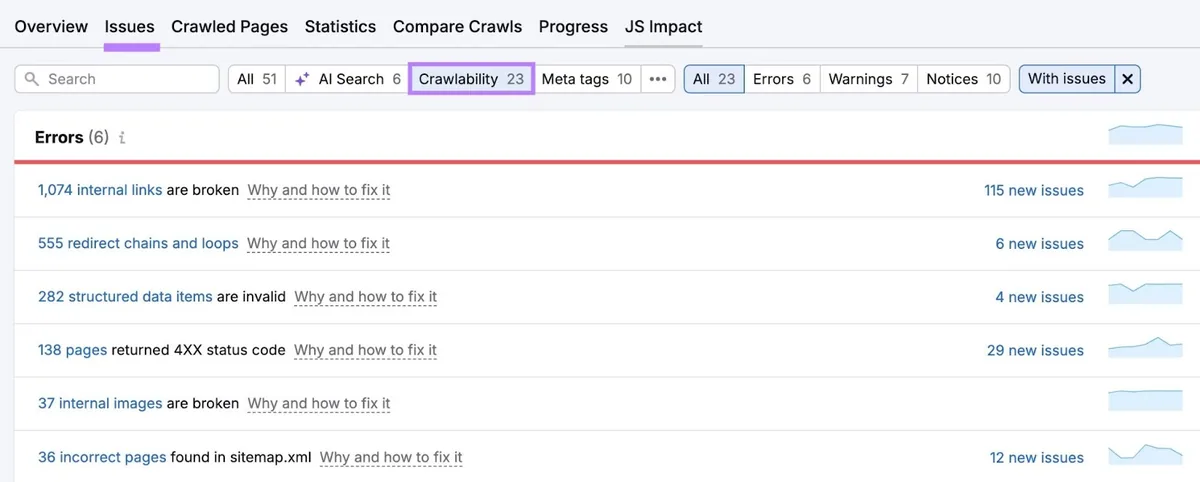
转到“问题(Issues)”标签页并选择“可抓取性(Crawlability)”,查看影响网站可抓取性的问题。这里的许多潜在问题都可以通过日志文件分析发现。
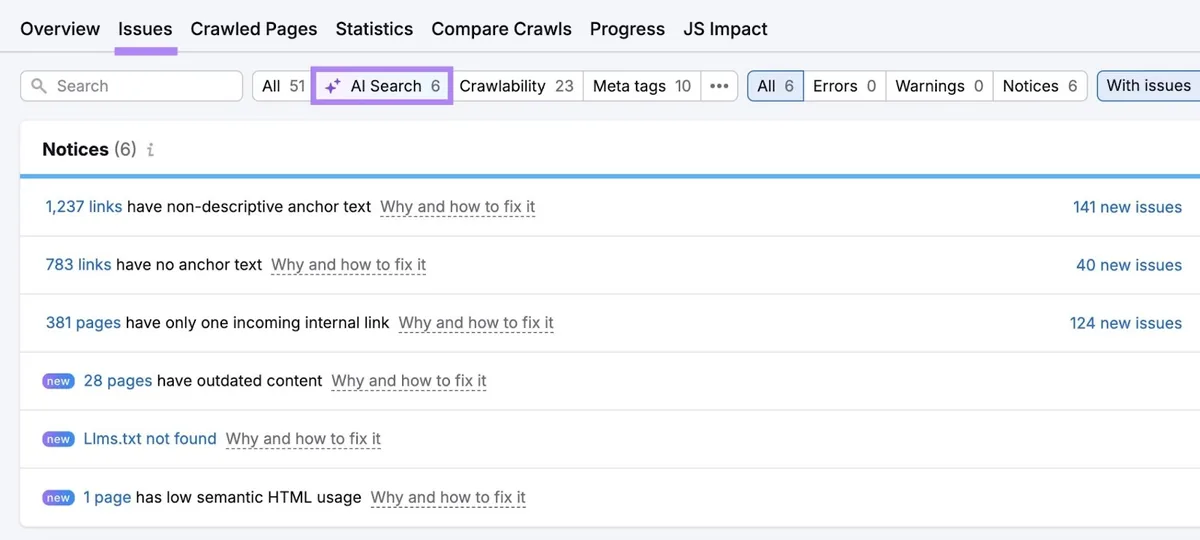
然后,选择“AI 搜索(AI Search)”,查看可能妨碍网站在 AI 概览中排名的问题。
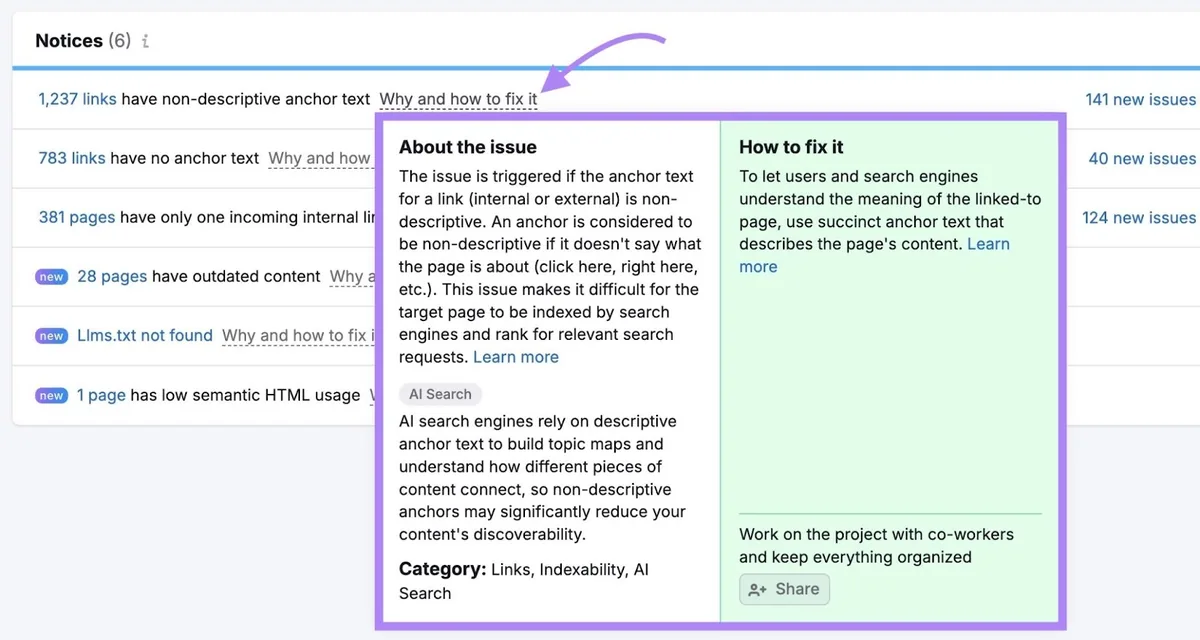
如果不清楚某个问题的含义或如何解决,点击“修复原因与修复方法(Why and how to fix it)”了解更多。
像这样每月运行一次网站审计,并解决出现的任何问题,可自行处理,也可与开发者协作。
优化的同时,持续关注日志文件,看看修复可抓取性问题如何影响 Googlebot 抓取网站的方式。
免费试用 Semrush,使用网站审计等工具来优化网站的可抓取性。