答案引擎是如何工作的
答案引擎(AI 搜索引擎)是使用大语言模型(LLM)查找信息并生成回答的问答系统。要让自己的内容出现在这类答案中,先要理解驱动 AI 搜索引擎运转的几个核心过程。
当你让 ChatGPT 推荐最适合健身时佩戴的头戴式耳机时,实际发生了什么?
AI 答案引擎如何生成回答、如何挑选产品推荐?它们与 Google 这类传统搜索引擎有何不同,又在哪些地方重叠?
最关键的是,怎样才能让自己的网站、品牌和产品出现在其中?
什么是答案引擎?
答案引擎(或称 AI 搜索引擎)是使用大语言模型(LLM)查找信息并生成回答的问答系统。
传统搜索引擎与答案引擎之间存在一些关键差异(不过随着传统搜索引擎融入更多 AI 功能,这些差异正在缩小):
- 用户不再只输入一次性查询,而是可以继续追问,让对话持续下去。
- AI 搜索引擎不再返回一份带排名的链接列表,而是提供直接答案和推荐(而且这些答案会经常变化)。
- 用户不再被引导去访问你的网站,而是直接在聊天界面里得到问题的答案(这导致回流到网站的点击减少)。
以下是典型的 AI 搜索界面,与在 ChatGPT、Claude 或 AI Mode 中看到的类似:
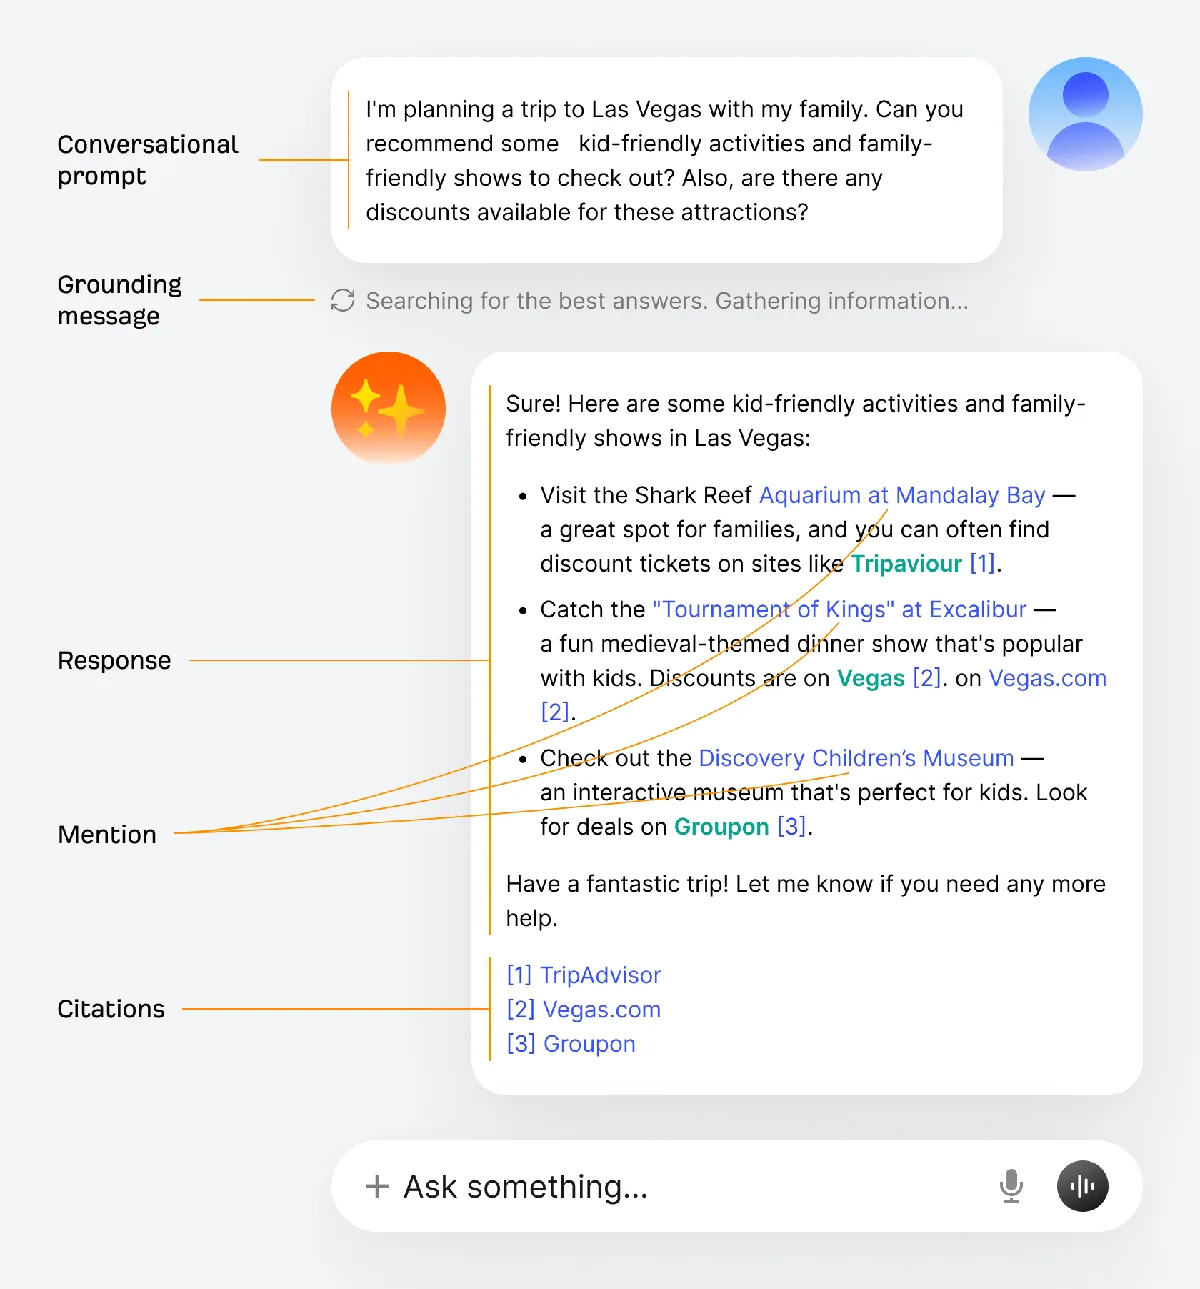
- 对话式提示词:用户的问题。
- 检索提示信息:一条表明 LLM 已决定去搜索额外信息用于回答的消息。
- 回答:AI 针对用户提示生成的内容。
- 提及:在回答文本中被顺带提到的实体(比如你的品牌或产品)。
- 引用来源:回答生成过程中用到的来源网址,通常列在最后。
要帮助自己出现在这样的答案中,先要理解驱动 AI 搜索引擎运转的几个核心过程。
训练是如何进行的
LLM 在海量内容上训练而成,实际上已经“读过”整个维基百科、整个 Common Crawl 数据集、整个 Google Books,以及数以百万计的网页内容。
这些训练数据为 LLM 提供了对世界的“理解”。如果你的耳机公司在其训练数据中多次出现,且出现在相关的语境中、并伴随正面描述(“性价比最高”“健身必备”等),那么你公司在 LLM 回答耳机相关提示时被提到,就有很大机会。
你知道吗?
预训练(pre-training)
后训练(post-training)
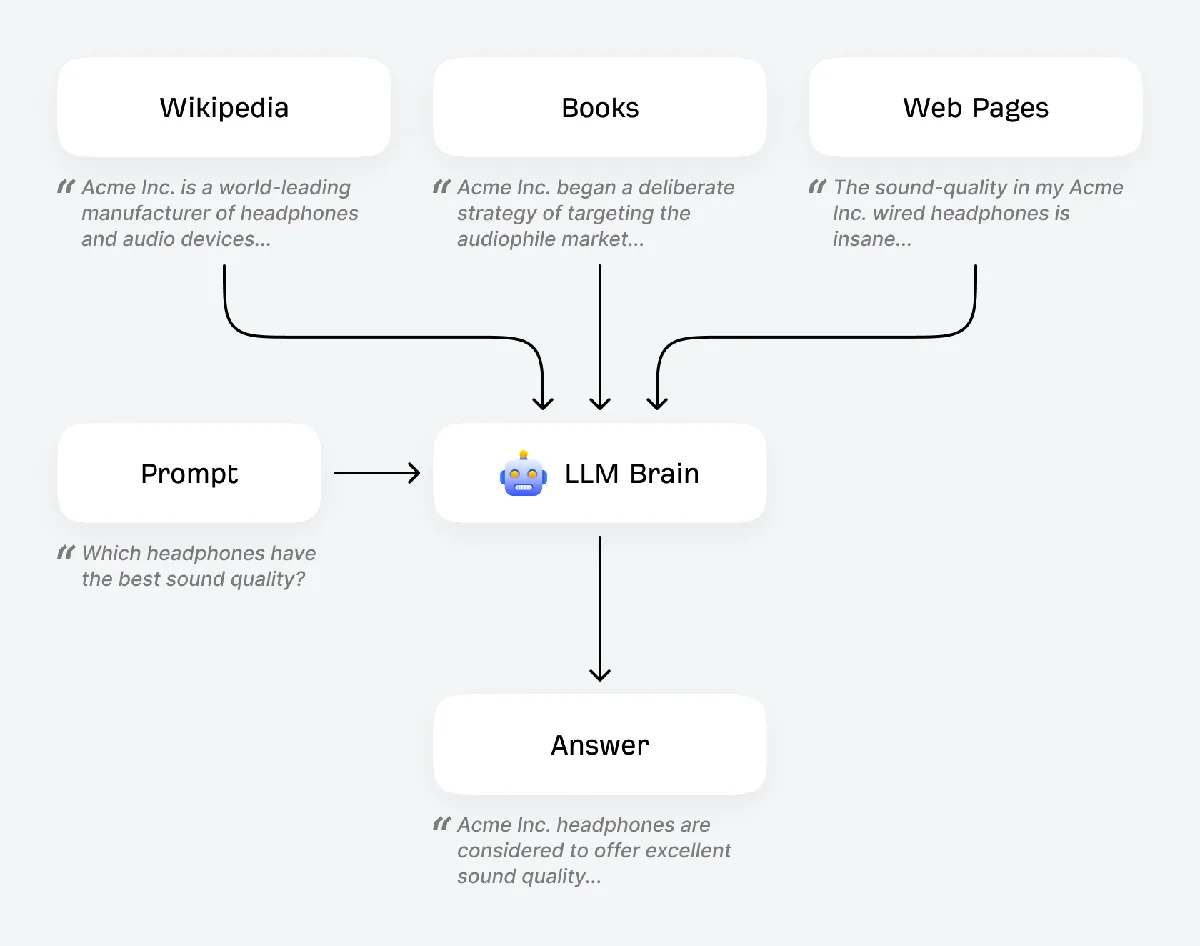

这正是基于实体的 SEO(entity-based SEO)变得至关重要的地方。如果你的品牌持续出现在知识图谱中、通过 schema 标记得到正确结构化,并与网络高质量内容中的相关实体共同出现,那么你就能在训练数据中建立起更强的“实体信号”。
Gianluca Fiorelli,战略与国际 SEO/AI 搜索顾问
关键在于,LLM 有许多独特之处:
- 它们具有概率性:使用同样的提示词,每次得到的回答都可能不同。这种概率特性意味着你无法像针对某个关键词那样去“针对某个提示词做优化”。相反,你应该从分布的角度思考:在 100 个相似提示词中,你的品牌出现的概率有多大?这就是为什么追踪大量提示词下的平均可见度,比死盯少数几个提示词要好。
- 它们的知识有截止日期:默认情况下,LLM 的知识仅限于该特定模型训练时数据集所包含的内容。每个模型都只在截至某一日期的数据快照上训练一次。拥有更新知识截止日期的新模型会定期发布(从历史来看大约每半年一次)。
- 它们会产生幻觉:它们会自信地陈述并不真实的事情。LLM 通过预测接下来最可能出现的词来生成文本,而不是去核实事实。虽然它们被训练得要既有用又准确,但它们并没有内置的事实核查机制,这就是为什么通过网络搜索进行 grounding(接地)如此重要。
一个常见的误解是,LLM 会像软件打补丁那样获得“知识更新”。事实上,每个模型都只在一个固定的数据集上训练一次。当你看到一个新模型发布、其知识截止日期更新时,那是一个从零开始训练的、全新的模型,而不是对现有模型的更新。
Gianluca Fiorelli,战略与国际 SEO/AI 搜索顾问
一个会产生幻觉、还分享过时信息的搜索引擎并不太有用。正因如此,LLM 会通过一个被称为 grounding(接地) 的过程克服其中一些局限。
Grounding 与 RAG 是如何运作的
LLM 可以通过两种方式核实并改进自己的回答:使用工具(如计算器或其他数据 API),或从外部来源检索额外信息。第二种过程在技术上称为 检索增强生成(Retrieval-Augmented Generation,RAG)。
当用户输入一个问题时,LLM 会问自己:“我已经知道答案了吗,还是应该去获取额外信息?”如果 LLM 能以很高的确定性预测下一个词(例如“红细胞有什么作用?”这类变化不大的问题),它很可能直接从基础知识作答。如果确定性很低(对于像“最好的平价咖啡磨豆机是什么?”这类更容易变化的问题),它就可以使用搜索工具,从互联网上的其他来源查找相关信息。
LLM 经过微调,能够识别出那些可能受益于额外信息的查询类型,例如:
- 超出模型训练范围的话题:“Ahrefs Keywords Explorer 使用的内部排名因素有哪些?”
- 需要最新或时效性信息的话题:“Google 最近一次核心更新是什么,什么时候推出的?”
- 明确要求进行网络搜索的话题:“上网搜索 2026 年流行的链接建设手法。”
- 要求提供来源和证据的提示词:“提供来源,证明 Google 在算法中使用了用户互动信号。”
某些 LLM 模型也很容易被触发进行额外搜索(例如“深度研究”模型被专门配置为触发多次 RAG 搜索)。
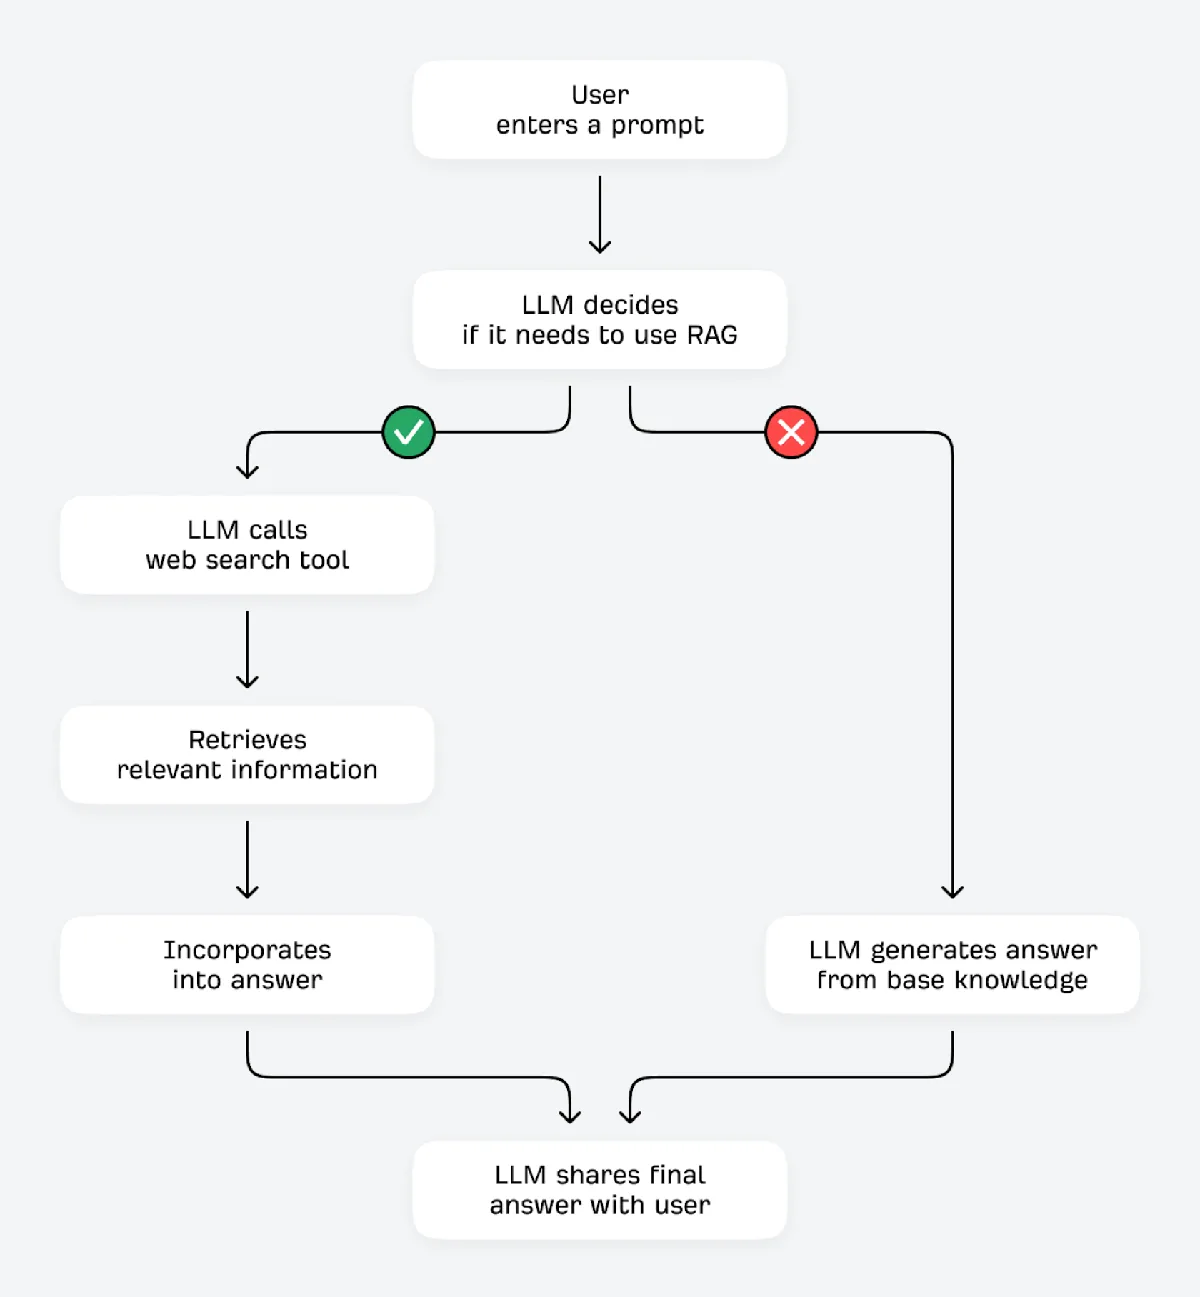
通过 RAG 寻找事实依据(通常被称作“grounding”)的这一过程带来若干好处。LLM 可以通过把回答与第三方来源核对,提高事实准确度、减少幻觉。即便它的训练数据相对过时,它也能检索并分享最新信息。它能分享更详细、更全面的回答,并为所分享的一切提供更好的透明度和出处说明。
AI 搜索引擎通过一个被称为查询扇出(query fan-out)的过程来完成这种 grounding。