X-Robots-Tag 是什么?
X-Robots-Tag 是网络服务器发送的一种 HTTP 响应头,包含面向 Googlebot 等网络爬虫的指令。
什么是 X-Robots-Tag?
X-Robots-Tag 是某个 URL 的 HTTP 响应头中的一个可选组成部分。与 meta robots 标签相似,它告知搜索引擎如何抓取和索引某个网页。
不过,两者之间有一些关键区别:
与仅用于 HTML 页面的 robots meta 标签不同,X-Robots-Tag 用于 HTTP 协议响应头中,因此也可用于非 HTML 文件,例如图片、文本文件和 PDF 文档。
带有 X-Robots-Tag 的 HTTP 响应可能长这样:
HTTP/1.1 200 OK

Date: Tue, 15 Nov 2022 11:38:17 GMT

Content-encoding: gzip

(…)

X-Robots-Tag: noindex

(…)
X-Robots-Tag 可以指定一个用户代理(爬虫),并可使用逗号分隔的指令列表。
示例:
HTTP/1.1 200 OK

Date: Tue, 15 Nov 2022 11:38:17 GMT

Content-encoding: gzip

(…)

X-Robots-Tag: googlebot: noarchive, nofollow

(…)
Google 在 2007 年首次宣布支持 X-Robots-Tag 指令,并明确表示任何可用作 robots meta 标签的指令,也可以用作 X-Robots-Tag。
X-Robots-Tag 为什么重要?
X-Robots-Tag 之所以重要,是因为它支持正则表达式、能对非 HTML 文件执行爬虫指令,并能在全局、站点范围内应用参数。因此,与meta robots 标签相比,它是一个更灵活的选择。
值得一提的是,使用 X-Robots-Tag 通常不如使用 meta robots 标签那么直接;但由于它允许你指示搜索引擎如何索引和抓取其他文件类型,某些情况下使用 X-Robots-Tag 更合理。
这里有一个示例:
指示 Google 爬虫不要抓取或索引页面内容最常见的方式,是使用 HTML 代码中的 meta robots 标签。但当需要指示 Google 不要索引特定的文本文档和其他非 HTML 文件时,X-Robots-Tag 是唯一的选择。
本质上,在以下情况下,X-Robots-Tag 是更好的选择:
- 希望使用适用于非 HTML 文件(包括 PDF 文件和图片)的特定指令
- 希望规模化使用指令,并让整个子域名或匹配某个参数的多个网页取消索引
X-Robots-Tag 中可以使用哪些指令?
正如 Google 的规范中所述,任何在 robots meta 标签中使用的指令,都可以用作 X-Robots-Tag。
Google 认可并可用于 X-Robots-Tag 的完整有效索引和/或展示指令列表相当长,但最常用的是:
- noindex - 加入这条指令,即指示搜索引擎不要在搜索结果页面中显示该页面、文件或媒体。
- nofollow - 加入这条指令,即指示搜索引擎爬虫不要跟踪页面或文档中出现的链接。
- none - 这条指令相当于“noindex, nofollow”。
- noarchive - 加入这条指令,即指示搜索引擎不要在搜索结果中显示该页面的缓存版本。
- nosnippet - 加入这条指令,即指示搜索引擎不要在搜索结果中显示该页面的摘要或预览。
可以在这里找到 Google 接受的完整指令列表。
如何设置 X-Robots-Tag?
可以使用网站服务器的配置文件,把 X-Robots-Tag 加入网站的 HTTP 响应中。
在 Apache 上,可以通过 .htaccess 文件或 httpd.conf 文件来设置;在 NGINX 上,可以在站点的 .conf 文件中设置。
此外,可以把多条 X-Robots-Tag 指令组合成一个逗号分隔的列表。下面是一个指令组合的示例,它会指示 Googlebot 不要索引扩展名为“.pdf”的 URL,也不要跟踪其中的任何链接:
<Files ~ "\.pdf$">

  Header set X-Robots-Tag "noindex, nofollow"

</Files>
把上面所示的代码片段添加到网站根目录,意味着该指令适用于网站上所有 PDF 文件。
在 HTTP 响应中使用 X-Robots-Tag 时,还可以通过指定爬虫名称,为不同的爬虫指定不同的指令。
如果没有指定机器人(爬虫)名称,该指令默认适用于所有爬虫。而当指定了某个特定的机器人(本例中是 Googlebot),命令会是这样:
Header set X-Robots-Tag "googlebot: noindex, nofollow"
使用 X-Robots-Tag 时,有一件至关重要的事要记住:
Googlebot,或任何其他“善意”的网络爬虫,只有在能够访问该 URL 时,才能读取到 X-Robots-Tag。如果通过 robots.txt 文件禁止了对某个特定 URL 的抓取,那么这些索引和/或展示指令就会被忽略。
在哪里能找到 X-Robots-Tag?
与 robots meta 标签不同,X-Robots-Tag 无法在某个页面的 HTML 代码中找到。它是 HTTP 响应头中的一个元素,因此在浏览器中查看它可能更麻烦一些。
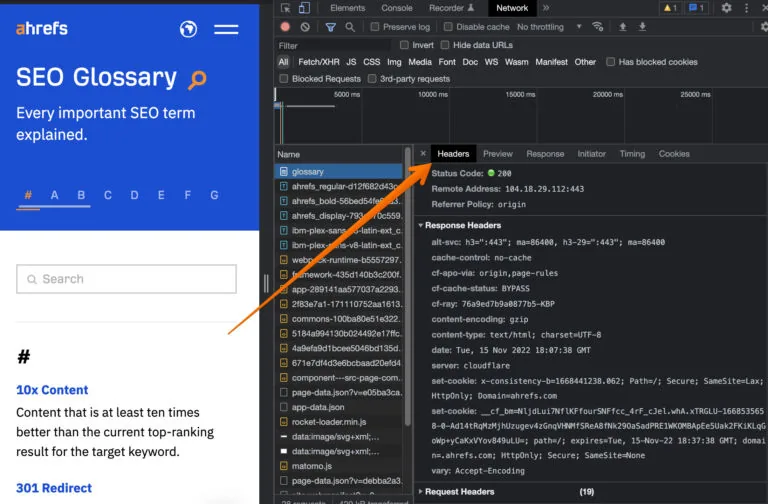
以下是在 Google Chrome 中查看 HTTP 响应头的方法:
- 在 Google Chrome 中加载目标 URL,右键点击页面,选择“检查”以打开开发者工具。
- 选择“网络”(Network)标签。
- 重新加载页面,然后选择面板左侧显示的相应文件,HTTP 头信息就会显示在面板右侧。
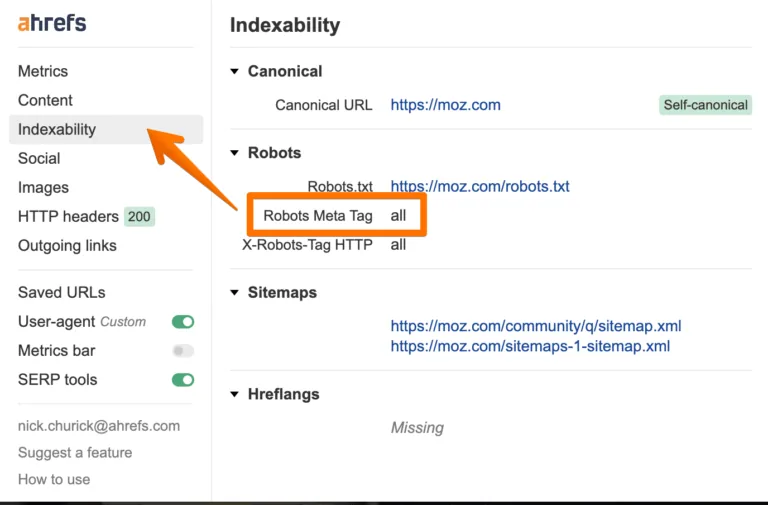
我们的 SEO 工具栏是一款适用于 Chrome 和 Firefox 的免费浏览器扩展,能简化这一过程。如果存在,某个 URL 的 X-Robots-Tag 会显示在“Indexability”(可索引性)部分。