什么是 Meta Robots 标签?
Meta robots 标签是一种 HTML 代码片段,用于告知搜索引擎如何抓取和索引某个页面。
什么是 Meta Robots 标签?
Meta robots 标签是一种 HTML 标签,用于向搜索引擎爬虫提供关于如何索引、抓取和展示某个页面的指令。它被放置在网页的 <head> 部分。
它在代码中是这样的:
<meta name="robots" content="noindex, nofollow">
Meta robots 标签主要用于控制页面的索引和抓取,并且在该页面的 HTML 代码中可见。对于缺少 HTML head 部分的页面,或图像、PDF 等资源,可以改用 X-Robots 标签。
与 meta robots 标签不同,X-Robots 标签是一种随网页响应一起发送的 HTTP 头。
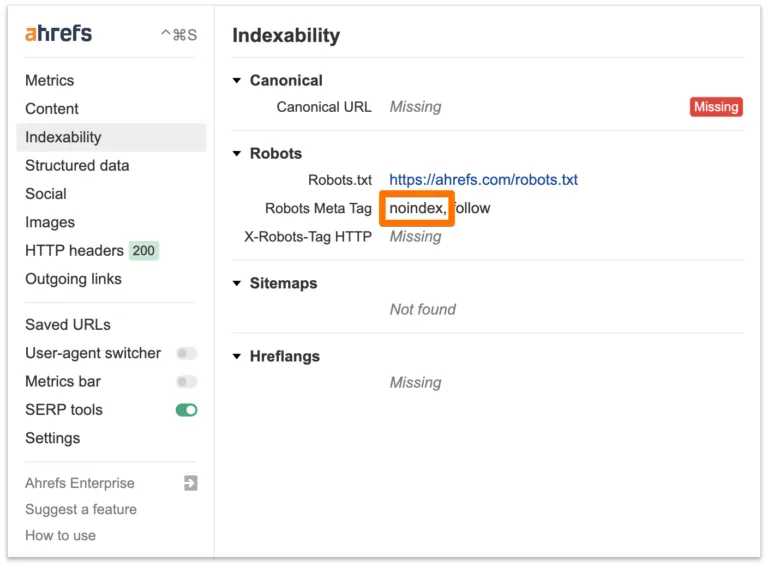
验证某个页面 Meta Robots 标签最简单的方法,是使用 Ahrefs SEO Toolbar 浏览器扩展。其中“可索引性”部分会基于 Meta 标签和 HTTP 头两方面,给出面向爬虫的指令。
需要注意的是,搜索引擎爬虫只能对那些依据 robots.txt 文件规则允许被抓取的页面,执行 Meta Robots 标签中指定的指令。
如果不希望某个页面出现在搜索结果中,那么确保该特定页面允许被抓取就至关重要,这样搜索引擎才能读取到 noindex 指令。
除了控制页面索引和抓取,meta robots 标签还有一些鲜为人知的用途,包括指示搜索引擎不要在搜索结果中显示页面的文字片段或视频预览,或不要存储页面的缓存版本。
为什么 meta robots 标签很重要?
站长可能希望阻止某些页面出现在搜索引擎中,例如内容单薄的页面、PPC 落地页,或管理页面和“感谢”页面。Meta robots 标签通过“noindex”指令,为站长提供了实现这一目标最可靠的方式。
此外,meta robots 标签中的 “nofollow”属性会让页面上的所有链接对 Googlebot 等搜索引擎爬虫而言都变成“nofollow”。
它也可以用来控制单个页面被索引和呈现给用户的方式。例如,站长可以使用“nosnippet”指令,阻止搜索引擎在搜索结果中显示来自该页面的文字片段。
meta robots 标签中可以使用哪些规则?
有几条规则(或指令)可以与 meta robots 标签一起使用:
- noindex - 指示搜索引擎不要索引该页面。这会阻止该页面出现在搜索结果中。
- nofollow - 指示搜索引擎不要跟踪页面上的任何链接。
- none - 等同于使用 noindex 或 nofollow。
- all - 等同于 index, follow。无需使用该指令。
- noarchive - 阻止搜索引擎显示该页面的缓存版本。
- nositelinkssearchbox - 阻止 Google 在搜索结果中显示站点链接搜索框。
- nosnippet - 指示搜索引擎不要在搜索结果中显示来自该网页的文字片段。
- indexifembedded - 这会指示 Google 对通过 iframe 或类似 HTML 标签嵌入到带有 noindex 指令页面中的内容建立索引。
- max-snippet - 指定 Google 可以在其文字片段中显示的最大字符数。
- max-image-preview - 告知搜索引擎它们可以用于图片片段的最大图片尺寸以及方式。
- max-video-preview - 设置搜索结果中视频片段的最大秒数。
- notranslate - 该指令指示 Google 不要为该网页提供翻译。
- noimageindex - 告知 Google 不要对网页上的图片建立索引。
- unavailable_after - 指示 Google 在指定日期/时间之后不要在搜索结果中显示该网页。
有关不同规则的更多信息,请访问 Google 关于 robots meta 标签的文档。
如何设置 meta robots 标签?
在 WordPress 中,借助 Yoast 和 RankMath 等流行的 SEO 插件,实施 meta robots 标签相当容易。具体做法如下:
使用 Yoast SEO 插件:
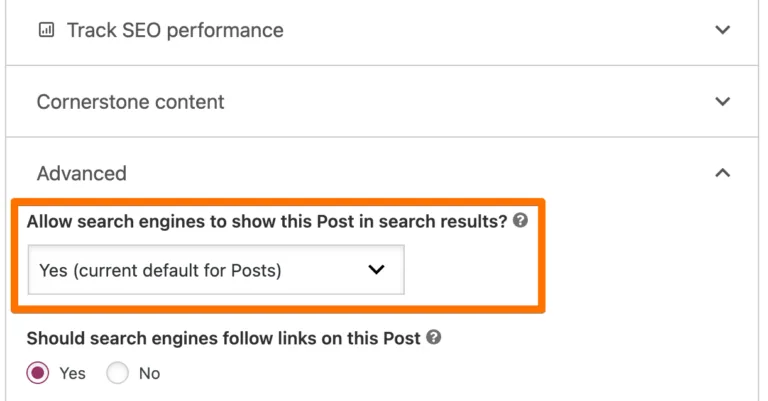
前往文章或页面编辑区块下方的 Advanced(高级)区域。
下拉菜单“Allow search engines to show this Post in search results?”(允许搜索引擎在搜索结果中显示这篇文章吗?)控制页面上的“noindex”属性。
使用 RankMath 插件:
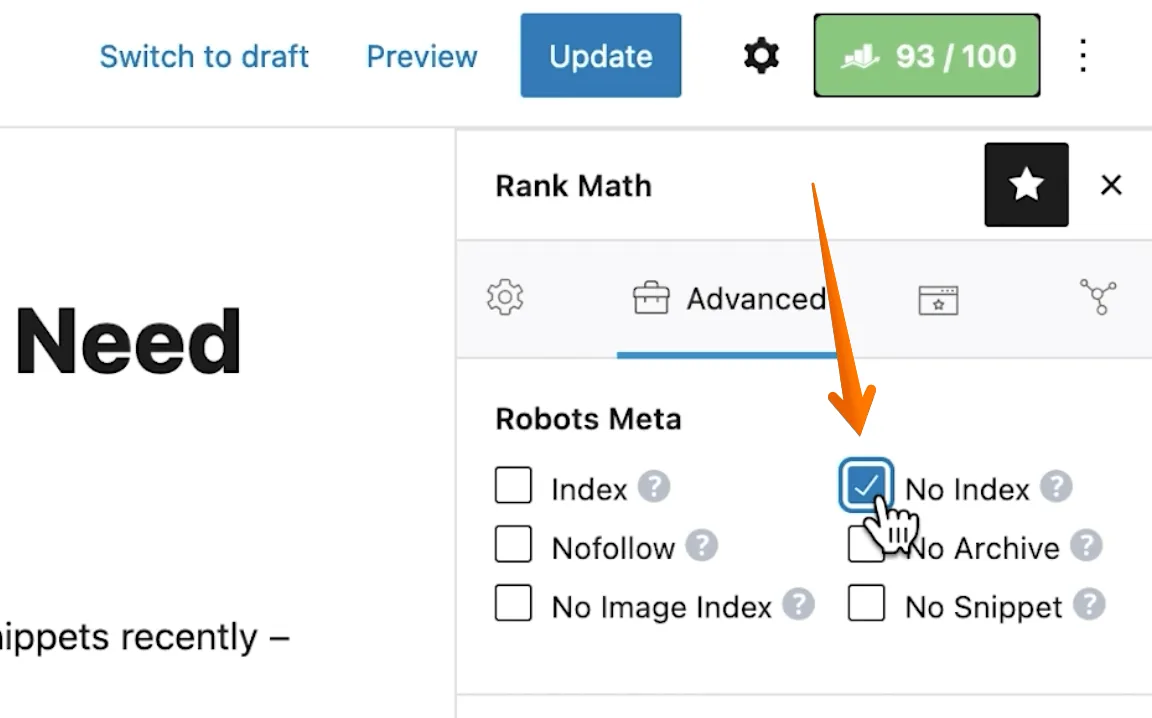
用 RankMath 插件对页面设置 noindex 也类似。打开 Advanced(高级)选项卡,选择 No Index 选项。