关键词蚕食:如何发现、修复并预防它
当网站上的多个页面瞄准同一关键词时,就会出现关键词蚕食,进而影响排名和在 AI 系统中的可见性。本文介绍识别与修复方法。
关键词蚕食是一个常见问题,会影响你的搜索引擎排名和在 AI 系统中的可见性。
当你自己网站上的页面相互竞争时,就会发生这种情况,而且它比大多数网站所有者意识到的更为普遍。
今天,我们将帮助你了解什么是关键词蚕食、如何识别被蚕食的关键词,和如何修复蚕食,以免它损害你的网站在搜索引擎和 LLM 中的表现。
什么是关键词蚕食?
关键词蚕食发生在一个网站上的多个页面对相同的关键词,并相互损害搜索可见性时。
搜索引擎可能只挑其中一个页面来排名。而如果你首选的页面没有获得排名,它就可能错失反向链接(来自其他网站的链接),进而削弱其权威性。
关键词蚕食也可能影响 AI 搜索。由于 ChatGPT 在一条回复中会引用每个域名下的 1.26 个页面,重叠或高度相似的页面可能会竞争被选中。这让清晰地区分内容、以确保最相关的页面易于被检索变得更加重要。
然而,多个页面对同一关键词获得排名并不总会导致蚕食。
多个页面常常会对宽泛的主题类别获得排名,比如 Figma 对“ui/ux design”一词就有多个页面获得排名。
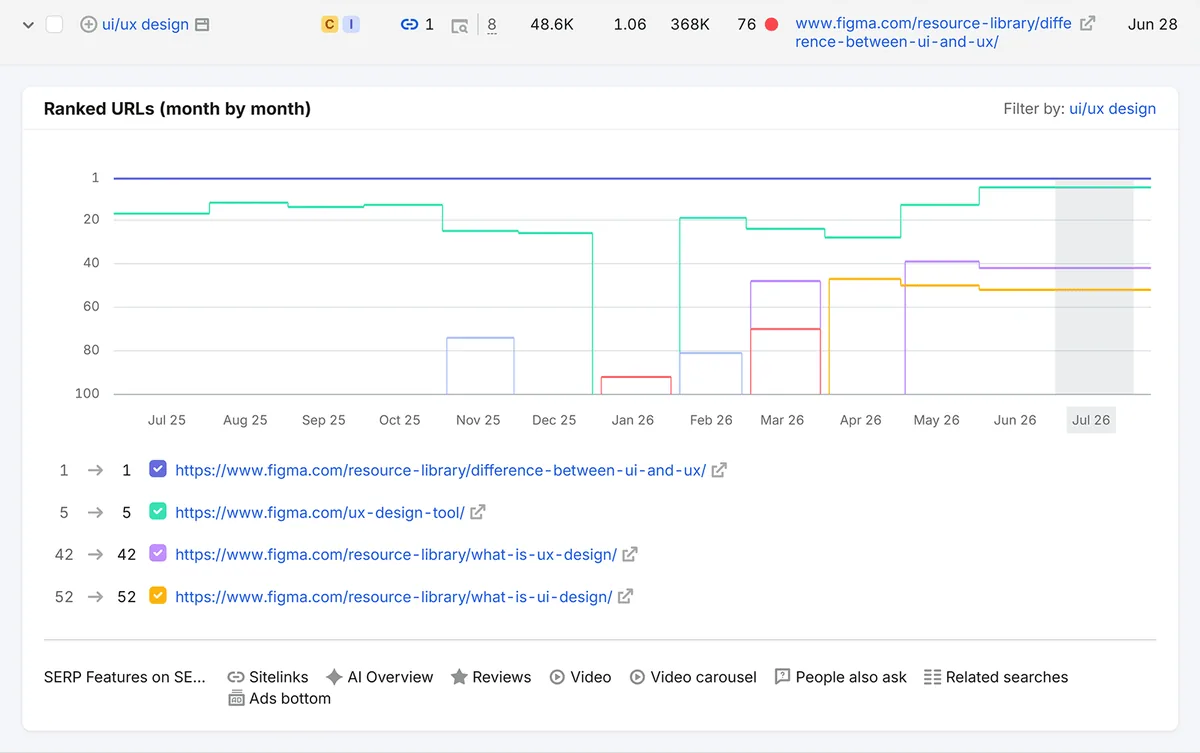
此外,对包含你品牌名称的关键词,同一关键词获得多个高排名是很常见的。因此,只要每个页面都满足用户的搜索意图,你通常不必担心大多数品牌词的关键词蚕食问题。
如何发现被蚕食的关键词
使用以下四种方法,通过查找你网站上对相同关键词的页面来发现被蚕食的关键词:
使用 Semrush 的 Position Tracking 工具
Semrush 的 Position Tracking 工具会监控你的 Google 排名,以识别可能的关键词蚕食情况。
首先,为你的网站配置 Position Tracking 工具。配置完成后,前往“Cannibalization(蚕食)”标签页,查看以下数量:
- 受影响的关键词(Affected keywords):在前 100 名结果中有不止一个页面获得排名的关键词
- 蚕食页面(Cannibal pages):与至少另一个 URL 共享同一关键词排名的 URL
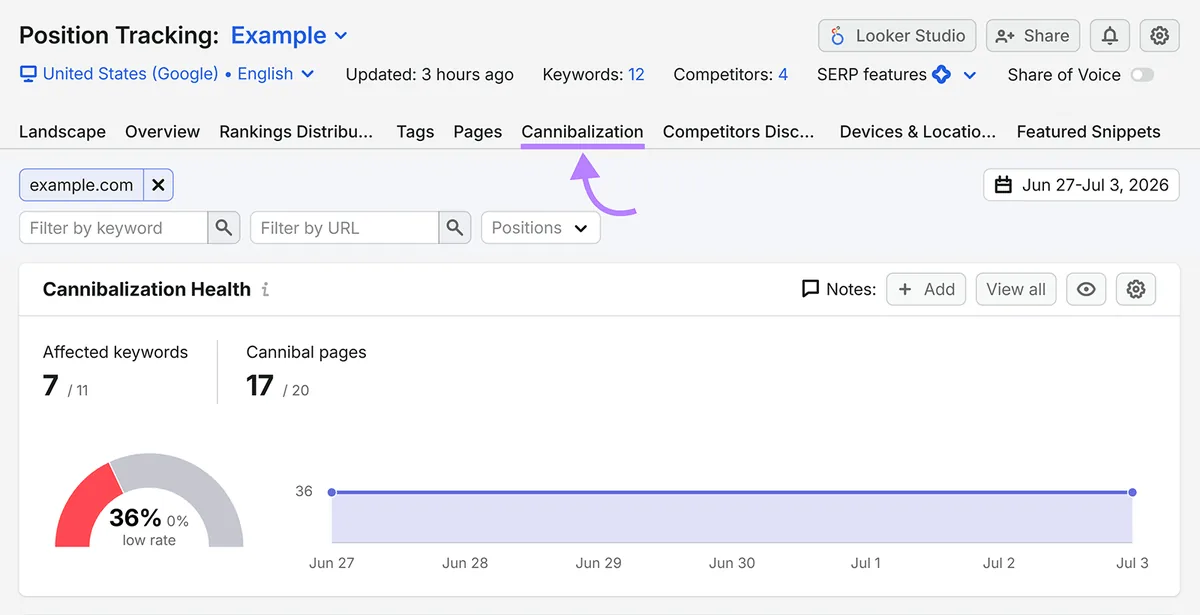
向下滚动到“Cannibalization(蚕食)”部分。我们建议查看“Keywords(关键词)”细分项。
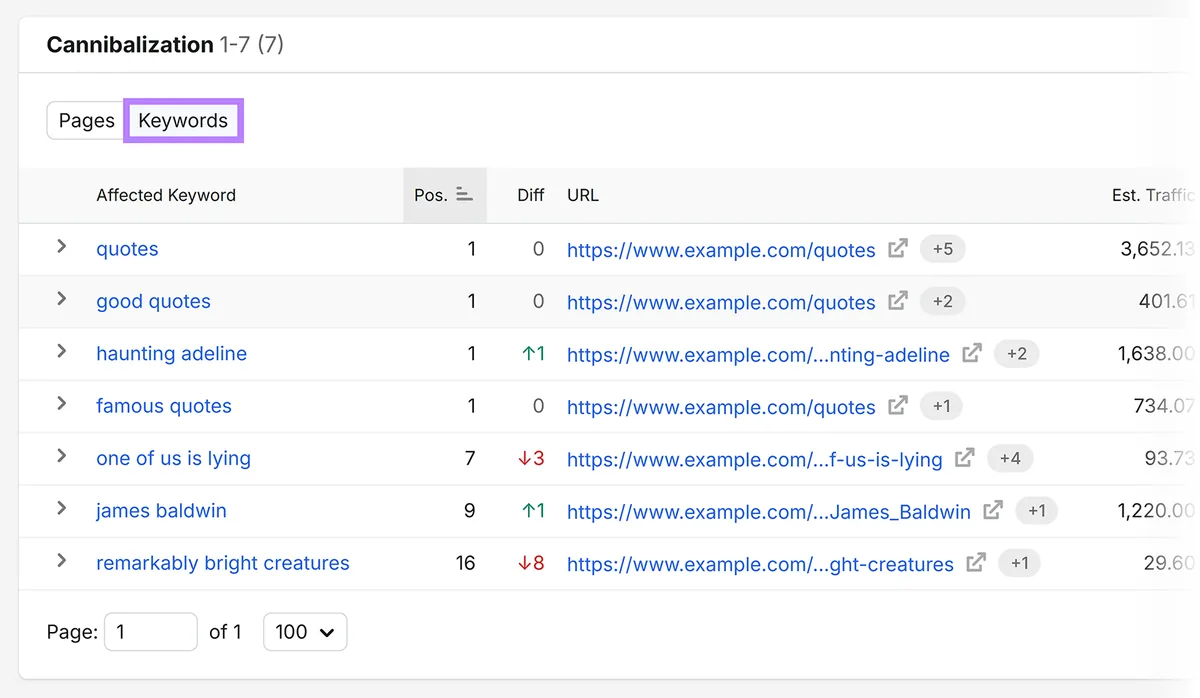
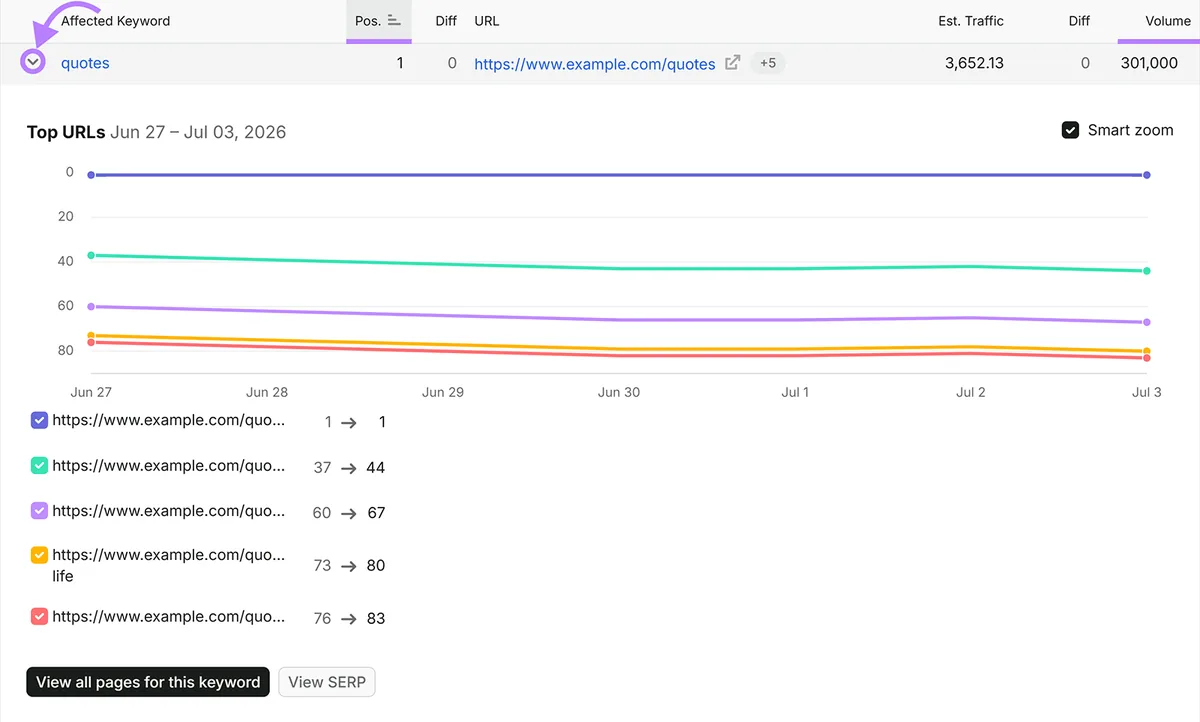
使用箭头展开任何结果。你会看到排名的 URL 及相关数据,例如:
- Pos.(位次):该 URL 在该关键词上的排名
- Volume(搜索量):该关键词的月均搜索次数
Position Tracking 可根据你的套餐跟踪最多 5,000 个关键词。如果你需要跟踪超过 5,000 个关键词,请使用 Semrush Enterprise SEO 的 Cannibalization Report(蚕食报告,我们接下来会介绍)。
使用 Semrush Enterprise SEO 的蚕食报告
Semrush Enterprise SEO 中的 Cannibalization Report 会监控你的排名,以识别最多 25,000 个关键词可能的关键词蚕食情况。
要访问此报告,请前往“Search Performance(搜索表现)” > “Special Reports(特别报告)” > “Cannibalization Report(蚕食报告)”。
你会看到诸如你有多少个被蚕食关键词的统计数据,和目前哪些 URL 排名最高。
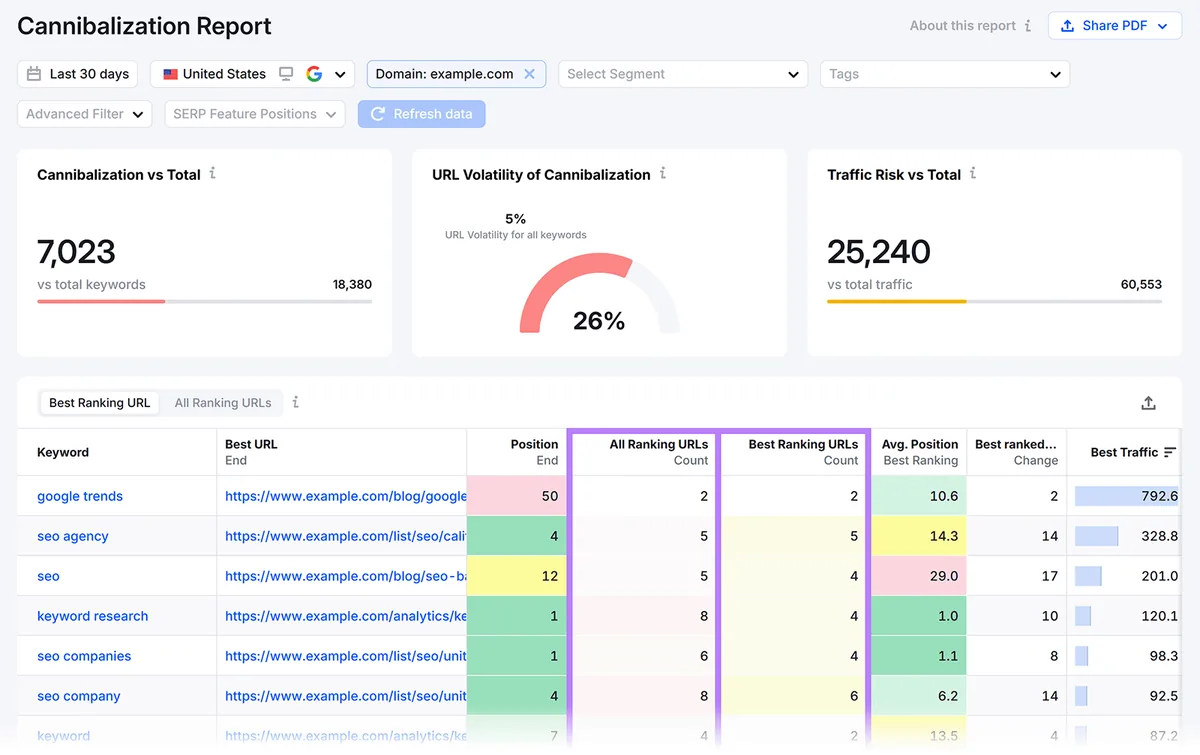
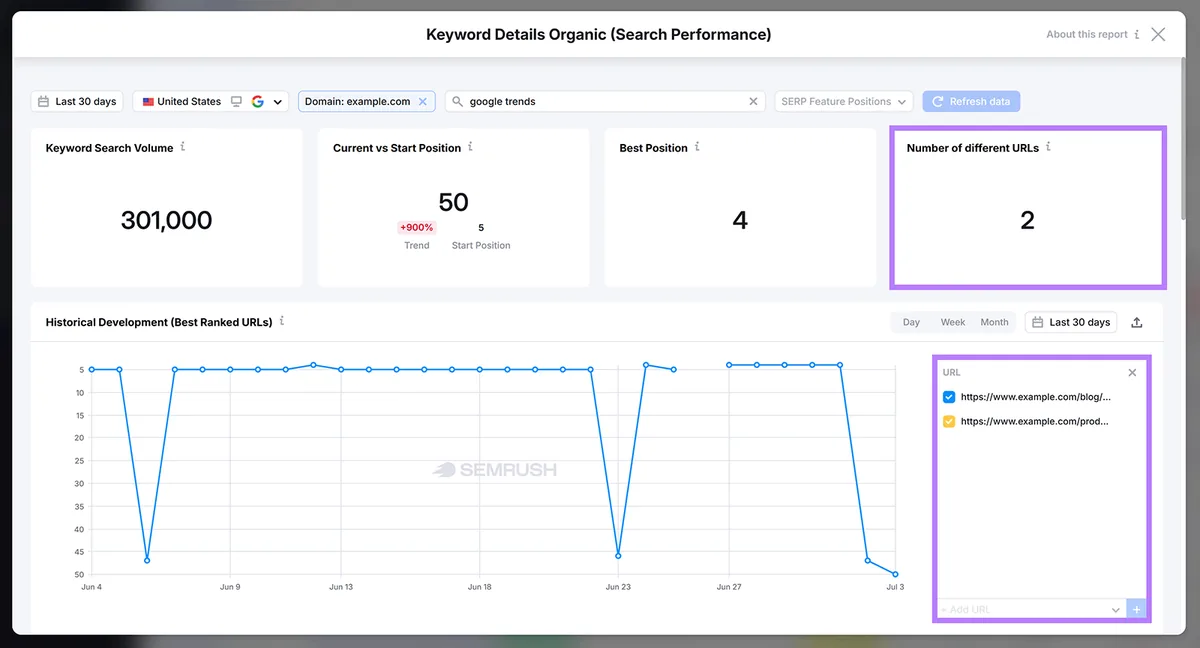
点击任意关键词,打开一份详细报告,显示竞争该关键词的不同 URL。
使用 Google Search Console
Google Search Console(GSC)是一款免费工具,可以帮助你识别关键词蚕食问题。
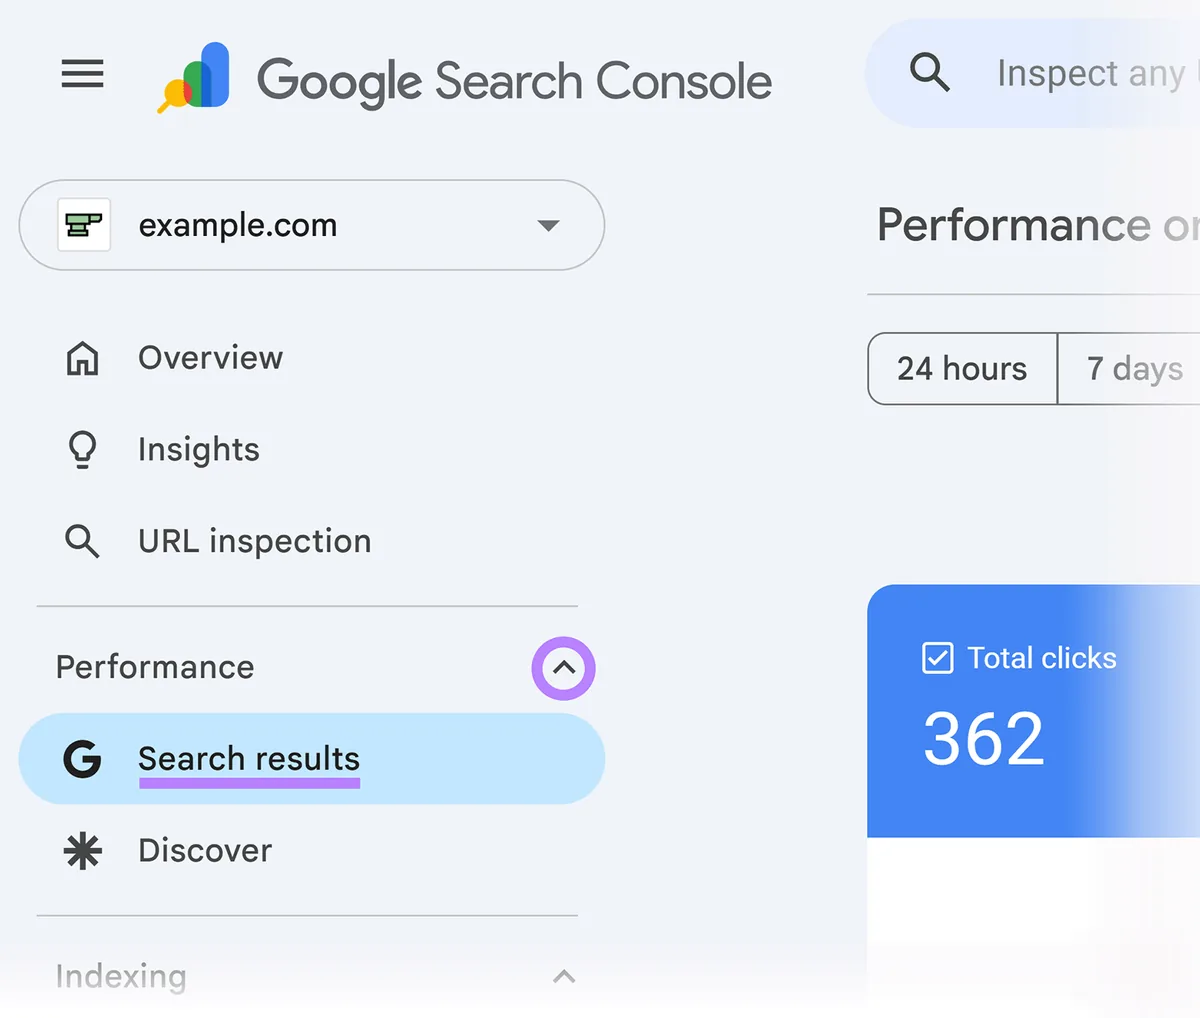
进入你网站的 GSC 资源(如果你还没有,我们的 GSC 指南会教你如何设置资源)。在“Performance(表现)”菜单中点击“Search results(搜索结果)”。
向下滚动,查看你的网站获得展示和点击的搜索查询列表。
点击你想检查的关键词。这会应用一个“Query:(查询:)”过滤器(一个用于包含或排除特定词语的过滤器)。
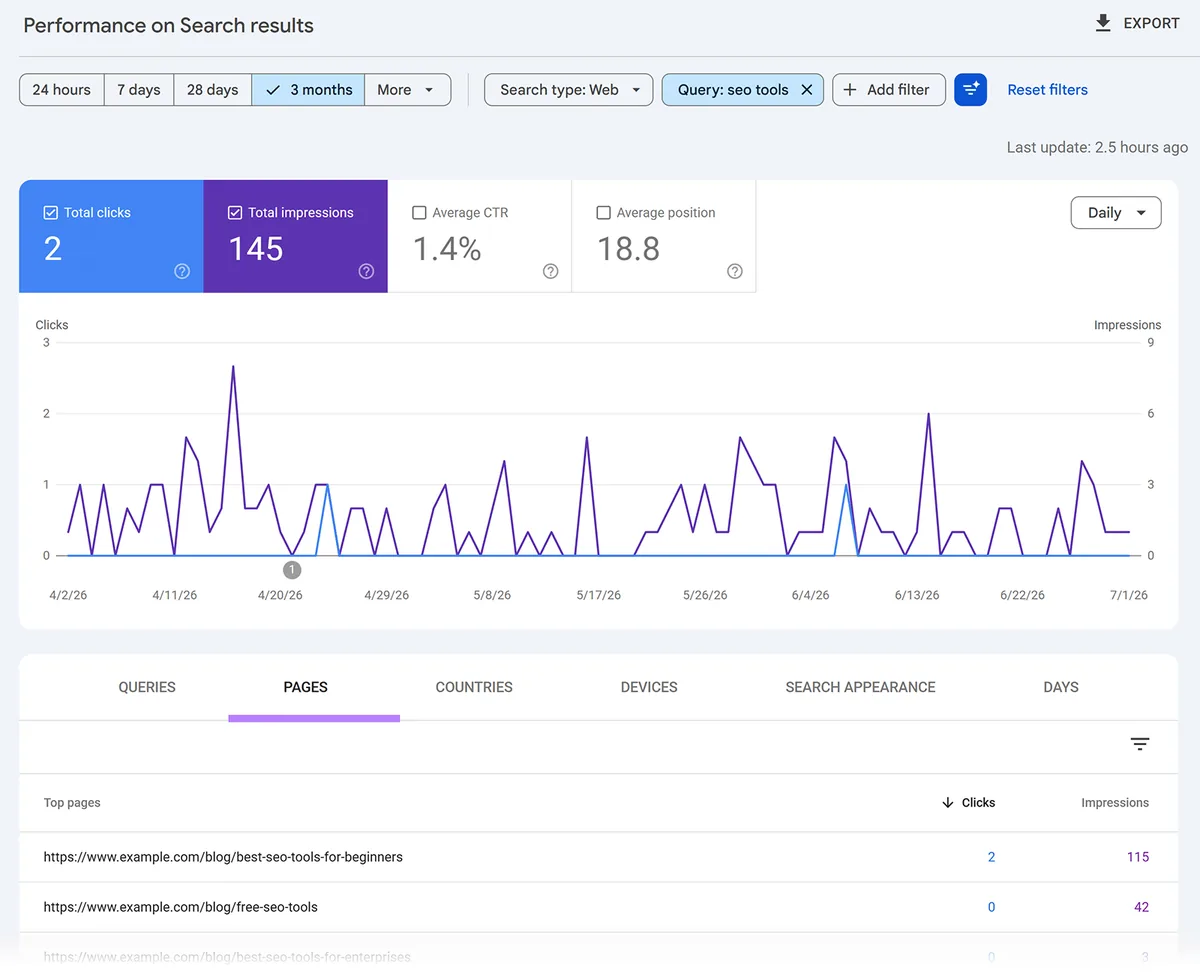
如果有不止一个 URL 获得了点击和展示,这可能就是关键词蚕食的迹象。
手动分析这些页面,看看它们是否有重叠的搜索意图,并记录下你需要修复哪些页面。
搜索你的网站
通过 Google 的“site:[domain]”搜索运算符手动查找重叠的页面。
“site:[domain]”搜索运算符会筛选出来自你域名的结果。将其与关键词结合使用可查找相关页面。就像这样:
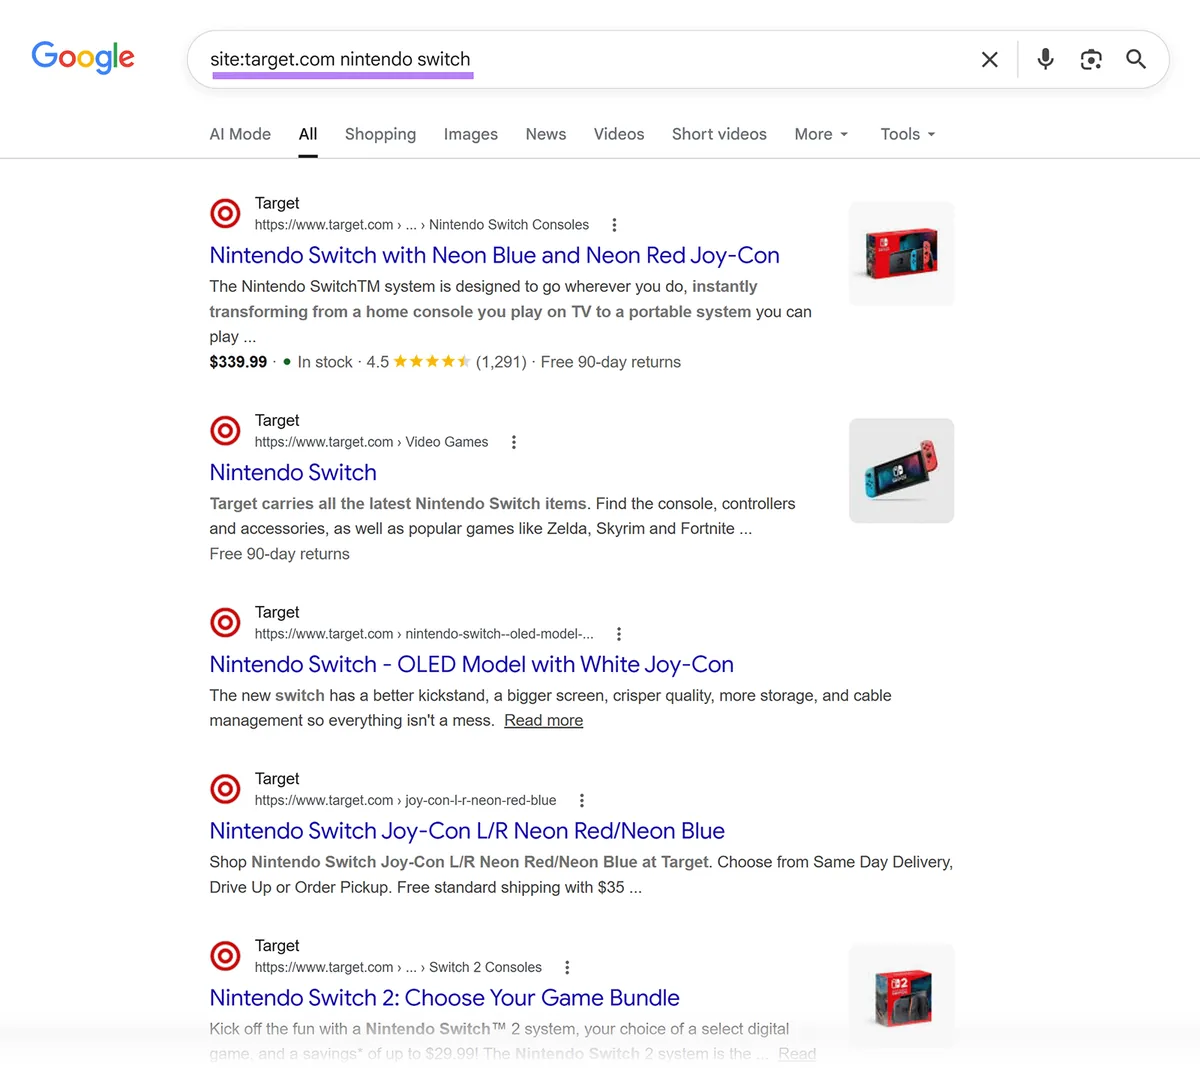
分析结果。是否有任何页面迎合相同的搜索意图?如果有,你就有一个潜在的关键词蚕食问题需要处理。
如何修复关键词蚕食
要修复关键词蚕食,为每个受影响的关键词指定一个首选页面,并使用五种技术中的一种来表明该偏好。
最佳技术取决于你的具体情况:
蚕食解决方案 | 最适合用于 |
|---|---|
重定向 | 相似或重复、你不需要保留的页面 |
规范标签 | 你需要保留的重复页面 |
区分每个页面 | 你需要保留的相似页面 |
Noindex 标签 | 你需要保留但其他方案都行不通的相似页面 |
实施重定向
重定向会把用户和搜索系统引导到与所请求的不同 URL,进而消除内部竞争。
此外,重定向还会把页面的搜索引擎排名能力集中到一处。
当你拥有多个对同一关键词、满足同一搜索意图的页面,但你只需要其中一个时,重定向就很有用。例如,多篇覆盖同一主题的博客文章或几乎相同的 FAQ 页面。
首先,分析你重叠的 URL 并选择你的首选页面。这应该是 SEO 和 AI 搜索潜力最强的 URL,你可以通过查看以下指标来判断:
- 反向链接:使用 Semrush 的 Backlinks 工具查看每个页面的反向链接。理想情况下,你希望主页面拥有大量相关且有权威的反向链接。
- 排名:使用 Google Search Console 查看每个页面的排名。最好的情况是你能保留排名最高的那个页面。
- 流量:使用 Google Analytics 查看每个受影响页面的流量趋势。保留流量最多的页面可能是最好的,但记住 AI 工具不一定能为你的网站带来很多流量。
接下来,起草你首选页面的更新版本。添加你不想丢失的、来自被蚕食页面中的有价值信息,检查所有事实是否准确且最新,并确保该页面具备良好的站内 SEO。
然后,你接下来可以这样操作:
- 在首选 URL 上发布你首选页面的新版本
- 实施 301 重定向(永久重定向),从重复页面指向首选页面,以将用户和搜索系统引导至首选页面。(301 重定向的实施取决于你的内容管理系统或网站平台。如果需要帮助,请联系开发者。)
- 找出并更新任何指向被重定向页面的内链,使它们指向你的首选页面
- 从你的站点地图中移除被重定向的 URL
使用规范标签
规范标签用于标识页面的主要版本,这样你就可以保留相同或几乎相同的页面,而不会损害你网站的表现。
这里有一个实际例子:假设一家电商网站销售一款蓝色 T 恤,由于筛选和排序选项,它可以经由多个带不同参数的 URL访问。
如果你需要相似但专属的按点击付费(PPC)落地页,规范标签同样适用。或者当相同内容可以经由多个 URL 访问时(例如,一个袜子产品页面,用户可以通过“/accessories/socks/”和“/footwear/socks/”访问)也适用。
要标识一个规范页面,请在 <head> 部分为该页面的所有版本(包括主页面)添加一个规范标签(如下所示)。
为你的页面添加规范标签时,请遵循以下提示:
- 使用绝对 URL(例如 https://www.website.com/preferred-page/)。Google 建议使用绝对 URL,因为相对路径更有可能指向错误的域名(尤其是在预发布或子域名环境中)
- 指向一个可索引的页面。规范目标必须返回 200 状态码(一个表示你网页正常工作的状态码),且不得有 noindex 指令。把规范指向一个被 noindex 的页面会发出相互矛盾的信号。
- 避免规范链。如果页面 A 规范到页面 B,而页面 B 又规范到页面 C,这些指向可能会被误解或忽略。应始终直接指向首选 URL。
区分每个页面
区分每个页面有助于搜索引擎和 AI 系统区分它们。
假设你有一个“/laptops/”类目页面提到了游戏笔记本电脑,还有一个“/laptops/gaming/”子类目页面也提到了游戏笔记本电脑。
系统可能会对“/laptops/”页面在关键词“gaming laptops(游戏笔记本电脑)”上给出更高的排名或引用。在这种情况下,你会希望区分每个页面,使搜索和 AI 系统能够将“/laptops/gaming/”识别为与适合游戏的笔记本电脑相关查询最相关的页面。
通过确保每个页面都与其主题高度相关(而不是从多个角度覆盖同一主题)来区分这些 URL。
一些提示:
- 建立 内链。使用相关的锚文本(链接的文本)从相关页面链接到你的蚕食页面。
- 避免页面之间的内容重叠。确保每个页面覆盖独特的角度、示例或用例,而不是重复相同的信息。
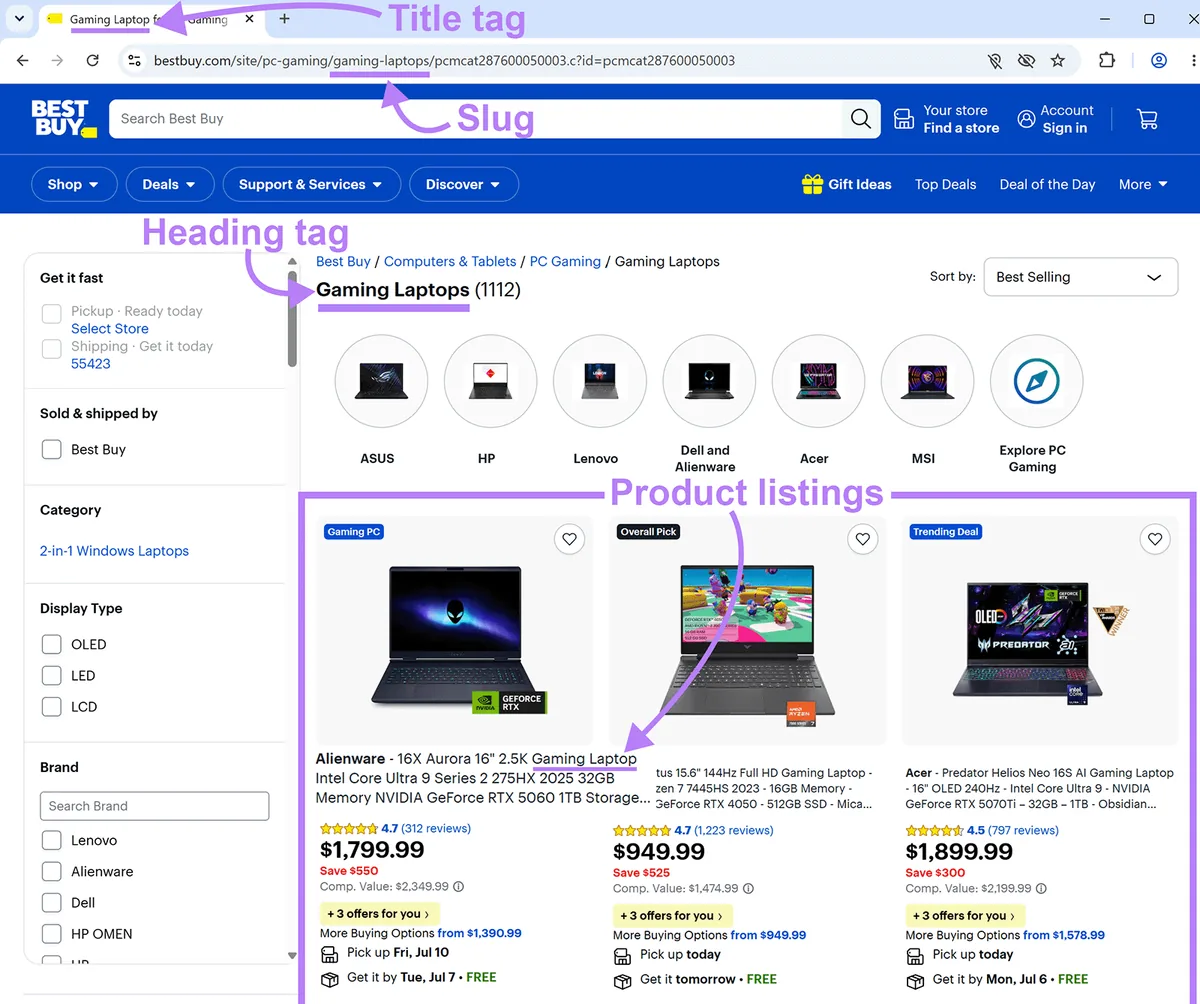
- 为每个页面对其目标关键词优化。将你的关键词自然地包含在标题标签、URL 别名、标题、元描述和正文等位置。
例如,Best Buy 有一个游戏笔记本电脑类目页面,在 URL、H1 标签、产品列表等位置都提到了“gaming laptops”。
使用 Noindex 标签
在蚕食页面上使用 Noindex 标签(指示搜索引擎不要索引某个页面的 HTML),会将它们排除在搜索结果之外,并能阻止它们与你的首选页面竞争。
Noindex 标签出现在页面的 <head> 部分,看起来像这样:
使用 noindex 标签不会整合排名信号,因此你只应把 noindex 作为解决蚕食问题的最后手段。例如,用在内容单薄、没有反向链接且流量很少的博客标签页上。
如何预防关键词蚕食
预防关键词蚕食最可靠的方法,是在发布之前就把关键词和提示映射到 URL。这样,每个页面都有独特的角度,你就能在它们上线之前发现重叠。
首先创建一个关键词地图(一份像电子表格这样的简单文档,把主要关键词或主题分配给一个首选的规范 URL)。在发布新内容之前,检查是否已有另一个页面覆盖了该主题。如果某个页面已经存在,就优化现有页面,而不是创建一个新页面。
然后,使用 Semrush Enterprise SEO 的蚕食报告或 Position Tracking 工具监控被蚕食的关键词。正确的选择取决于你组织的需求。