我们分析了 13.7 万个网站:97% 的 llms.txt 文件从未被读取
我们借助 Ahrefs Web Analytics 和 Bot Analytics,分析 13.7 万个域名的服务器日志与实时流量,访问它们的所有 user agent。以下是研究结果。2026 年 5 月下旬,Google 在不到一周的时间里,就 llms.txt 之争分别在两派观点上各站了一次……
围绕 llms.txt,众说纷纭,但真正拿得出手的证据,只有单站点日志,或偶尔出现的少量小规模实验。
我们借助 Ahrefs Web Analytics 和 Bot Analytics,分析了 13.7 万个域名的服务器日志与实时流量,访问它们的所有 user agent。
以下是研究结果。
2026 年 5 月下旬,Google 在不到一周的时间里,就 llms.txt 之争分别在两派观点上各站了一次。
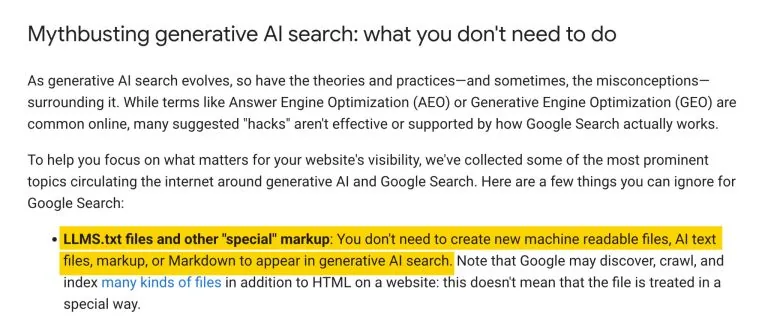
它那份为生成式 AI 功能做优化的新指南,在一个标题就叫“mythbusting(破除迷思)”的章节里告诉网站主,像 llms.txt 这样的机器可读文件并不是出现在生成式 AI 搜索中所必需的。
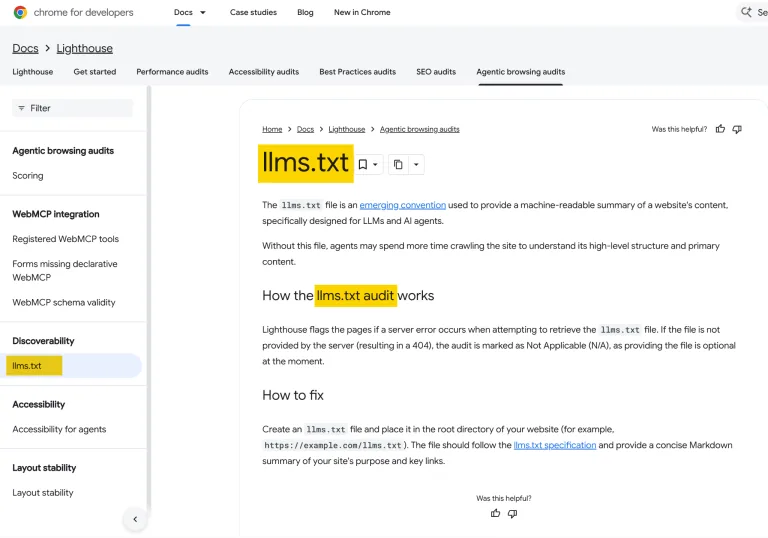
几天后,Chrome 团队在Lighthouse 的实验性 Agentic Browsing 审计项中上线了 llms.txt 检查,文档解释说,如果没有这个文件,代理(agents)可能会花更多时间去抓取网站以了解其结构
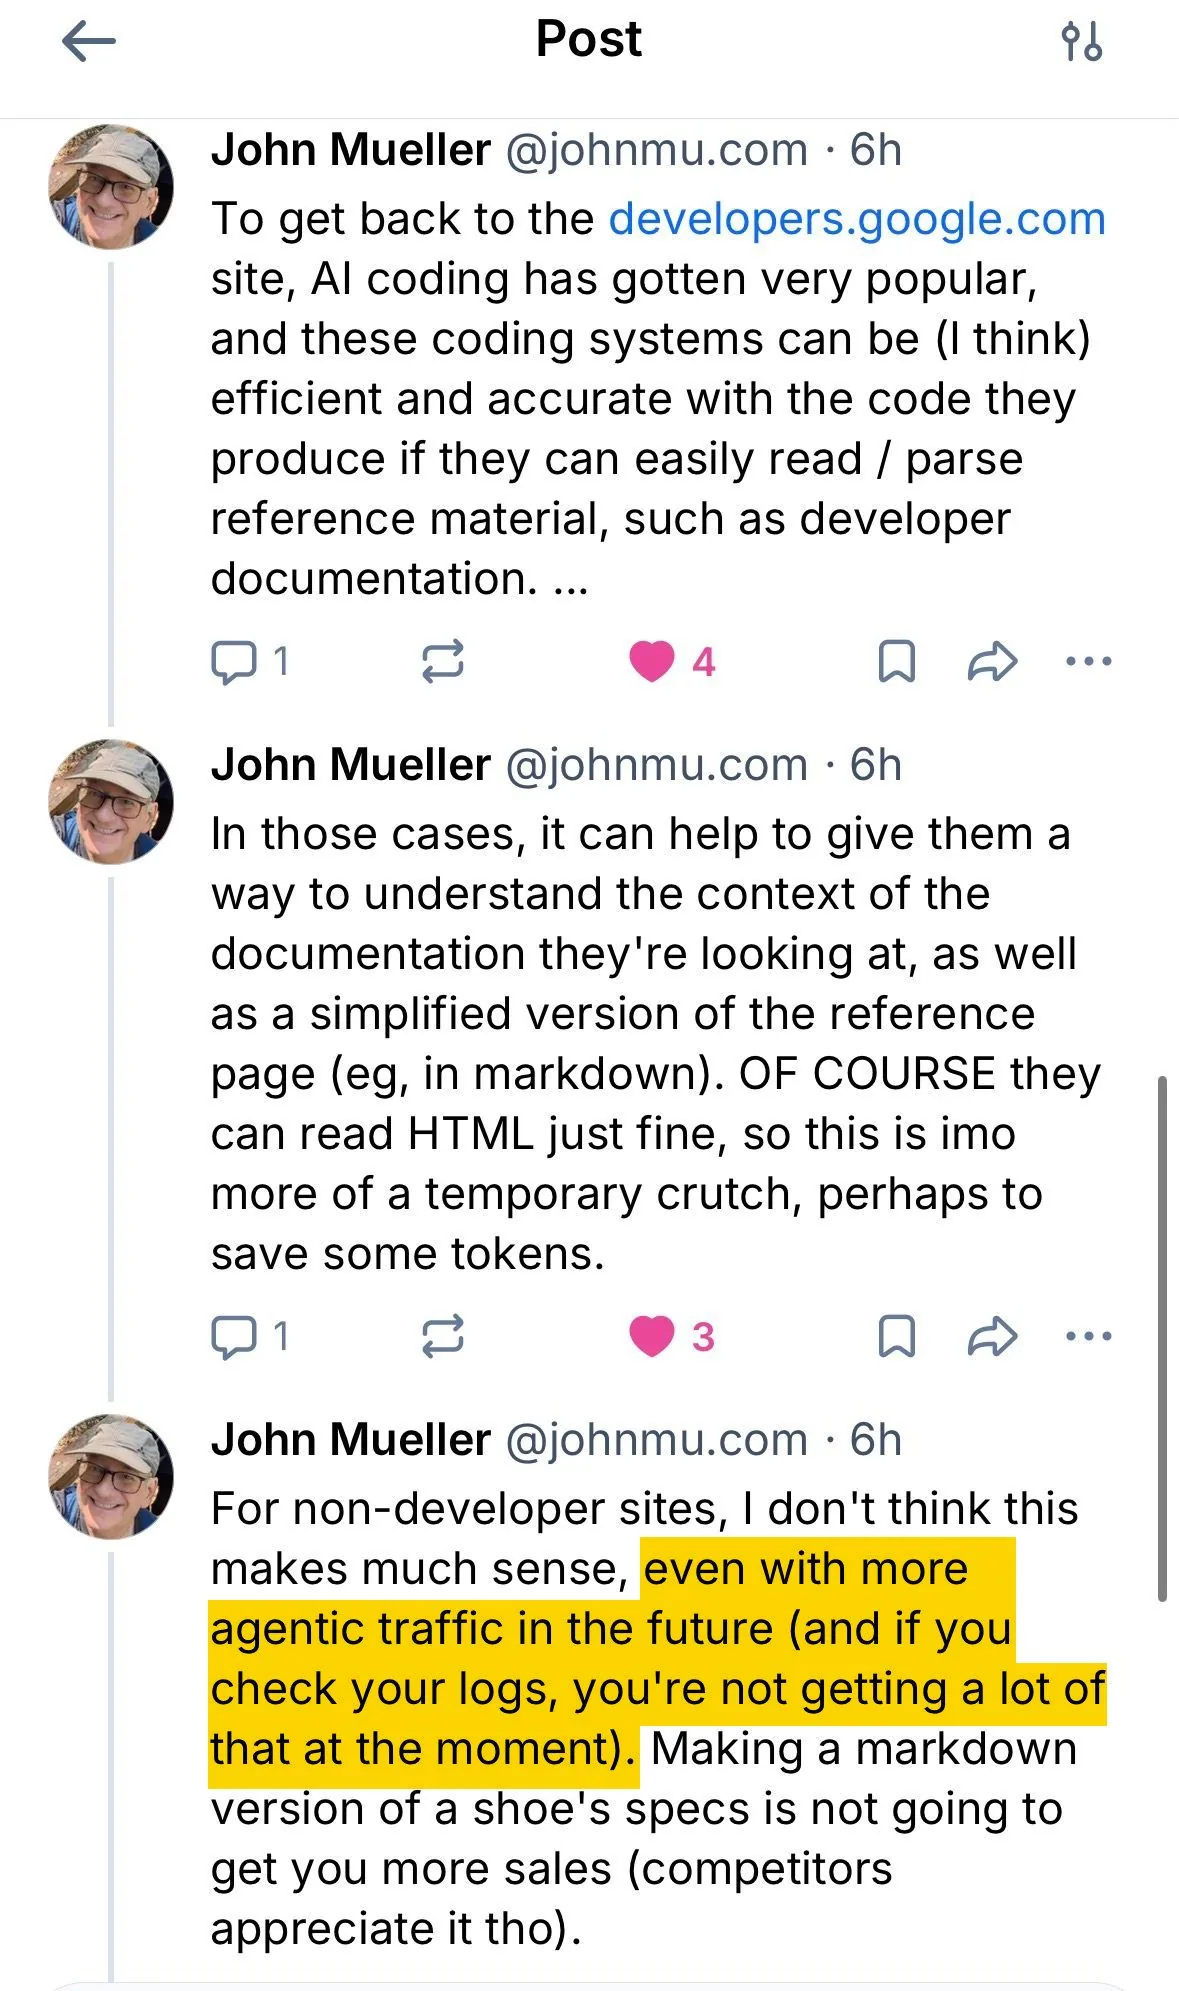
Lily Ray 就此矛盾向 Google 的 John Mueller 追问,他解释说 llms.txt“不是为搜索而做的”。它只是“一个临时的权宜之计,或许是为了节省一些 token”,面向的是解析开发者文档的 AI 编程工具,并非非开发者网站需要操心的事。
他还表示,检查自己日志的网站主会发现,AI 代理的流量极为少。
这正是我们决定验证的一件事。
研究方法
我们的研究聚焦于 Ahrefs Web Analytics 中在 2026 年 5 月有流量的全部 137,210 个域名。
我们先检查每个域名根目录下返回 HTTP 200 的 llms.txt,再用 Ahrefs Bot Analytics 检查整个样本中对 /llms.txt 路径的每一个请求,按 HTTP 响应(200 还是 404)拆分,并按渠道和各个 user agent 分类。
为排除软 404 和幽灵文件,我们还确认每个文件是真正的 Markdown 而非 HTML,并筛查了标题和内容中诸如“404”或“Page not found”之类的错误信号
有几点很重要,需要说明:
- Ahrefs Web Analytics 的用户比整体网络更偏技术、更懂 SEO,所以请把 28% 的采用率数字视为上限。
- 我们并未专门研究某个文件是否符合 llms.txt 规范。
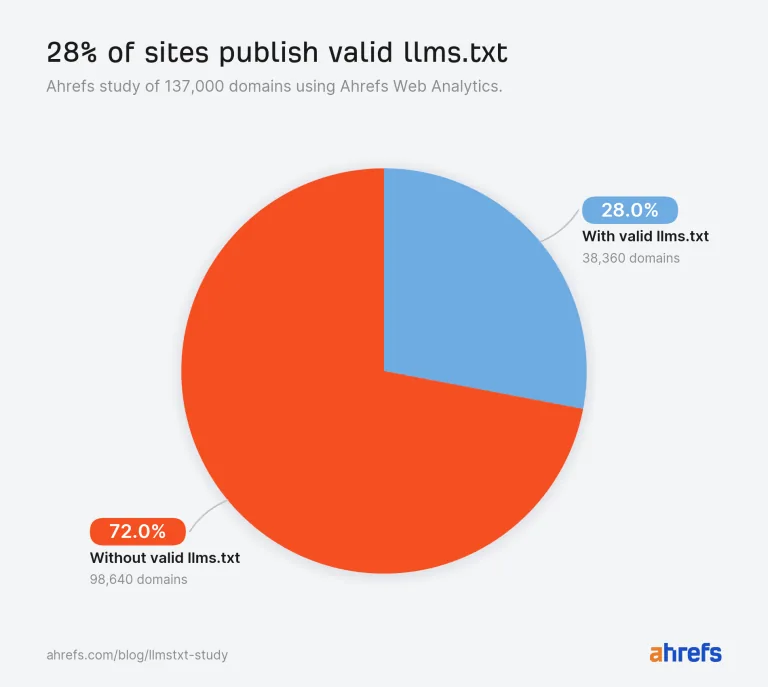
28% 的域名发布了 llms.txt
Google Search 的指导说你可以跳过它,Chrome 团队为它设置了审计项,而 Mueller 则称它是编程工具的权宜之计。
那么,在这些混杂矛盾的说法中,llms.txt 到底有多普遍?在我们研究的 13.7 万个域名中,28% 发布了这些文件。
我们的样本中超过四分的域名(38,000 个)已采用 llms.txt,尽管从未有任何主流 AI 平台承诺会读取它。
这种采用由一种猜测推动——即 AI 平台可能会开始读取该文件,而非由任何确认它们确实会读取的证据推动。
97% 的 llms.txt 文件收到零请求
我们研究中几乎每一个 llms.txt 文件都没被读过。
在约 38,000 个拥有有效文件的域名中,97% 在 5 月份根本没有收到对它的任何请求。
没有机器人。没有人类。什么都没有。
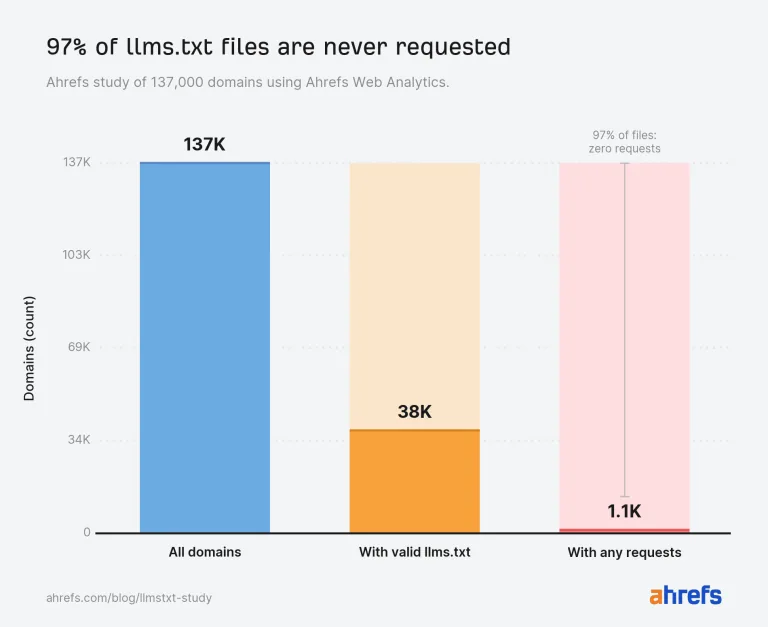
剩下的 3%(1,100 个域名)承接了我们测量到的全部 llms.txt 流量。
我们的数据表明 John Mueller 是对的。因为这个文件,你不仅会发现极少量的AI 流量——你会发现极少的流量,仅此而已。
如果你今天发布一个 llms.txt 文件,迄今为止最可能的结果就是:永远没有任何东西来抓取它。
不过,那 3% 确实被读取的文件,是由一些有趣的访客读取的。
在研究的剩余部分,我们将聚焦于它们。
96% 的对 llms.txt 文件的请求来自机器人
llms.txt 文件是为机器而写的,而机器几乎是唯一在读取它们的东西。
在有流量的那些文件中,96% 的请求来自机器人。
人类占 4%,其中颇为一部分看起来是把 llms.txt 链接分享在聊天应用里的 SEO 们,那些应用的链接预览机器人会尽责地去抓取它们。
仅 Slackbot 一个,抓取 llms.txt 文件的次数就比 PerplexityBot 还多。
Perplexity 正是 llms.txt 表面上想要帮助的 AI 搜索引擎,所以发现一个聊天应用的链接预览机器人抓取的次数比它还多,充分说明了这些文件实际激起的真正 AI 搜索兴趣有多少。
读取 llms.txt 的机器人中 77% 并非来自 AI 工具
许多网站发布 llms.txt,恰恰是因为它们以为这能提高自己在 ChatGPT 答案中出现的几率、赢得 Perplexity 引用,或者拿下一次 AI Overview。
但我们的数据讲述了另一个故事:77% 抓取 llms.txt 的机器人根本不是 AI 工具。
为了弄清究竟哪些机器人在请求 llms.txt,我们把每一个 user agent 分成了十二个类别。
* SEO 审计工具包括 Ahrefs 自家的爬虫(SiteAuditBot、Ahrefs Bot 和 Ahrefs Site Audit),它们合计贡献了 2,334 次请求(占总量的 10.6%)。把它们排除后,第三方 SEO 审计工具贡献了 2,442 次请求(11.1%)。各机器人类别合计占总请求的 96%;剩余 4%(930 次请求)来自人类。
单看的话,没有任何一个 AI 机器人类别能进入前四。
SEO 审计工具(21.7%)、其他及无法识别(14.9%)、通用网络爬虫(13.1%)和技术分析工具(11.6%)发出的请求都多于任何单独的 AI 机器人。
最大的单一 AI 类别——AI 代理(AI agents)——以 10.5% 位居第五。
但当你把四个 AI 类别(训练爬虫、检索机器人、助手和代理)合并起来时,AI 机器人就成了最大的单一类别,占 19.5%。
机器人流量可以分成三种情形:
- 消费该文件的 AI 机器人(19.5%)
- 匿名爬虫的长尾(14.9%)
- 审计它的行业力量(12.1%)
我们将在下面深入探讨其中几类。
19.5% 的请求来自 AI 机器人
在确实到达 llms.txt 文件的请求中,有名字的 AI 机器人占 19.5%。
虽然 AI 机器人是 llms.txt 最大的可识别读者群,但按 AI机器人类型拆分后可见,这个文件并没有服务于大多数人心里想的那些 AI 工具。
我们把它们归为四类:
- AI 代理与代理基础设施:代表用户行事,或为给这些代理提供服务而抓取。
- AI 训练爬虫:为构建模型而收集数据
- AI 助手:实时代表用户浏览网络
- AI 检索机器人:在 AI 平台中抓取页面,以回答实时用户查询
它们各自的规模是这样的……
AI 代理,为服务它们而构建的基础设施,驱动了 llms.txt 请求的 10.5%——多于任何其他类型的 AI 机器人。
这一发现与业界许多人早已有的直觉相吻合。
前面听到 John Mueller 说,llms.txt 最适合作为 AI 编程代理的参考材料。
Chris Long,Nectiv 的创始人,也曾表示,即便 llms.txt 对你在 Google 搜索中没有帮助,但如果客户“正在使用 Claude Code 来获取推荐”,这个文件也是有用的
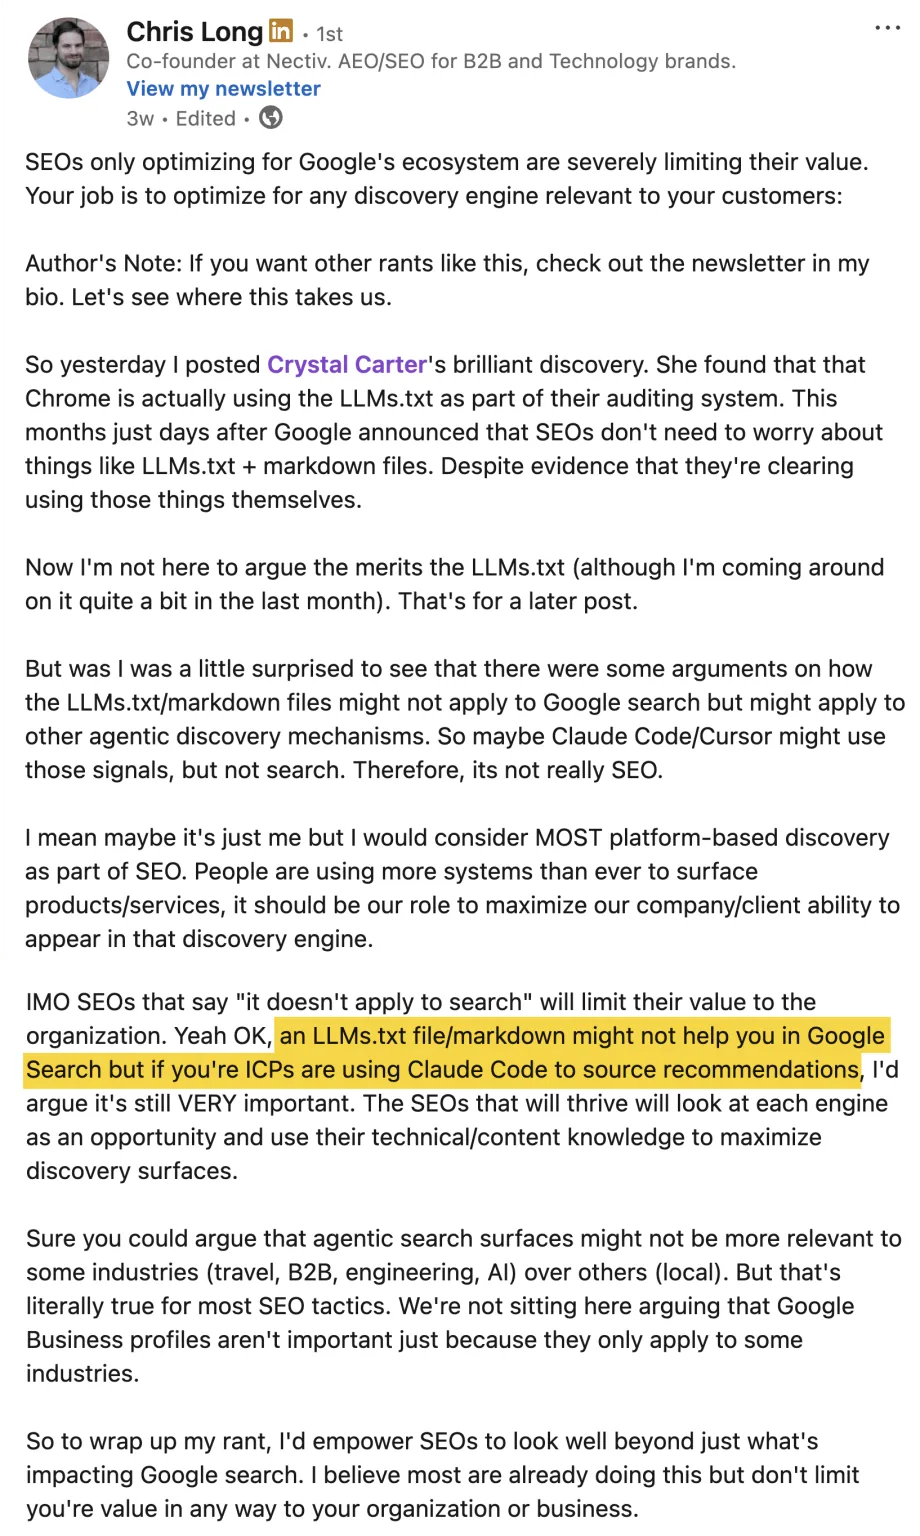
我们的 Bot Analytics 数据支持这两个观点。
我们看到 llms.txt 文件被那些表面上负责可见度的搜索和 AI 机器人抓取得少得多,而被那些寻找结构化信息、且/或代表用户行事的代理式工具抓取多得多。
除 statespace-indexer 和 GPTBot 之外,Claude-Code(Anthropic 的编程代理)抓取的次数超过了每一个 AI 检索机器人、每一个 AI 助手和每一个 AI 训练爬虫。
训练爬虫以 5.3% 位列第二大的 AI 类别
llms.txt 文件为训练语料库提供的内容,多于它为 AI 搜索检索提供的内容。
所以,如果 llms.txt 要以任何方式影响你品牌的 AI 可见度,它很可能是在上游——而不在检索环节。
在所有训练爬虫中,GPTBot 是遥遥领先的 llms.txt 抓取者。
AI 检索机器人几乎可以忽略不计,仅占总请求的 1.1%
根据我们的数据,AI 检索机器人仅占 AI 机器人请求的 1.1%。
即便与 AI 助手和 AI 训练爬虫加在一起,这些机器人也仍只占请求的 8.9%(比 AI 代理少 1.6%)。
OAI-SearchBot、PerplexityBot 和 Claude 的搜索爬虫加在一起,也只跨越数千个网站了区区数百次抓取。
如果你打算生成一个 llms.txt 以期望提升你的 AI 引用,可能要重新考虑一下。
12% 的请求来自研究 llms.txt 的工具,而非消费它的工具
在还没弄清是否有任何主流 AI 平台真正读取它之前,一整个围绕 llms.txt 标准的审计、打分、验证和研究的生态就已经形成了。
三个类别合计占全部请求的 12%。
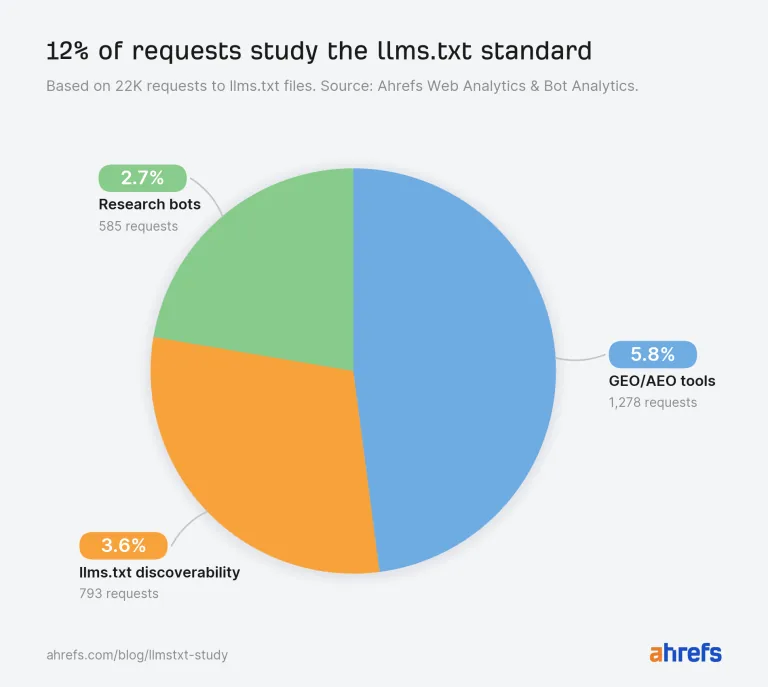
GEO/AEO 工具发出 5.8% 的请求
商业工具扫描网站,并为它们面向 AI 搜索和代理发现的就绪程度打分,llms.txt 只是众多信号。
其中最活跃的 CairrotReadinessBot 属于 Cairrot,这是一个于 2025 年底推出的、面向 WordPress 的 AEO 平台。
此外还有 Framer、Lovable 和 Wix 这类主流网站构建器,都纷纷把 AI 就绪度检查内建到自己的产品里。
llms.txt 的采用在成为网站主的决定之前,就已经先成了平台默认设置。
llms.txt 可发现性机器人覆盖 3.6% 的请求
有一个工具生态专门用来编目那些几乎没人读的 llms.txt 文件。
专为 llms.txt 文件打造的扫描器、验证器和目录,发出的请求比 AI 检索机器人和 AI 助手还多。
研究机器人发出 2.7% 的请求
数据集中最大的单一研究爬虫自称 prompt-injection-survey/1.0。
有人在系统性地研究 llms.txt 作为一个提示注入(prompt injection)机会——而 AI 代理本就被设计为去摄取并信任这类文件。
代理大规模信任 llms.txt 文件所带来的安全影响,几乎还没被讨论过,而潜在的不法分子却已经在行动了。
没有任何 AI 机器人会“去寻找”不存在的 llms.txt 文件
AI 工具从不会去寻找不存在的 llms.txt 文件,所以发布一个并不会让你进入任何 AI 的雷达范围。
我们分析了每一个返回 404 的对 /llms.txt 路径的请求,发现了我们在机器人数据中见过的最干净的分野:一方面,有效文件吸引了 96% 的机器人流量;另一方面,缺失的文件吸引了 98% 的人类流量,而AI 机器人在这些 404 中占比为零。
那些探测不存在的 llms.txt 文件的人,是在浏览器里输入 URL 的人类,想必是 SEO 们在检查竞品。
这打破了那种认为 AI 系统会主动搜寻 llms.txt 文件、而缺少该文件的网站等于错过了一次敲门机会的假设。
AI 工具是在有链接、有索引或有用户指令告诉它们该文件存在时,才会去抓取 llms.txt。
那么,你应该创建 llms.txt 文件吗?
如果你的目标是出现在 ChatGPT、Perplexity 或 AI Overviews 中,那么 llms.txt 文件基本上只是摆设。
以下是并排对比的优缺点。
我的结论是:目前弊大于利。如果你想出现在 AI 搜索中,相比这个文件,有更可靠的方式来提升你的可见度。
但如果你还在盘算着生成 llms.txt,那么应该采取以下步骤:
- 在进一步投入之前,先检查你自己的日志。97% 的零读者概率就是基准概率。
- 让网站构建平台替你完成。Wix 已经在生成这些文件,而 Framer 和 Lovable 也在扫描它们。一年之内,拥有 llms.txt 可能就会像拥有站点地图一样,成为 CMS 的默认设置。如果回报不确定,把投入压到最低是合理的。
- 把代理引导到它那里。在你的 HTML 中链接该文件,在你的文档中引用它,或在任何代理接收你网站指令的地方提到它。代理是在被引导时才抓取 llms.txt,而不是靠猜测。
- 像对待代码一样对待 llms.txt,以抵消提示注入风险。对它做版本控制,限制谁能编辑它,为未授权更改设置告警,让内容只保留纯链接和描述(不要任何形似指令的东西),只链接你掌控的资源,并审查任何平台代表你自动生成的东西。
这项研究回答了有多少网站发布 llms.txt,谁在读它。
但还有几个值得进一步研究、却超出本研究范围的问题:
- 代理更频繁地抓取开发者文档吗?Claude-Code 对 llms.txt 的兴趣是否像 Mueller 的框架所预测的那样,集中在 /docs/ 和 /api/ 这类文档路径上?
- 机器人真的会对它们读到的东西采取行动吗?当一个 AI 代理抓取了 llms.txt 后,它随后会去抓取该文件所链接的资源吗?SEO 顾问 David McSweeney,Queryburst 的创始人,已经在一个与此相关的实验:他向 AI user agent 提供他测试站点的一份压缩的、对代理友好的摘要,并附上请求更深层内容的指令,同时追踪是否有任何代理真的会照做。他的结果值得关注。
Mueller 称 llms.txt 是一个临时的权宜之计。
但这个权宜之计似乎已经拥有了自己的供应链:生成 llms.txt 文件的平台、审计它们的行业,研究它们的安全研究人员,而这一切都发生在“读者”真正出现之前。
我们要么是在目睹一个真正标准的早期脚手架,要么是在目睹 SEO 行业证明它可以对任何东西产品化。我们猜是两者兼有一点。