什么时候该担心抓取预算?
抓取得更多并不意味着排名会更好,但如果页面没有被抓取和索引,它们根本无法获得排名。大多数网站无需担心抓取预算,少数情况下则需留意。
抓取预算(crawl budget)指搜索引擎为抓取某网站所允许投入的时间与资源量。它由抓取需求(crawl demand)与抓取速率(crawl rate)构成:抓取需求指搜索引擎想抓取网站上的多少个页面,抓取速率指其能抓取多快。它受两方面影响:爬虫愿意在网站上投入多少资源,还有服务器能支撑多大强度的抓取。
抓取得更多并不意味着你的排名会更好,但如果你的页面没有被抓取和索引,它们根本就不会获得排名。
大多数网站无需担心抓取预算,但在少数情况下你可能需要留意一下。我们来看看其中几种情况。
什么时候该担心抓取预算?
SEO 人员通常不必为热门页面的抓取预算担心。往往是比较新的、链接不佳的,或者变化不大的页面才不常被抓取。
对于较新的网站,尤其是页面数量很多的网站,抓取预算可能是个问题。你的服务器或许能支撑更大强度的抓取,但由于网站较新、可能还不太受欢迎,搜索引擎可能不愿意过多地抓取你的网站。
这主要是期望上的脱节。你希望页面被抓取和索引,但 Google 并不确定你的页面是否值得索引,因此可能不愿意抓取你期望的那么多页面。
如何检查抓取活动
如果你想了解 Google 抓取活动的概览与它们发现的任何问题,最好的去处是 Google Search Console 中的抓取统计信息报告(Crawl Stats report)。
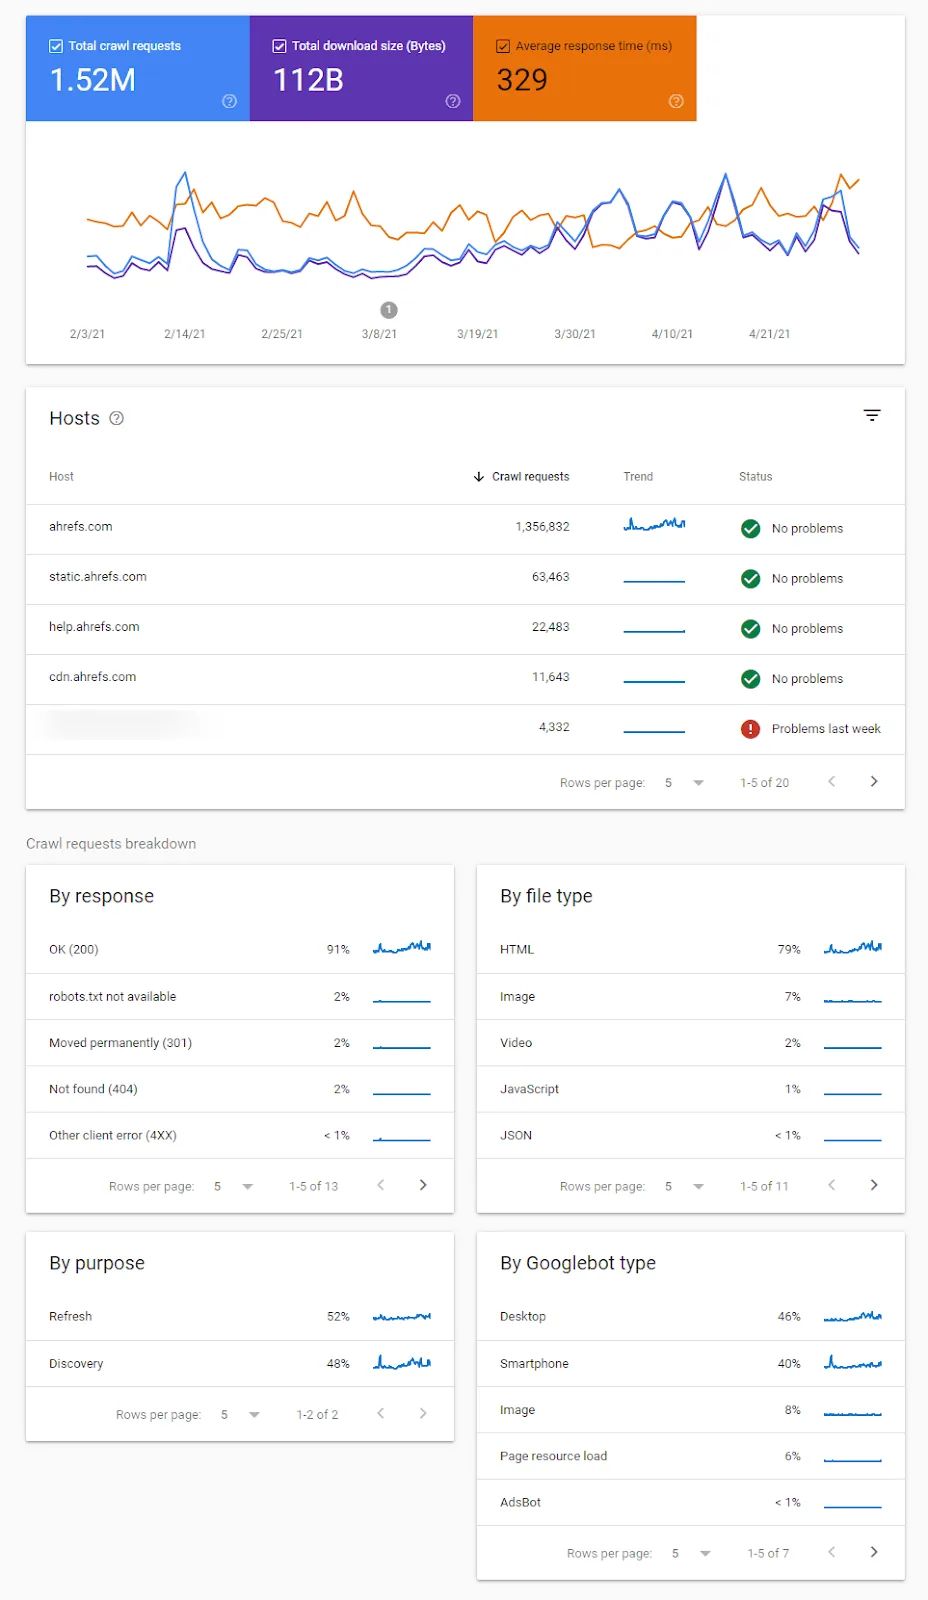
这里有各种报告,帮你识别抓取行为的变化、抓取中的问题,并提供关于 Google 如何抓取你网站的更多信息。
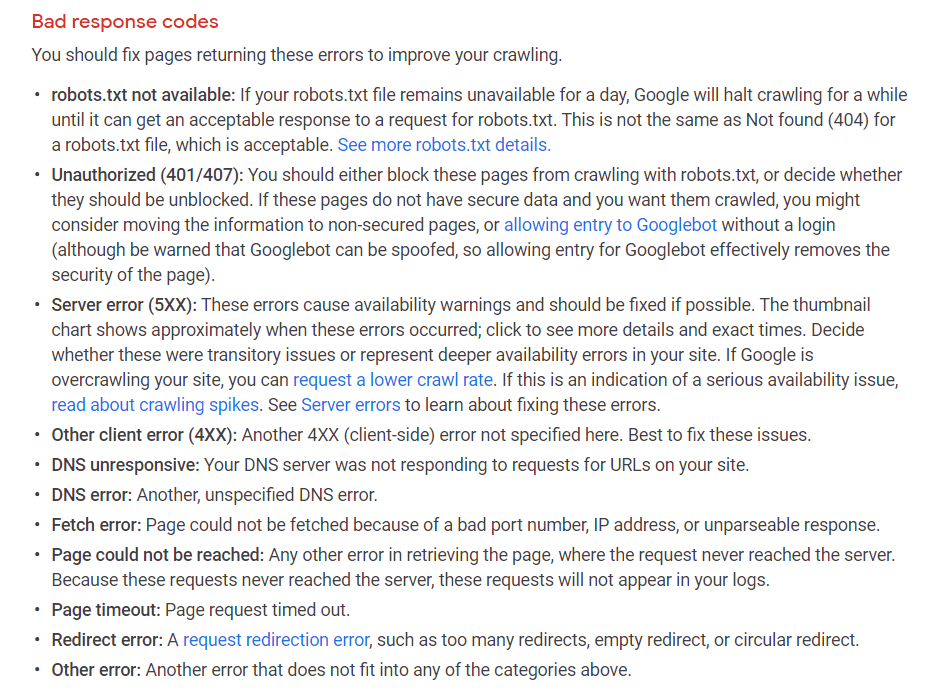
你肯定需要调查任何被标记的抓取状态,就像这里显示的这些:
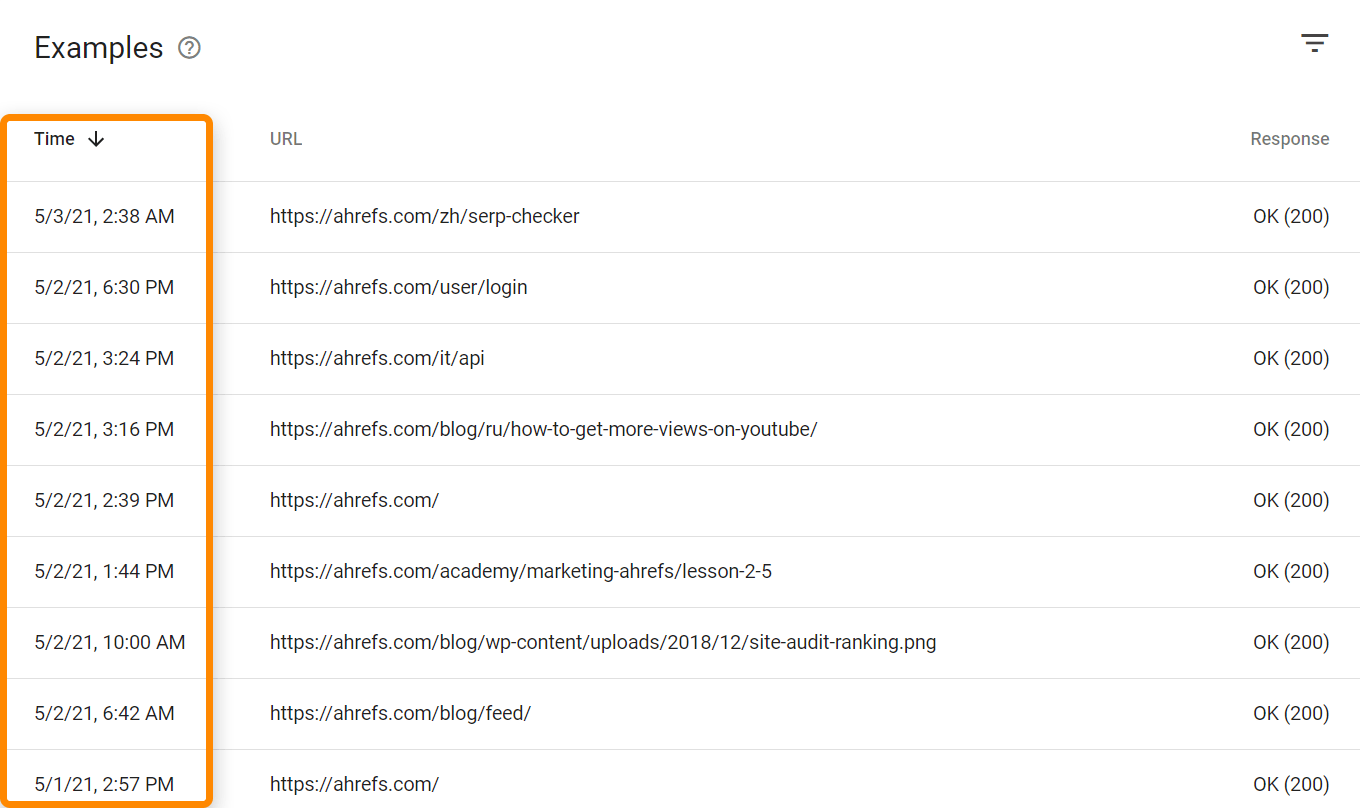
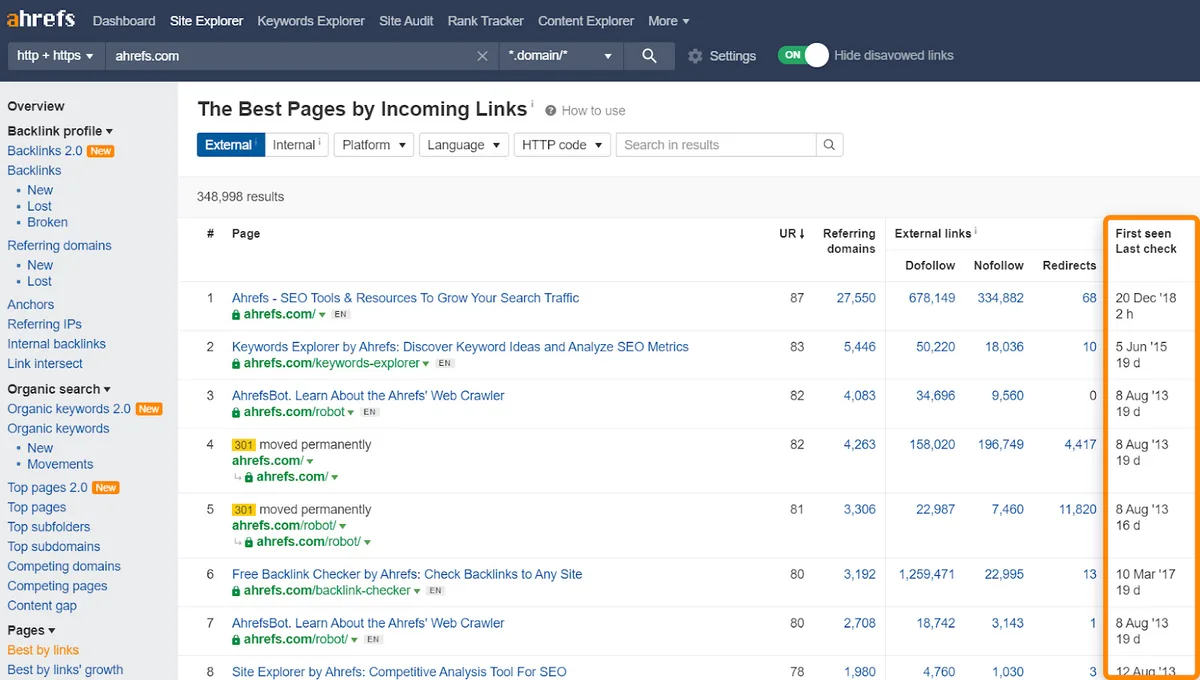
这里还有页面上次被抓取的时间戳。
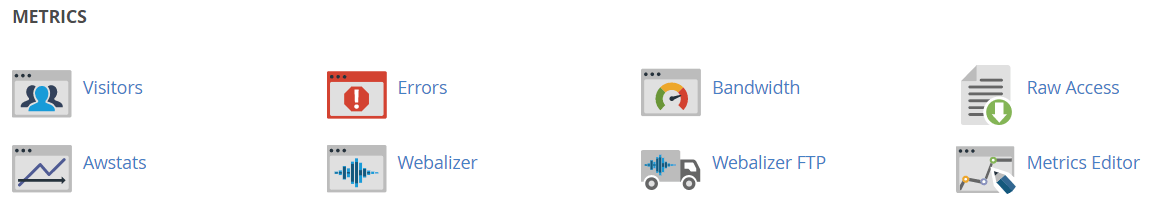
如果你想查看所有爬虫和用户的访问记录,就需要访问你的日志文件。根据主机和配置的不同,你可能会用到 Awstats 和 Webalizer 之类的工具,比如这里在一个装有 cPanel 的共享主机上所见。这些工具会展示日志文件中的一些汇总数据。
对于更复杂的配置,你必须获取并存储来自原始日志文件的数据,这些数据可能来自多个来源。对于更大的项目,你可能还需要专门的工具,比如 ELK(Elasticsearch、Logstash、Kibana)技术栈,它支持日志文件的存储、处理和可视化。此外还有 Splunk 之类的日志分析工具。
哪些内容会占用抓取预算?
所有 URL 和请求都会占用你的抓取预算。这包括备用 URL,如 AMP 页面或 m-dot 页面、hreflang、CSS、嵌入式内容,还有包括 XHR 请求在内的 JavaScript。XHR 请求不像其他文件那样被缓存,因此对于基于 JavaScript 框架构建的网站,你会看到这类请求显著更多。更多细节请见我们的 JavaScript SEO 指南。
这些 URL 可能通过抓取和解析页面被发现,也可能来自各种其他来源,包括规范链接元素(canonical)、页面上的链接、站点地图、RSS 订阅、在 Google Search Console 中提交 URL 以供索引,或使用索引 API(Indexing API)。
还有多个 Googlebot共享抓取预算。你可以在 GSC 的抓取统计信息报告中找到正在抓取你网站的各种 Googlebot 列表。
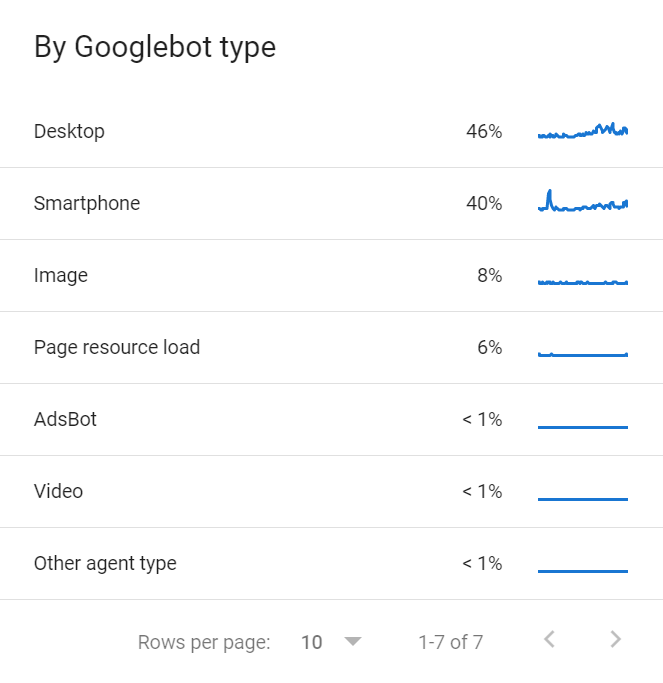
Google 如何调整其抓取方式
每个网站的抓取预算都不同,它由几个不同的输入因素构成。
抓取需求(Crawl demand)
抓取需求简单来说就是 Google 想抓取你网站上多少内容。更受欢迎的页面与发生重大变化的页面会被抓取得更多。
这些重复内容大多是技术性原因造成的,它们会浪费抓取预算。以下是一些示例。
- HTTP 与 HTTPS 变体 例如:http://www.example.com 和 https://www.example.com。
- 不带 www 与带 www 的变体 http://example.com 和 http://www.example.com。
- 带与不带尾部斜杠 的 URL https://example.com/page/ 和 https://example.com/page。
- 带与不带大写字母的 URL https://example.com/page/ 和 https://example.com/Page/。
- 页面的默认版本,如索引页 https://www.example.com/、https://www.example.com/index.htm、https://www.example.com/index.html、https://www.example.com/index.php、https://www.example.com/default.htm 等。
- URL 参数 例如:example.com?parameter=whatever。它们可能因跟踪代码、分面导航、内容排序、会话 ID 等原因而存在。
还有一个「陈旧度(staleness)」的概念。如果 Google 发现某个页面没有变化,它们就会降低该页面的抓取频率。例如,如果它们抓取了一个页面后一天内没有发现变化,可能会等三天再抓取,下一次是十天、30 天、100 天,依此类推。它们两次抓取之间并没有固定的等待周期,但会随时间推移变得越来越不频繁。不过,如果 Google 发现整个网站发生重大变化或网站迁移,通常会增加抓取速率,至少是暂时增加。
抓取速率上限(Crawl rate limit)
抓取速率上限是指你的网站能支撑多大强度的抓取。网站能承受一定量的抓取,超过后就会出现服务器稳定性问题,比如变慢或报错。大多数爬虫一旦开始发现这些问题就会减少抓取,以免对网站造成伤害。
Google 会根据网站的抓取健康状况进行调整。如果网站能承受更多抓取,上限就会提高。如果网站出现问题,Google 就会降低抓取速率。
如果 Google 收到过多的 5xx(服务器错误)或 429(请求过多)HTTP 状态码,它们就会放慢抓取。如果服务器的连接时间变慢,它们同样会放慢。
我希望 Google 抓取得更快 / 更聪明
你可以做一些事情,来确保网站能支撑额外的抓取并提高网站的抓取需求。我们来看看其中一些做法。
加快服务器 / 增加资源
Google 抓取页面的方式基本上是下载资源,然后在它们那一端进行处理。这与用户感知的页面速度并不完全相同。真正影响抓取预算的是 Google 连接和下载资源的速度,而这更多地取决于服务器和资源。检查你的日志中是否有 5xx 或 429 错误。
把重要页面加入站点地图
确保任何你希望被抓取和索引的页面都包含在你的站点地图中。
清除重复内容
前面我们提到过网络上有 60% 是重复内容,而这些多余的页面中许多是技术性原因造成的。如果你清除这些重复内容,Google 就能专注于抓取唯一的 URL。例如,你可能想用 robots.txt 屏蔽分面导航 URL,或者用 # 代替 ? 来表示参数,因为 # 通常会被服务器和爬虫忽略。
获取更多链接,外部和内部
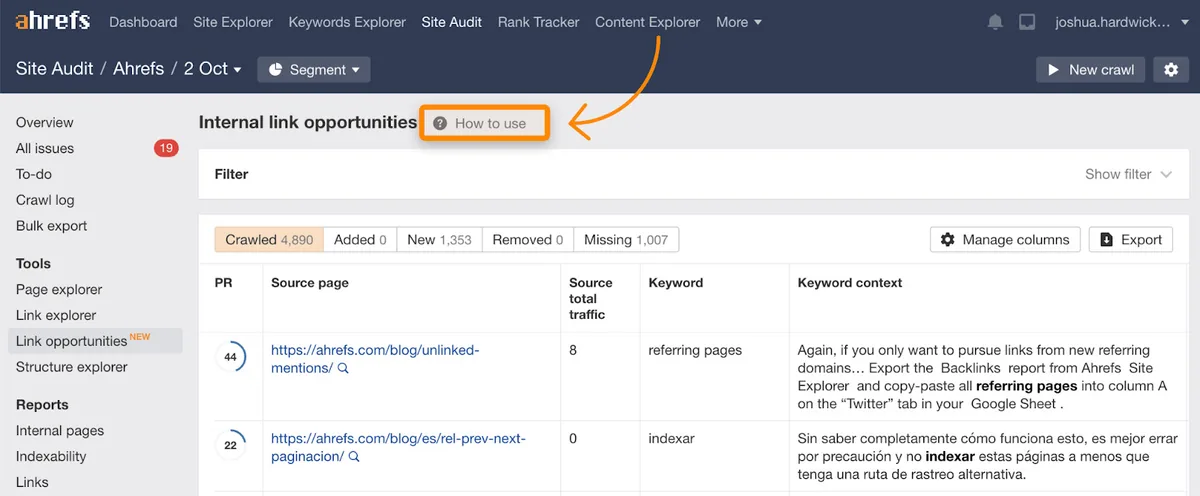
记住,抓取需求通常基于受欢迎程度或链接。你可以通过增加外部链接和/或内部链接的数量来提高预算。内链更容易,因为网站由你掌控。你可以在 Site Audit 的 Link Opportunities 报告中找到建议的内链,该报告还包含一个讲解其工作原理的教程。
修复重定向链接
在网站上保留指向已重定向页面的链接,会对抓取预算产生一点小影响。通常,这里链接到的页面优先级偏低,因为它们可能已经有一段时间没有变化了,但清理任何问题总体上有利于网站维护,并会稍微有助于你的抓取预算。
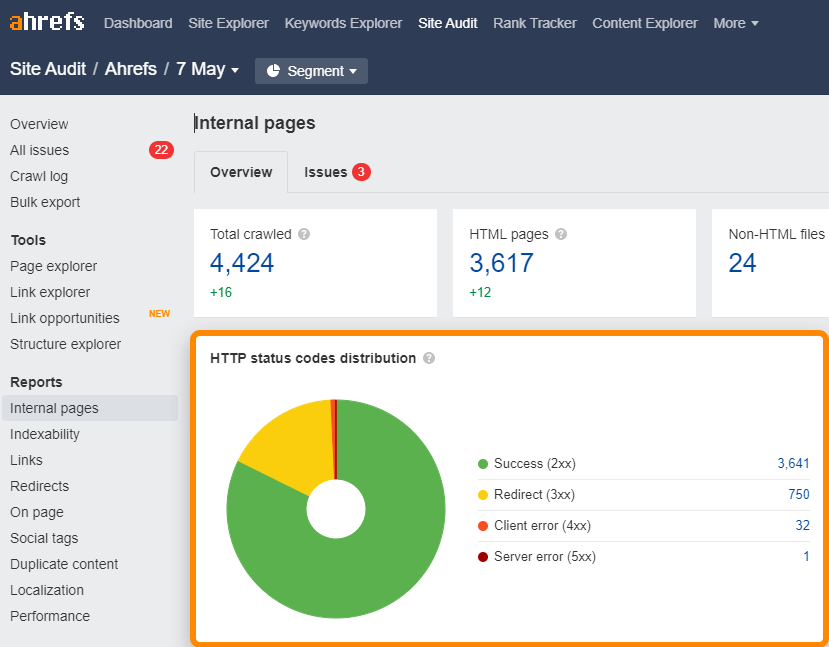
你可以在 Site Audit 的 Internal pages 报告中轻松找到网站上的重定向(3xx)链接。
对于站点地图中的重定向链接,请在 All issues 报告中查看「3XX redirect in sitemap」问题。
把资源托管在不同的主机名上
如果你使用不同的子域名或 CDN 来托管资源,这会把抓取预算的顾虑转移到托管资源的地方。这可以减轻你自己服务器资源的负担,并释放抓取预算。
尽可能用 GET 代替 POST
这一点稍微更偏技术,涉及 HTTP 请求方法。在 GET 请求可行的地方不要使用 POST 请求。本质上就是 GET(拉取)与 POST(推送)的区别。POST 请求不会被缓存,因此确实会影响抓取预算,而 GET 请求可以被缓存。
使用索引 API
如果你需要页面被抓取得更快,看看你是否符合使用 Google Indexing API 的条件。目前它只适用于少数用例,比如招聘信息或直播视频。
Bing 也有一个面向所有人开放的索引 API。
304(Not Modified,未修改)
Googlebot 并不总是发送 If-Modified-Since 或 If-None-Match HTTP 请求头。如果它们确实发送了,而你的服务器返回一个无正文内容的 304(Not Modified)响应,那么 Google 会复用它上次抓取的内容。这会稍微减少服务器资源消耗,意味着 Google 可能能够更多地抓取你的网站。然而,这是一个技术上很复杂的配置,感觉并不值得。与其尝试这种做法,你很可能不如把精力放在缓存配置上。
可能有效的方法
这一点是否有助于你的抓取预算有点不确定。
- Nofollow。过去nofollow 链接不会占用抓取预算。但现在 nofollow 被视为一种提示,因此 Google 可能会选择抓取这些链接。它们也可能在网络上其他页面中把这些链接当作 dofollow 链接发现。
无效的方法
有几件事人们有时会尝试,但实际上并不会有助于你的抓取预算。
- 对网站做小改动。在页面上做一些小改动,比如更新日期、空格或标点,希望页面被抓取得更频繁。Google 很擅长判断变化是否重大,所以这些小改动不太可能对抓取产生任何影响。
- Noindex。Google 仍必须抓取页面才能看到 noindex 标签。除非你本来就已达到网站的抓取上限,否则 Google 不会把抓取预算重新分配给其他页面。
- robots.txt 中的 Crawl-delay 指令。该指令会减慢许多爬虫。但 Googlebot 不使用它,所以不会有影响。在 Ahrefs,我们确实会遵守它,所以如果你需要减慢我们的抓取,可以在你的 robots.txt 文件中添加 crawl delay。
- 移除第三方脚本。第三方脚本不会占用你的抓取预算,所以移除它们不会有帮助。
我希望 Google 抓取得更慢
让 Google 抓取得更慢的好办法只有几个。从技术上讲,你还可以做其他一些调整,比如拖慢你的网站,但这些不是我推荐的方法。
调整缓慢,但有保证(已弃用)
Google 给我们用来放慢抓取的主要控制手段是 Google Search Console 中的速率限制器(rate limiter),但它现在已被弃用。过去你可以用这个工具放慢抓取速率,但最多需要两天才能生效。
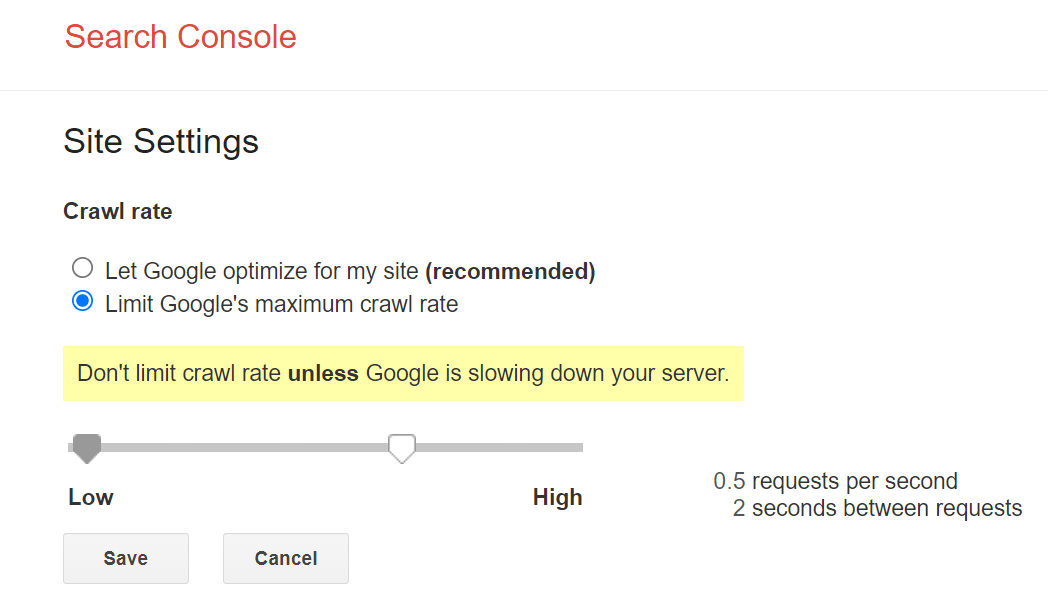
调整迅速,但有风险
如果你需要更立即的解决方案,可以利用 Google 与网站健康状况相关的抓取速率调整。如果你对页面上的 Googlebot 返回「503 Service Unavailable」或「429 Too Many Requests」状态码,它们就会开始放慢抓取,或可能暂时停止抓取。不过,你不希望这么做超过几天,否则它们可能会开始把页面从索引中移除。有时对网站进行重大改动也会促使 Google 抓取得更快。改动伴随风险,所以如果你唯一的目的只是想让 Google 重新抓取某些页面,我通常不推荐这么做。
结语
抓取速率不会影响你的排名。我想再次强调,抓取预算不是大多数人需要担心的事情。如果你确实有顾虑,希望这篇指南对你有用。
我通常只在以下情况才会去研究它:当页面无法被抓取和索引时,当我需要解释为什么某人不必为此担心时,或者当我恰好在 Google Search Console 的抓取统计信息报告中看到让我担心的东西时。
有疑问?在 Twitter 上告诉我。